Python数据重采样实战:使用SMOTE解决类不平衡问题
数据重采样是处理机器学习类不平衡问题的关键技术。通过调整数据集样本分布,可防止模型偏向多数类。本文将详解SMOTE等核心原理,并提供基于Python imblearn库的操作代码,帮助开发者快速构建平衡数据集以提升模型训练效果。
2026-10-11
6

数据重采样是处理机器学习类不平衡问题的关键技术。通过调整数据集样本分布,可防止模型偏向多数类。本文将详解SMOTE等核心原理,并提供基于Python imblearn库的操作代码,帮助开发者快速构建平衡数据集以提升模型训练效果。
本文详细演示如何使用纯Python从零构建N-gram文本生成管线。内容涵盖原始语料的标准化预处理、滑动窗口序列建模、基于上下文的随机拼接算法,以及引入Temperature参数优化输出多样性的完整代码。同时对比了传统N-gram模型的局限性,并给出向深度神经网络迁移的明确路径,适合自然语言处理初学者快速建立概率语言模型认知。
本文详细说明如何通过Python脚本读取包含图片URL的TXT文本,并提供三种实现路径:轻量级URL扩展、基于Pillow的基础几何与像素变换,以及调用imgaug的高级批量增强流程。内含完整可运行代码、依赖配置步骤、输出目录校验方法及版权合规提示,适用于计算机视觉模型训练前的样本扩充任务。
数据预处理是提升机器学习模型性能的关键环节。本文详细介绍基于Python与scikit-learn的核心预处理步骤,涵盖缺失值智能填充、异常值统计检测、分类变量独热与顺序编码,以及数值特征的标准化与归一化转换。结合可直接运行的代码示例,提供从原始数据到模型就绪数据的完整操作指引。
本文详细演示如何使用 Python 结合 scikit-learn 框架计算机器学习模型的特征权重。文章涵盖线性回归与逻辑回归的权重提取流程,讲解数据预处理、模型训练与 coef_ 属性可视化方法,并对比前向选择、过滤法与嵌入法等特征筛选策略,旨在协助开发者优化特征工程并增强模型业务可解释性。
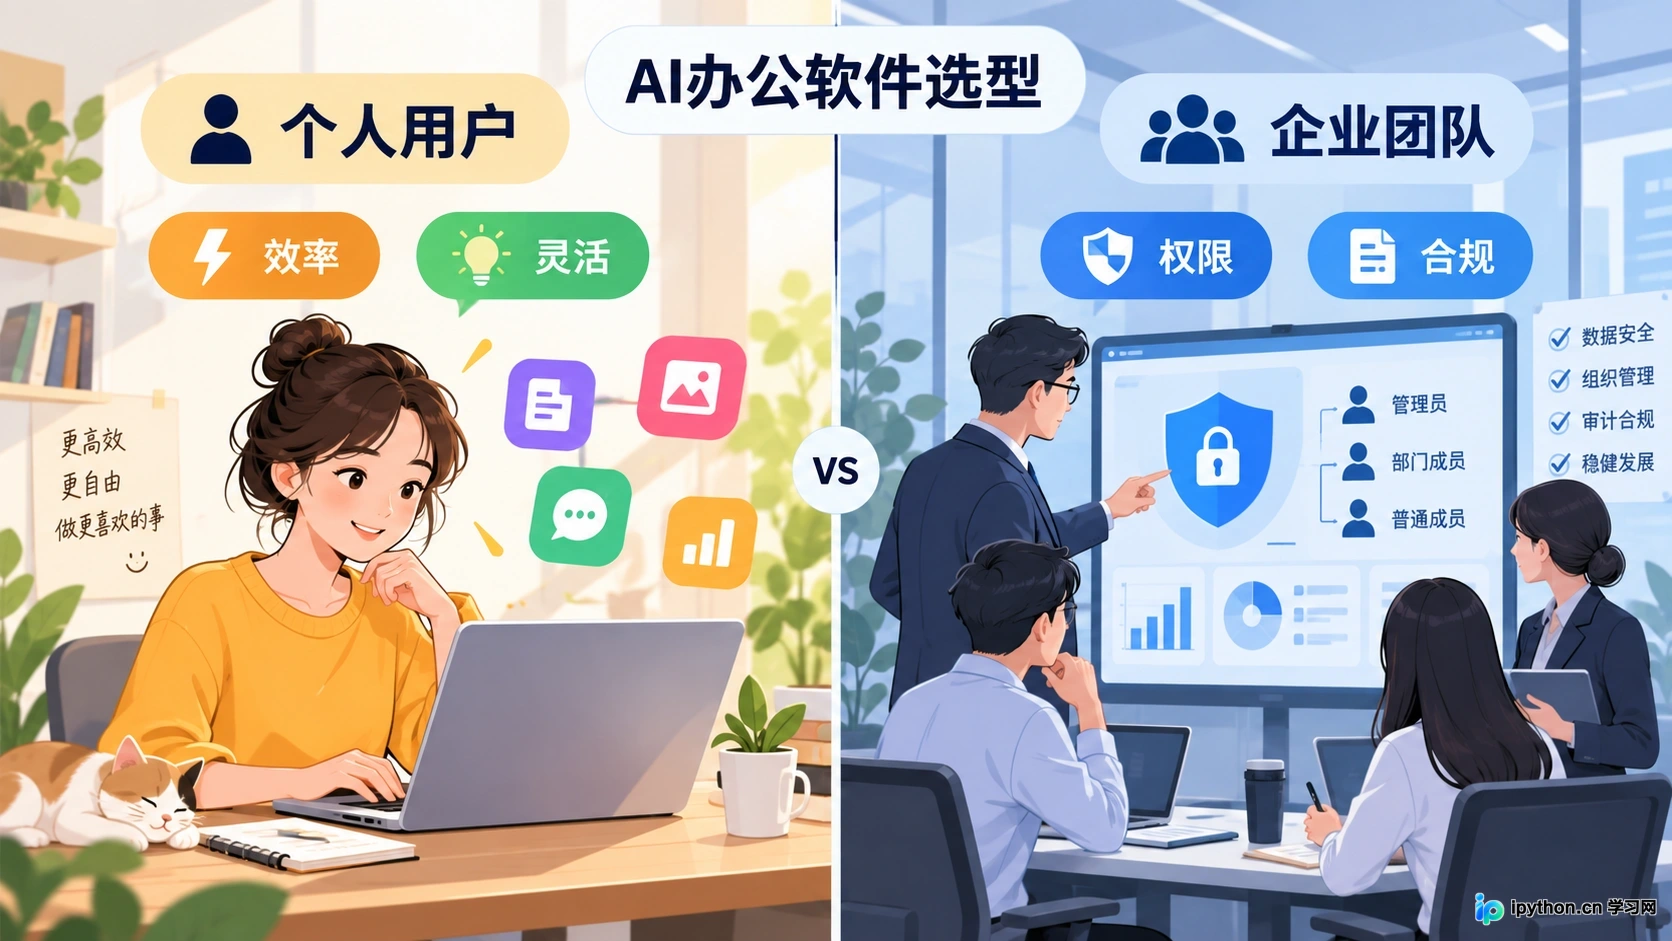
从账号管理、数据隐私及协作权限角度,对比个人版与团队版AI办公工具的差异。指导用户根据部署场景选择合适软件,重点解析SSO单点登录、数据隔离及RBAC权限控制等关键安全设置,避免敏感信息泄露风险。
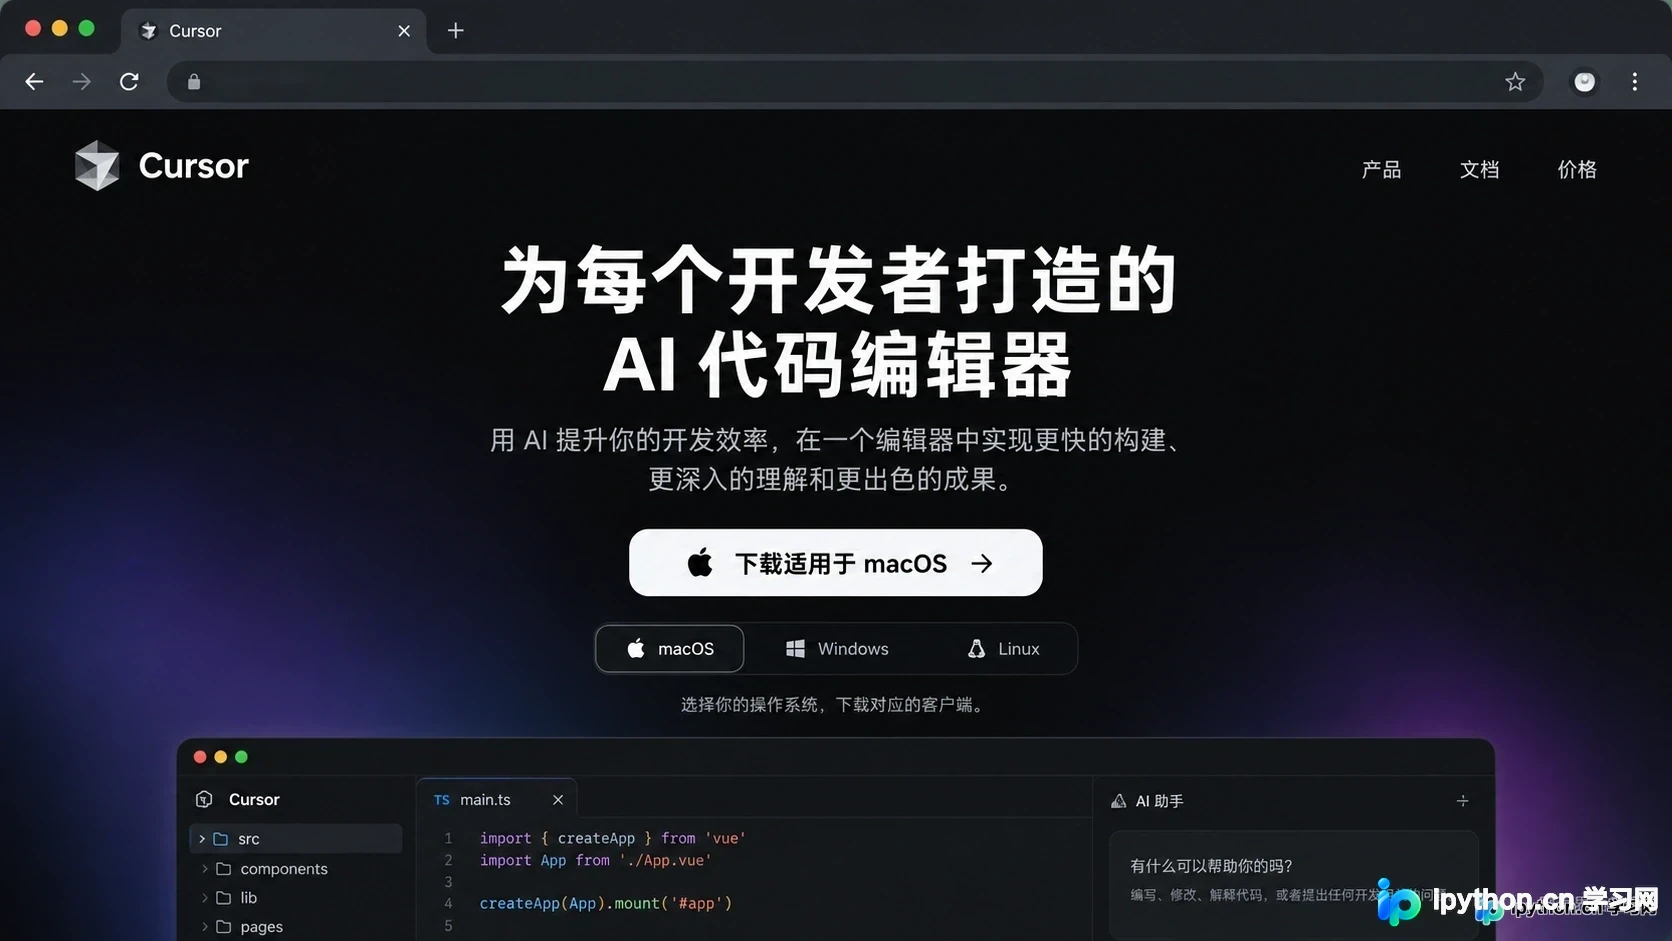
本文介绍如何获取Cursor官方安装包,重点讲解从VS Code一键迁移插件、主题和快捷键的流程,以及首次启动时的AI模型选择与基础环境配置,帮助开发者快速上手。
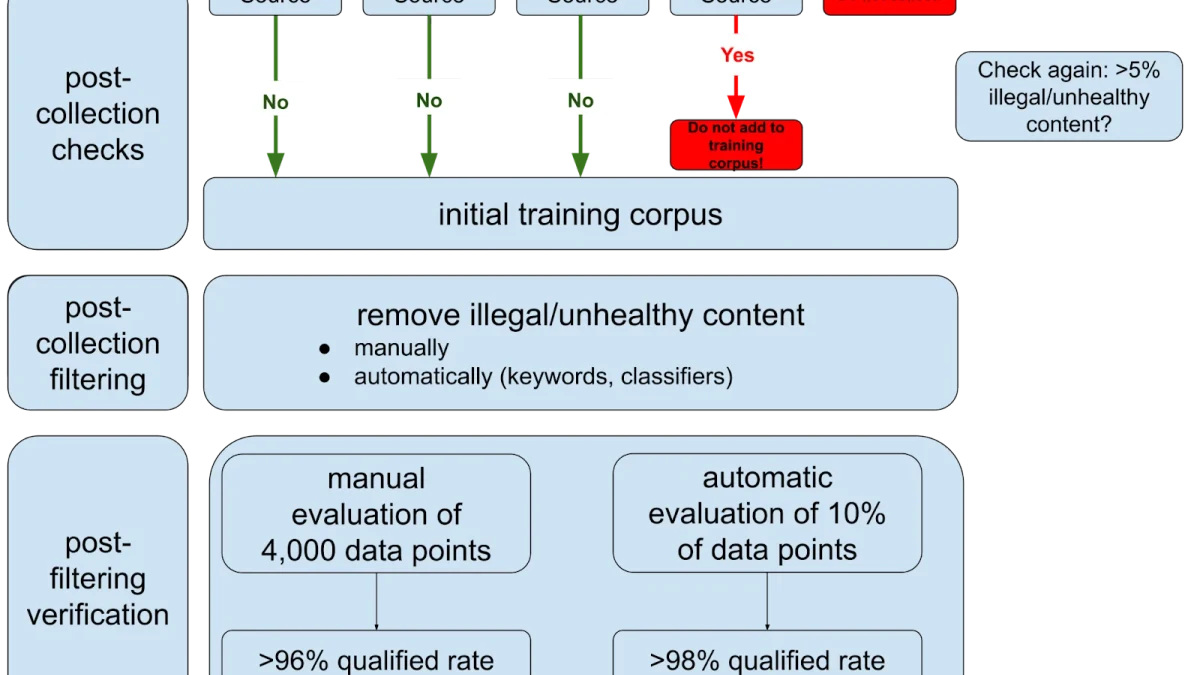
围绕现行国家标准 GB/T 45654-2025,从标准理解、数据与模型安全、服务侧防护、评估验证到常见合规误区,帮助生成式人工智能服务提供者建立可落地的安全与合规闭环。该标准已于2025年11月1日起实施。 全国标准信息公共服务平台 +1
围绕网站开发中的实际需求,对AI编程辅助工具进行分类、操作体验与效果验证,帮助读者快速判断哪些工具真正能提升开发效率,并避开代码质量、隐私、安全与过度依赖等常见问题。
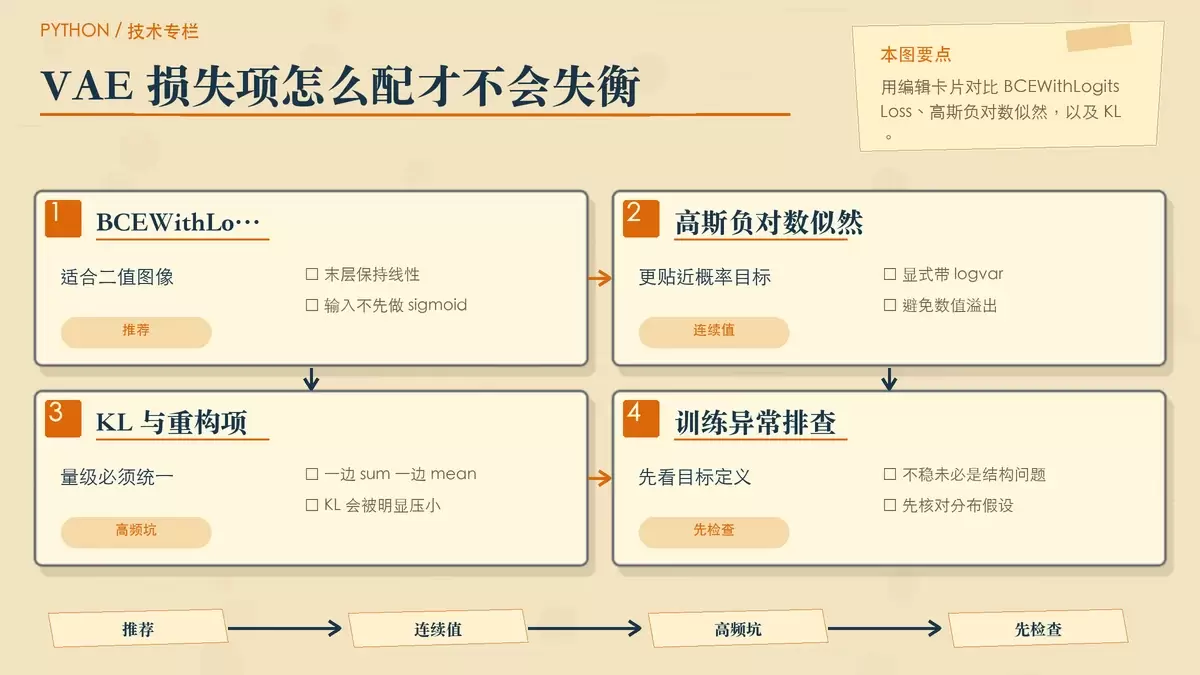
把 VAE 从能跑通训练,推进到可部署、可导出、可稳定加载,问题往往集中在四处:重构损失定义、重参数化阶段的梯度处理、ONNX 兼容接口设计,以及 checkpoint 的生产化加载。本文按这条链路梳理 PyTorch 中最容易踩坑的实现细节,并给出可直接落地的判断标准。
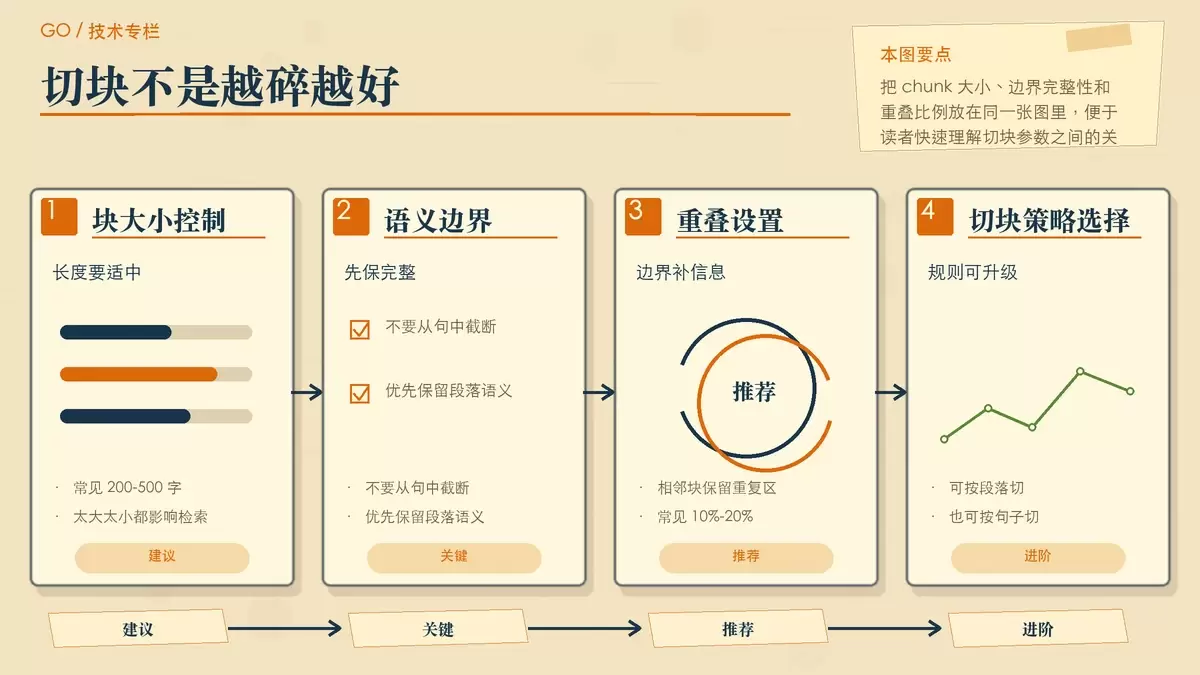
这篇文章用 Go 把 RAG 的核心链路拆成三步:文档切块、Embedding 向量化和相似度检索。你可以直接看懂最小实现,也能据此判断 chunk 大小、重叠比例、Top-K、向量库选型这些参数该怎么取。 想让大模型真正读懂企业知识库,关键不在于把文档一股脑塞进提示词,而在于先把内容拆成可检索的片段,再按问题取回最相关的上。