

13个Pandas高效数据处理技巧:从缺失值到内存优化
本文整理了13个Pandas高频使用技巧,涵盖计算变量缺失率、获取分组最大值行、多列合并、特定字符串行删除、组内排序、类型筛选、字符串转数值、内存占用优化、最大类别筛选、字符串分割、列表转DataFrame、多函数聚合及字典分组等场景,帮助开发者提升数据处理效率。
2026-10-14
6

本文整理了13个Pandas高频使用技巧,涵盖计算变量缺失率、获取分组最大值行、多列合并、特定字符串行删除、组内排序、类型筛选、字符串转数值、内存占用优化、最大类别筛选、字符串分割、列表转DataFrame、多函数聚合及字典分组等场景,帮助开发者提升数据处理效率。
本文深入探讨Python中通过__slots__实现内存优化的原理。文章从类与实例的__dict__差异入手,解释__slots__如何限制属性数量以节省内存。通过代码示例展示__slots__对实例属性的只读控制、赋值行为及与类属性的交互关系,帮助开发者掌握高效管理Python对象内存的方法。
本文深入解析Python字符串驻留机制,探讨其通过interned字典实现内存共享的原理。详细列举了自动驻留的时机,包括短字符串、编译时优化及特定字符规则。同时分析了驻留在提升比较效率(O(1))与增加创建开销之间的权衡,帮助开发者理解如何利用该机制优化代码性能。
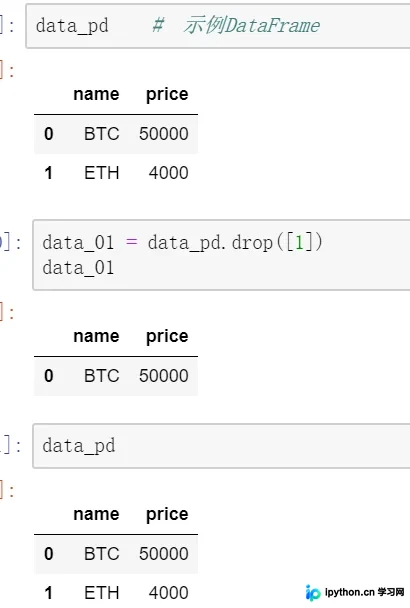
本文深入解析Python中Pandas库在处理数据结构时的内存复制机制。通过具体示例说明,当对DataFrame进行删除行等操作时,默认会在新的内存区域生成副本以保护原始数据。文章探讨了如何通过设置参数直接修改原数据,并引出Python中赋值与深浅复制的广泛概念,帮助开发者理解数据安全性与内存优化的平衡。
本文深入解析Python中生成器与迭代器的底层原理。生成器通过边循环边计算实现内存优化,适用于处理大规模数据;迭代器则通过实现__iter__和__next__协议支持遍历。文章详细对比了生成器表达式与函数的创建方式,并演示了自定义迭代器的具体代码实现,帮助开发者理解延迟计算与资源节约机制。
本文解析Python中__slots__魔法方法的原理。默认情况下,实例化对象会生成字典保存属性,导致内存浪费。通过定义__slots__,可禁止使用字典,仅分配固定集合属性的空间,从而节省内存并限制动态添加属性。
本文介绍在Python中处理包含大量数据的大文件时,如何避免全量加载导致内存溢出。通过分段读取与覆盖写入的策略,定位目标行后利用seek和truncate方法实现单行删除,确保低内存占用下完成文件修改操作。
本文详解如何使用Python结合Scapy模块解析Wireshark生成的PCAP文件。重点介绍Py2与Py3环境下scapy的安装差异,演示通过rdpcap读取数据包及提取IP、Raw负载等字段的方法。针对Python处理大量数据包时内存占用高的问题,建议结合tshark命令行进行预处理筛选,以优化处理效率。
本文深入解析 Python 3 中 Unicode 字符串的内部存储机制,包括 Latin-1、UCS-2 和 UCS-4 三种编码方式对内存占用的影响。通过 sys.getsizeof 和 cbytes 工具演示如何检测编码类型,并详细阐述字符串驻留(String Interning)技术及其在常量、短字符串中的应用场景,帮助开发者理解并优化 Python 程序中的内存使用效率。
本文深入解析Python3中zip()函数的核心机制,重点说明其作为迭代器仅能访问一次的内存优化特性,对比Python2的差异。详细演示单参数、多参数及矩阵场景下的用法,包括列表推导式实现矩阵加减点乘,以及利用*zip进行数据解包还原的方法,帮助开发者避免常见错误并高效处理多维数据。
本文介绍如何使用Python和numpy库读取文本文件并将其转换为矩阵。详细解析了字符串处理、类型转换及矩阵构造过程,并针对大规模数据场景提供了稀疏矩阵的替代方案与内存优化建议,帮助开发者避免MemoryError。
本文详解Python中numpy.median函数的用法,涵盖axis指定计算轴、out指定输出数组及keepdims保持维度等核心参数。重点解析overwrite_input=True的内存优化机制,通过代码示例展示如何在牺牲原数组数据的前提下节省内存,适用于大规模数据处理场景。