

R语言parallel包并行计算实战与内存优化指南
本文详解R语言中parallel包的并行计算方法,涵盖从单核lapply到parLapply的转换步骤。重点解析如何检测CPU核心数、初始化集群及释放资源,并针对常见的“连接错误”和内存溢出问题提供减少线程数、手动回收垃圾等有效缓解方案,帮助提升模拟运算效率。
2026-10-16
12

本文详解R语言中parallel包的并行计算方法,涵盖从单核lapply到parLapply的转换步骤。重点解析如何检测CPU核心数、初始化集群及释放资源,并针对常见的“连接错误”和内存溢出问题提供减少线程数、手动回收垃圾等有效缓解方案,帮助提升模拟运算效率。
本文深入解析Go标准库中bufio包的实现原理。通过剖析Writer和Reader的缓存机制,详细讲解在缓冲区满、有余量及数据超限三种情况下的写入策略,以及Read、Peek、ReadSlice和Scanner等核心方法的性能特征与适用场景,旨在帮助开发者规避并发覆盖风险并利用内存池实现高性能I/O处理。
本文详解Python中小整数对象池(范围[-5, 256])的预创建机制,以及大整数在不同执行环境(如终端与PyCharm)下的复用规则。通过代码示例解析is运算符在整数比较中的表现,帮助开发者理解Python的内存优化策略及潜在陷阱。
本文深入解析Python中文件读取的三种核心方法:read()、readlines()和readline()。重点对比它们在返回类型、内存占用及适用场景上的差异,特别是针对大文件读取时的内存优化策略。同时,结合fp.readlines()、str.strip()和str.split()等常用字符串处理函数,讲解从文件读取字符串到数值转换的完整流程,并解决常见的io.UnsupportedOperation错误。
本文详细介绍 Python 中 __slots__ 的用法。通过定义该特殊属性,可以限制类的实例只能分配指定的属性名称,防止意外添加动态属性。同时,它会替代默认的字典存储机制,改用更紧凑的数据结构,从而在批量创建大量对象时显著降低内存开销并提升运行效率。适合注重性能与资源控制的应用场景。
本文深入解析Go语言中结构与函数的关系,重点阐述值接收者与指针接收者在修改实例状态、性能影响及适用场景上的核心差异。通过代码示例说明为何修改字段需使用指针,并给出选择接收者类型的实用原则,帮助开发者编写更高效、规范的Go代码。
针对Python中json.load()处理大型JSON文件导致内存溢出或卡死的问题,本文提出一种基于逐行读取与括号计数法的预处理方案。通过统计花括号数量判断完整JSON对象边界,将数组元素逐个提取并转换为JSON字符串写入临时文件,从而避免一次性加载全部数据至内存,实现高效的大规模数据处理。
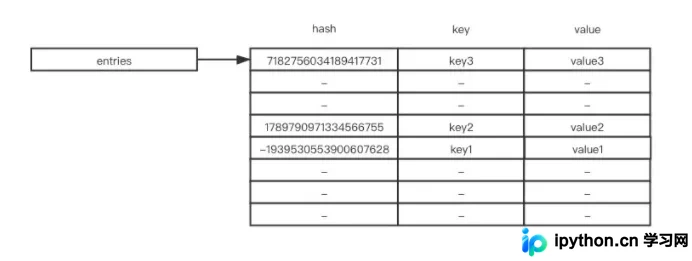
本文解析Python 3.6后字典保持插入顺序的底层原理。通过对比旧版哈希表与新版的indices与entries分离结构,说明如何通过紧凑存储提升内存利用率并保留插入顺序。文章涵盖数据结构变化、空间节省计算及源码学习资源,帮助开发者深入理解Python字典实现。
本文详细解析Python字符串驻留机制的适用范围,包括长度为0和1的字符串、符合标识符规范的字符串以及[-5, 256]范围内的整数。重点说明驻留仅在编译时生效,并深入剖析interned字典的工作原理及引用计数变化,帮助开发者理解Python内存优化策略。
本文针对Python使用openpyxl处理60MB以上Excel文件时遇到的写入报错及内存占用过高问题,提供了两种核心解决方案:手动释放内存与安装lxml依赖以启用流式处理。同时深入探讨了遍历大范围单元格导致的内存瓶颈,通过限制遍历范围至ZZ5000、切换X64环境及定时重新读取文件等策略,将内存占用控制在2G以内,实现了高效的数据对比与处理。

本文整理了13个Pandas高频使用技巧,涵盖计算变量缺失率、获取分组最大值行、多列合并、特定字符串行删除、组内排序、类型筛选、字符串转数值、内存占用优化、最大类别筛选、字符串分割、列表转DataFrame、多函数聚合及字典分组等场景,帮助开发者提升数据处理效率。
本文深入探讨Python中通过__slots__实现内存优化的原理。文章从类与实例的__dict__差异入手,解释__slots__如何限制属性数量以节省内存。通过代码示例展示__slots__对实例属性的只读控制、赋值行为及与类属性的交互关系,帮助开发者掌握高效管理Python对象内存的方法。