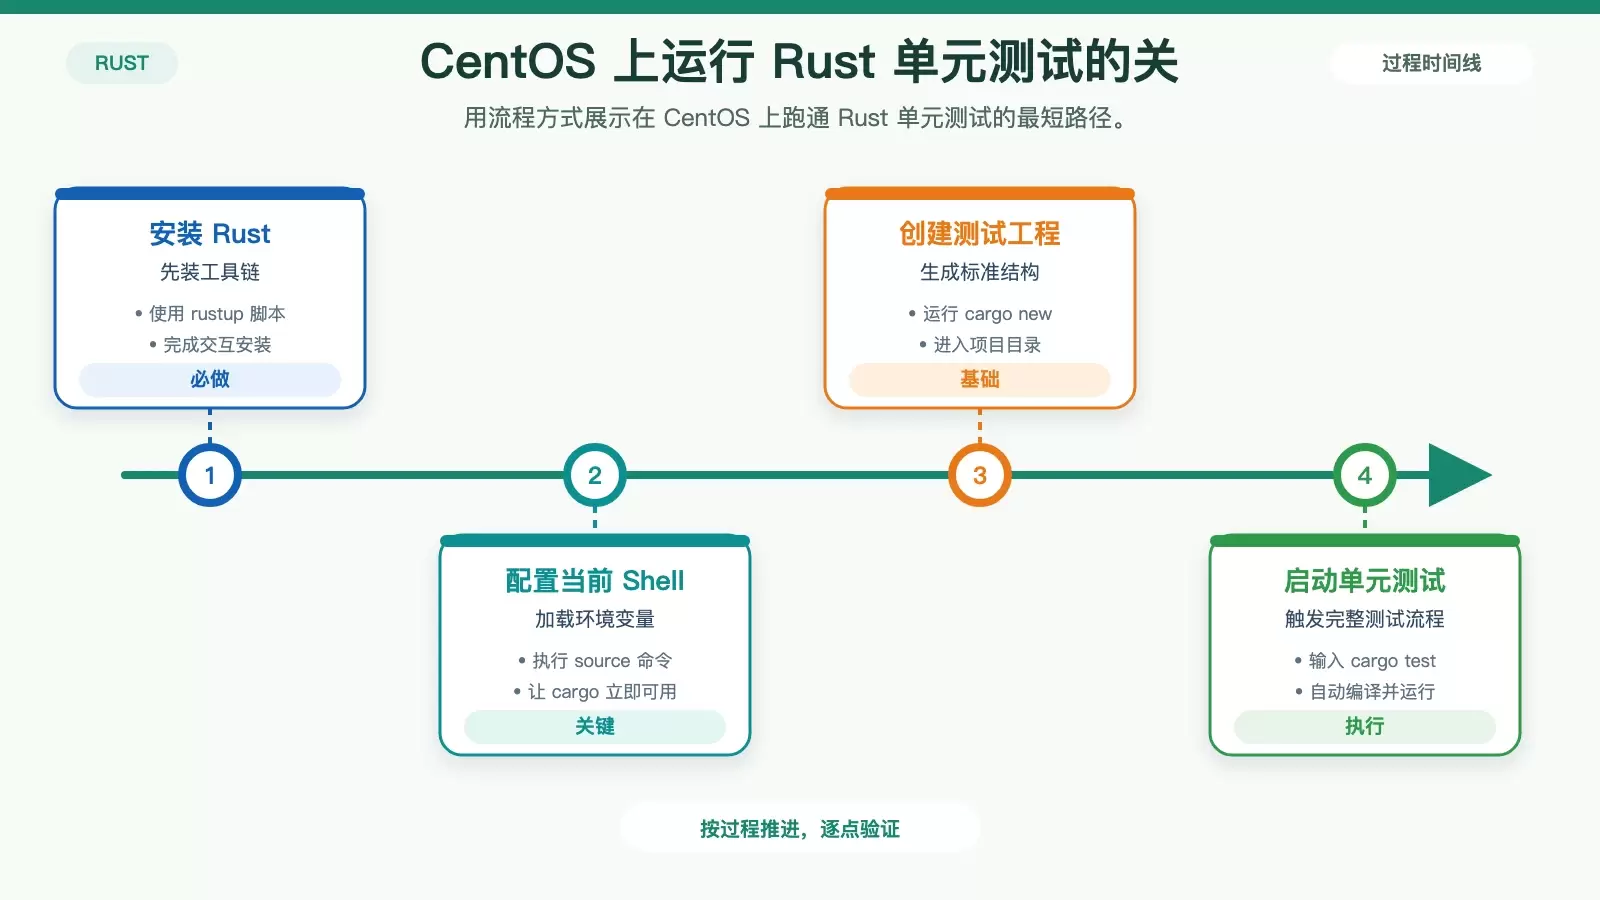
Rust 在 CentOS 上如何进行单元测试
这篇文章用一套最小可行流程,梳理了在 CentOS 上完成 Rust 单元测试的关键步骤:安装 Rust、加载 cargo 环境、创建项目、编写 `#[test]` 用例并通过 `cargo test` 执行。文中保留了命令、示例代码和测试输出,适合刚开始在 Linux 环境下搭建 Rust 开发与测试流程的读者快速上手。
2026-08-25
111

这篇文章用一套最小可行流程,梳理了在 CentOS 上完成 Rust 单元测试的关键步骤:安装 Rust、加载 cargo 环境、创建项目、编写 `#[test]` 用例并通过 `cargo test` 执行。文中保留了命令、示例代码和测试输出,适合刚开始在 Linux 环境下搭建 Rust 开发与测试流程的读者快速上手。
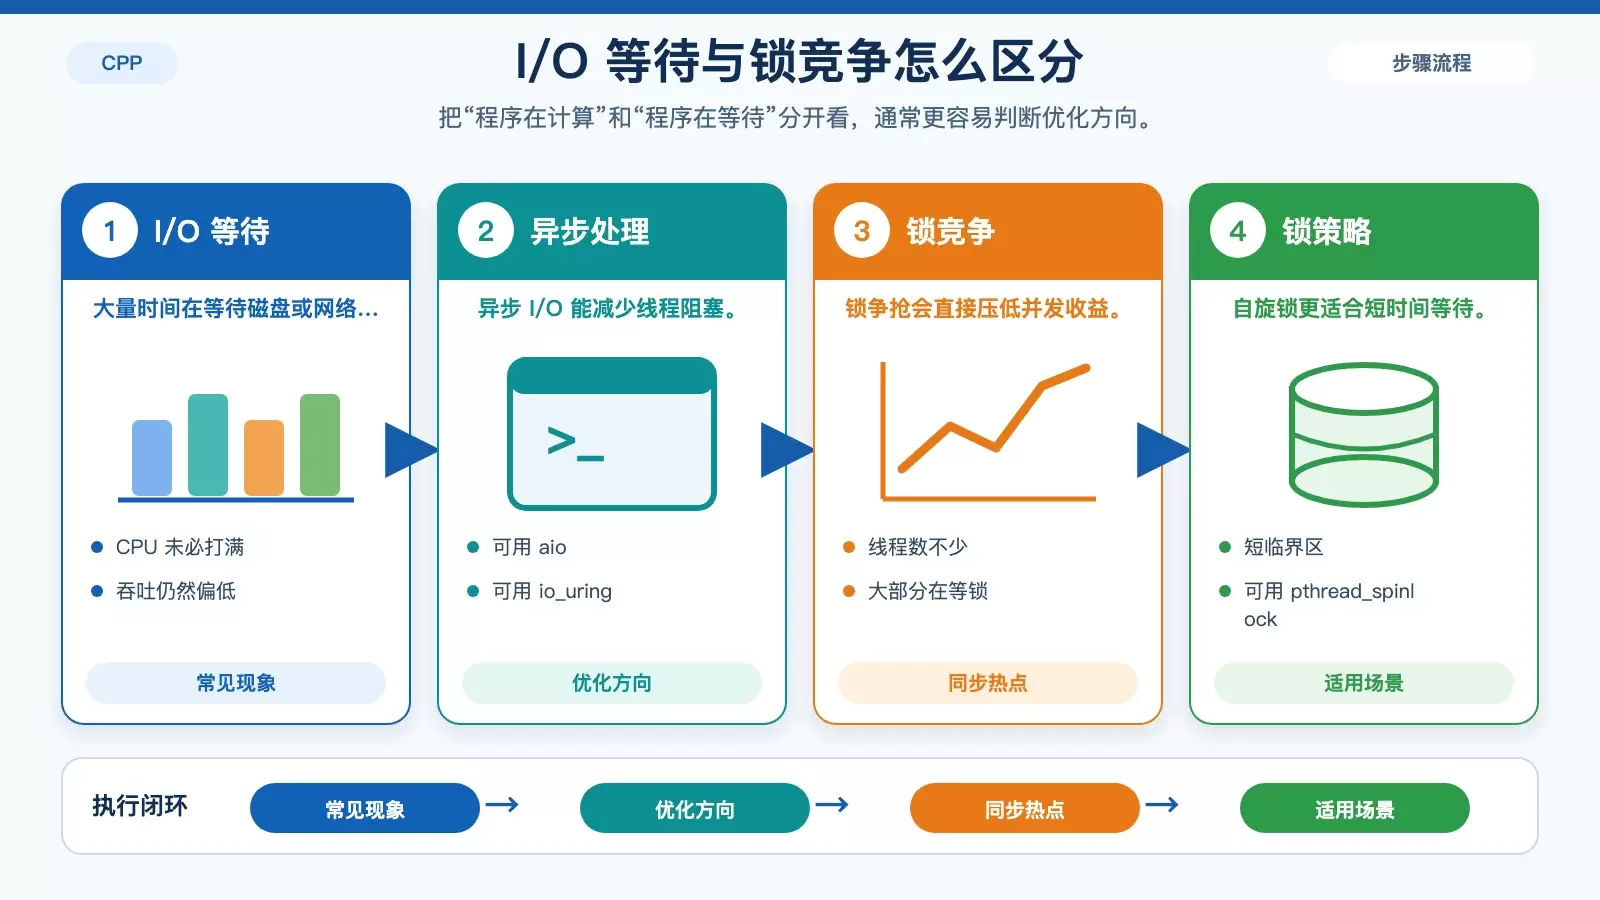
Linux 下的 C++ 程序变慢,通常不是单一原因,而是 CPU、内存、I/O、锁竞争、系统调用以及编译优化共同作用的结果。本文按常见瓶颈拆解现象与处理思路,并补上 perf、valgrind、iostat 等定位工具的使用场景,帮助你先判断问题落在哪一层,再决定该改代码、调参数还是换硬件。
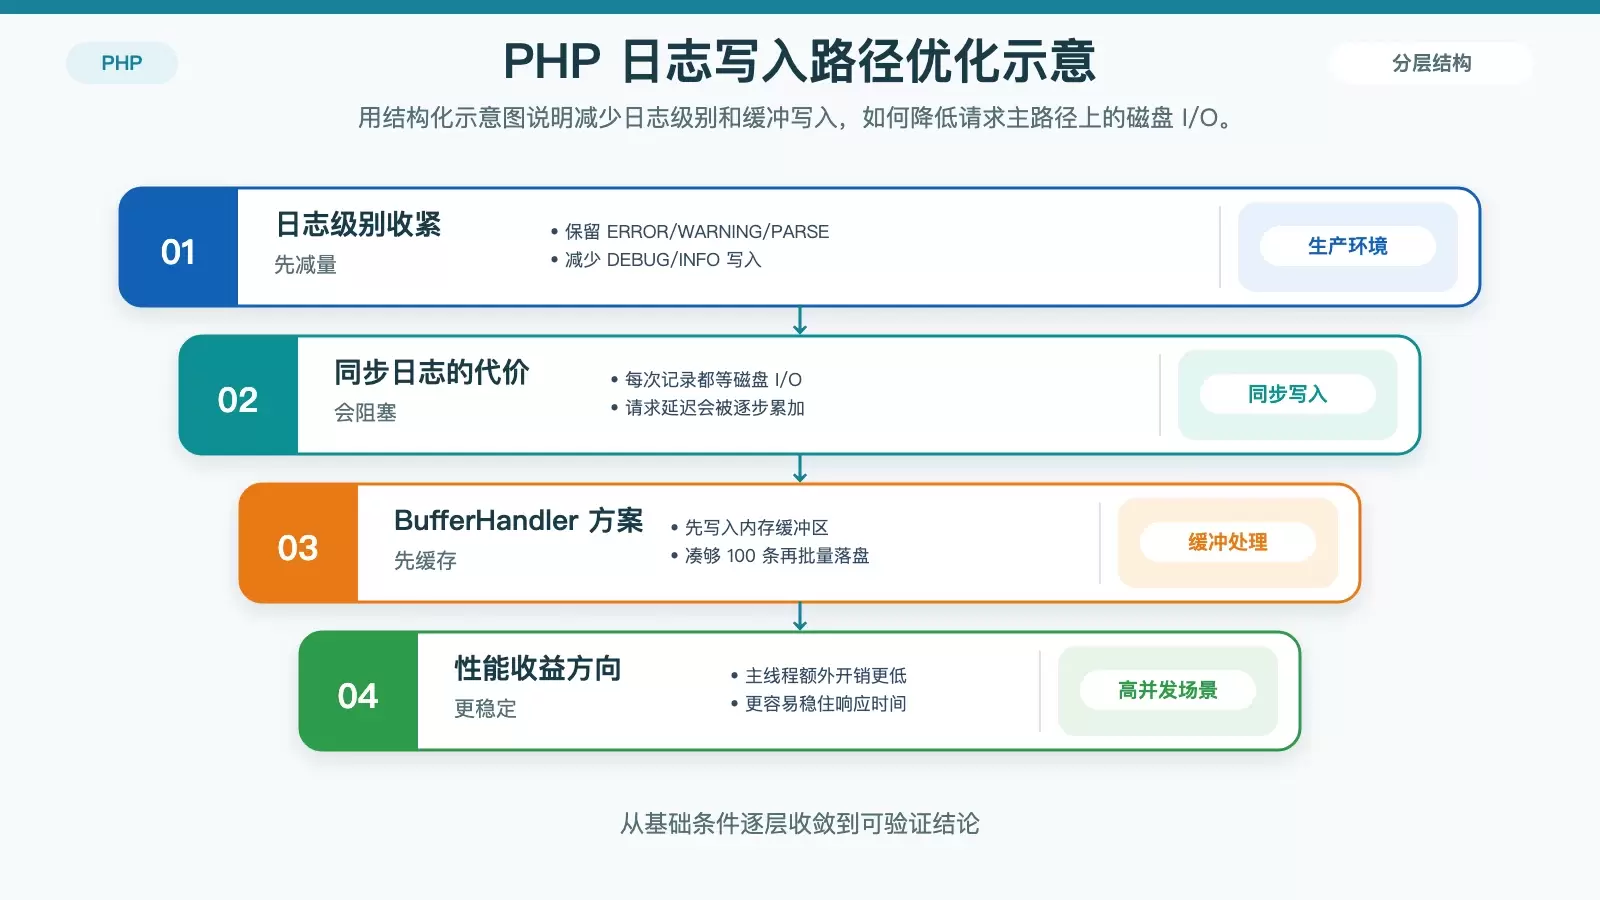
PHP 日志配置不只是排障工具,也会直接影响磁盘占用和 PHP-FPM 响应时间。本文围绕 CentOS 常见运行环境,整理出日志级别、异步写入、轮转、存储方式以及 PHP-FPM 配置几个关键优化点,并给出可直接落地的配置示例。
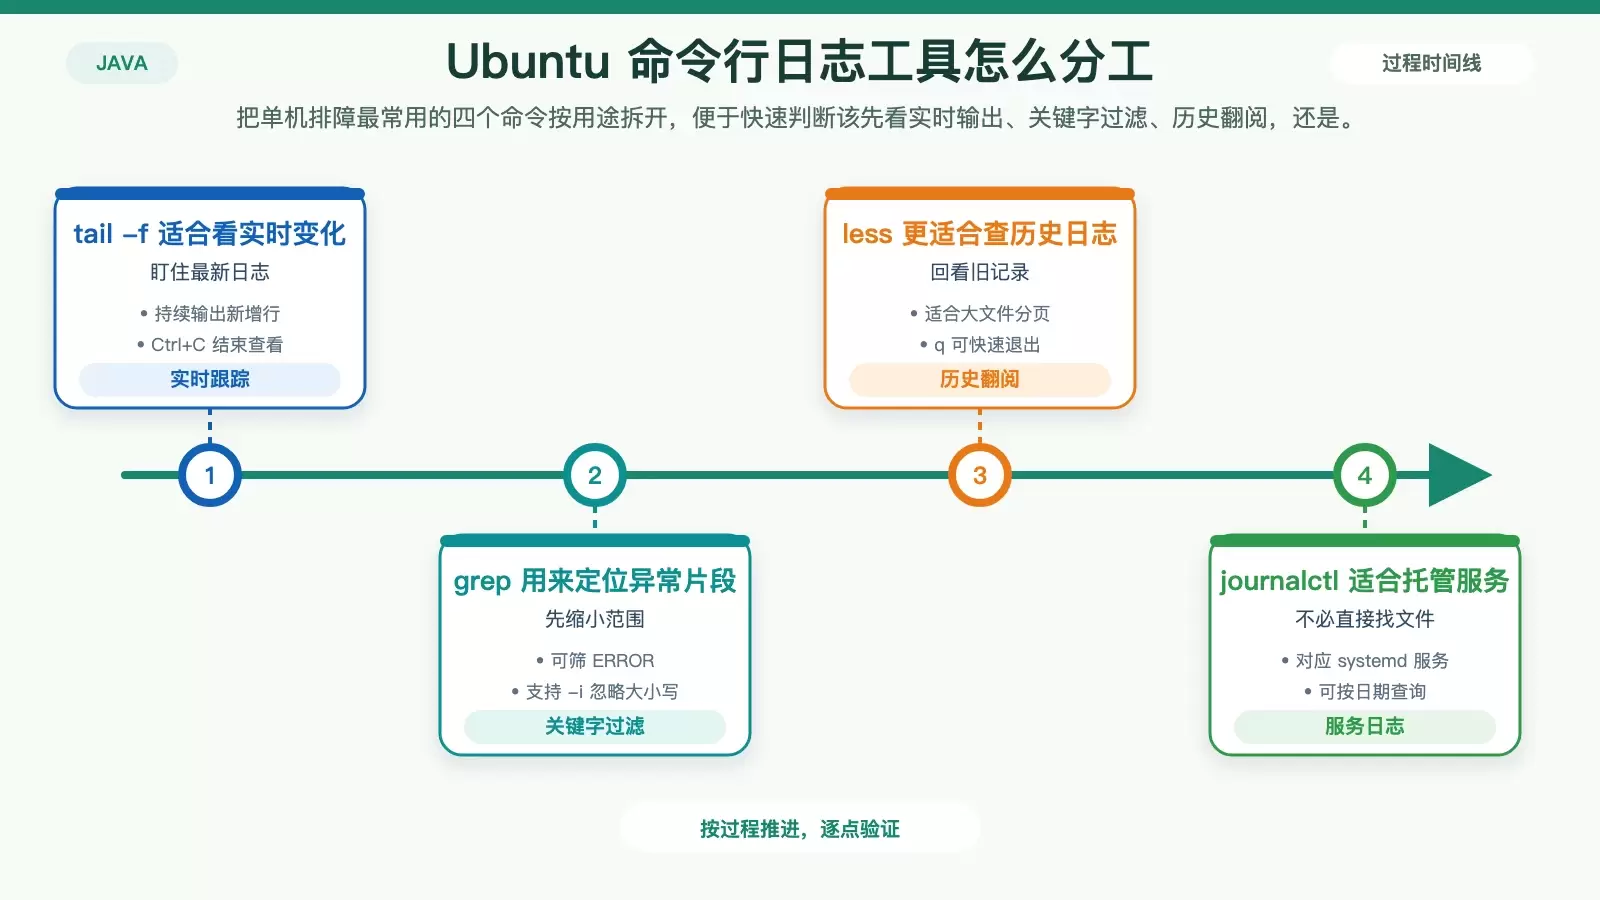
在 Ubuntu 上监控 Java 日志,常见做法可以分成四层:命令行排查、集中化日志平台、性能与异常监控、日志轮替。本文按使用场景梳理每种方案的适用边界、关键命令和配置要点,方便你根据应用规模与排障目标快速选型。
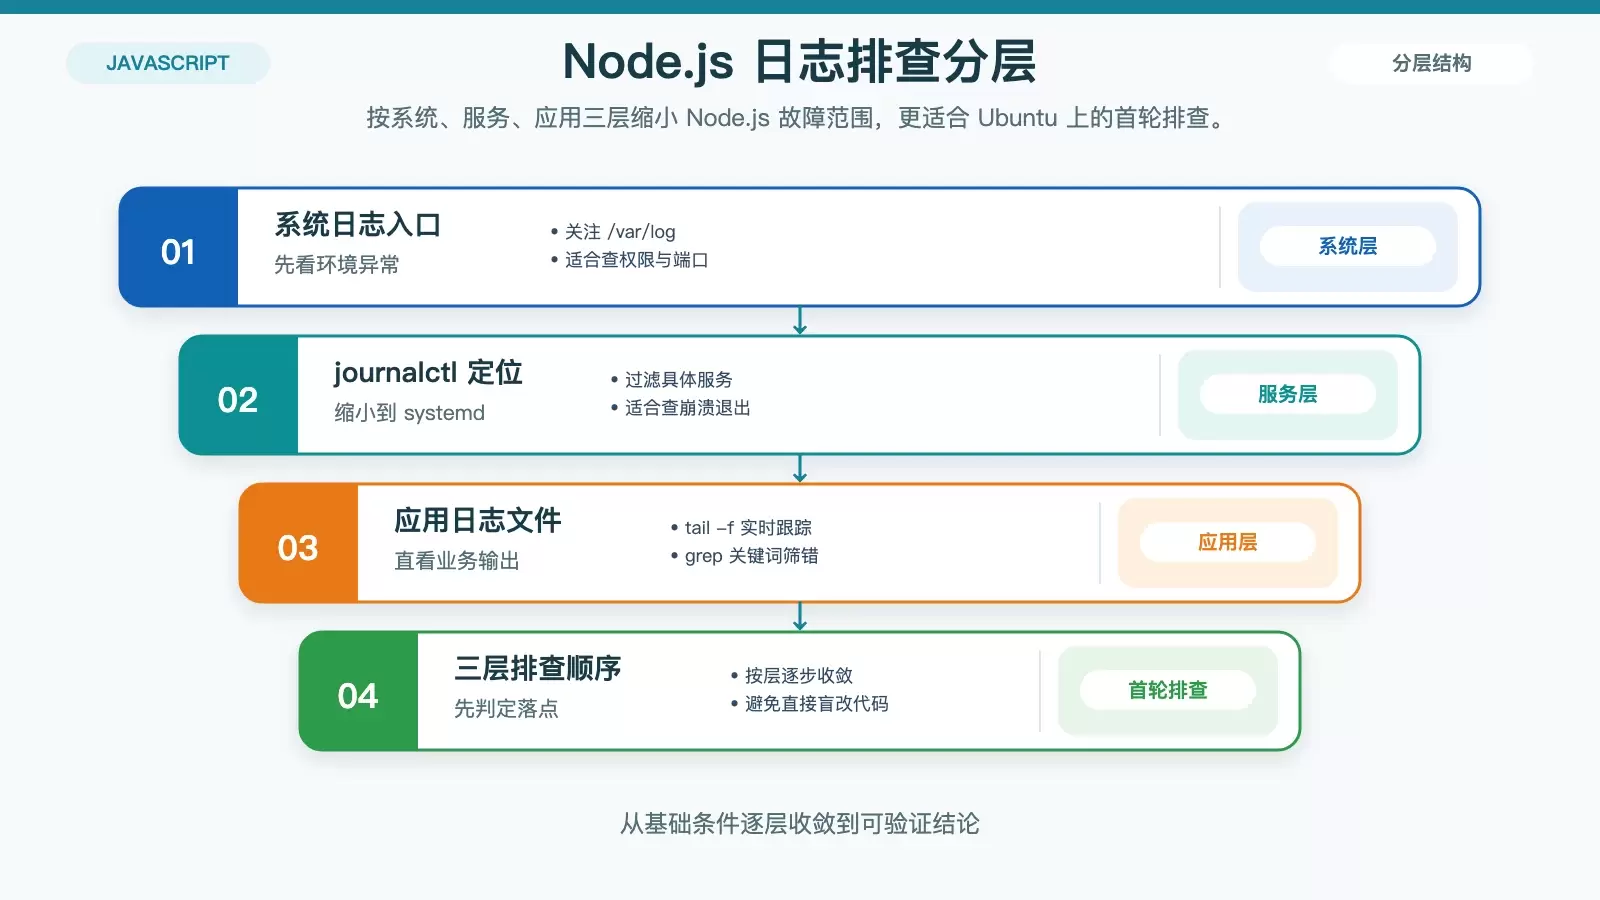
在 Ubuntu 上排查 Node.js 错误,关键不只是“看日志”,而是按系统、服务、应用和代码四层逐步收窄范围。本文整理了常用命令、PM2 与 Winston 的接入方式,以及端口占用、依赖缺失等典型故障的排查路径。 Node.js 服务在 Ubuntu 上出故障时,最怕的不是报错本身,而是日志分散、定位路径混乱,结果越查越慢。
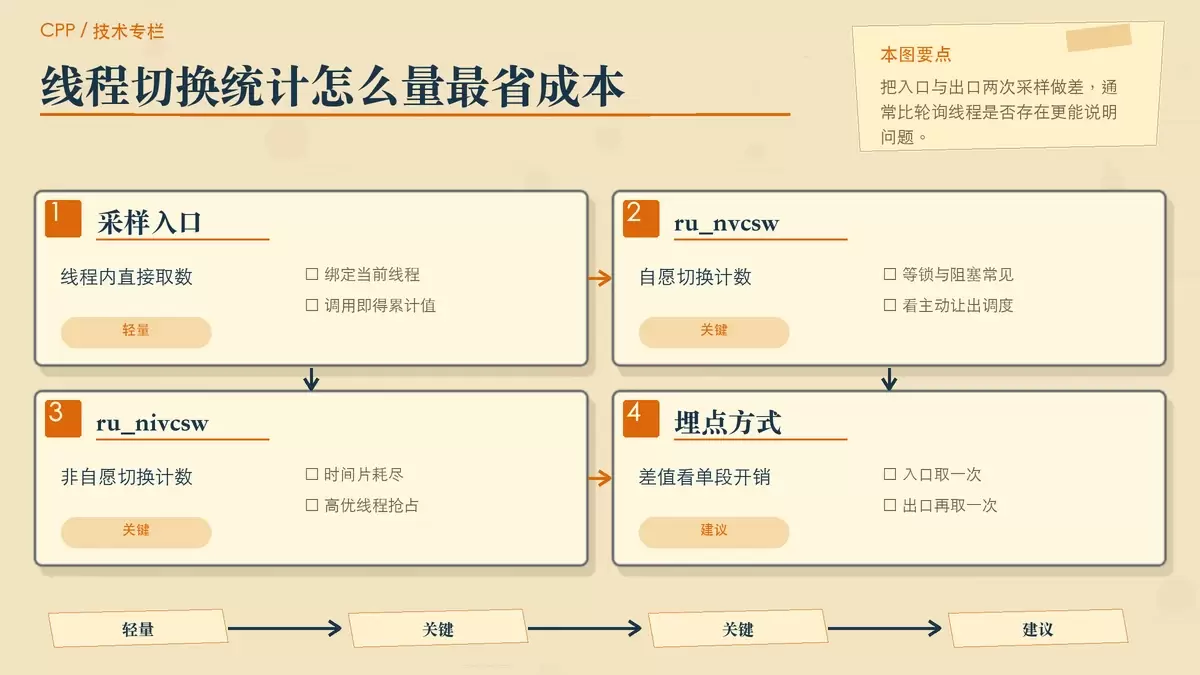
在 Linux 上看 C++ 线程“有没有在动”,关键不是轮询线程是否存在,而是抓住上下文切换这个更稳定的信号。本文把可用方案拆成快速统计、精准归因和常见误区三部分,说明什么时候该用 `getrusage(RUSAGE_THREAD, &ru)`,什么时候再上 `perf_event_open()`。
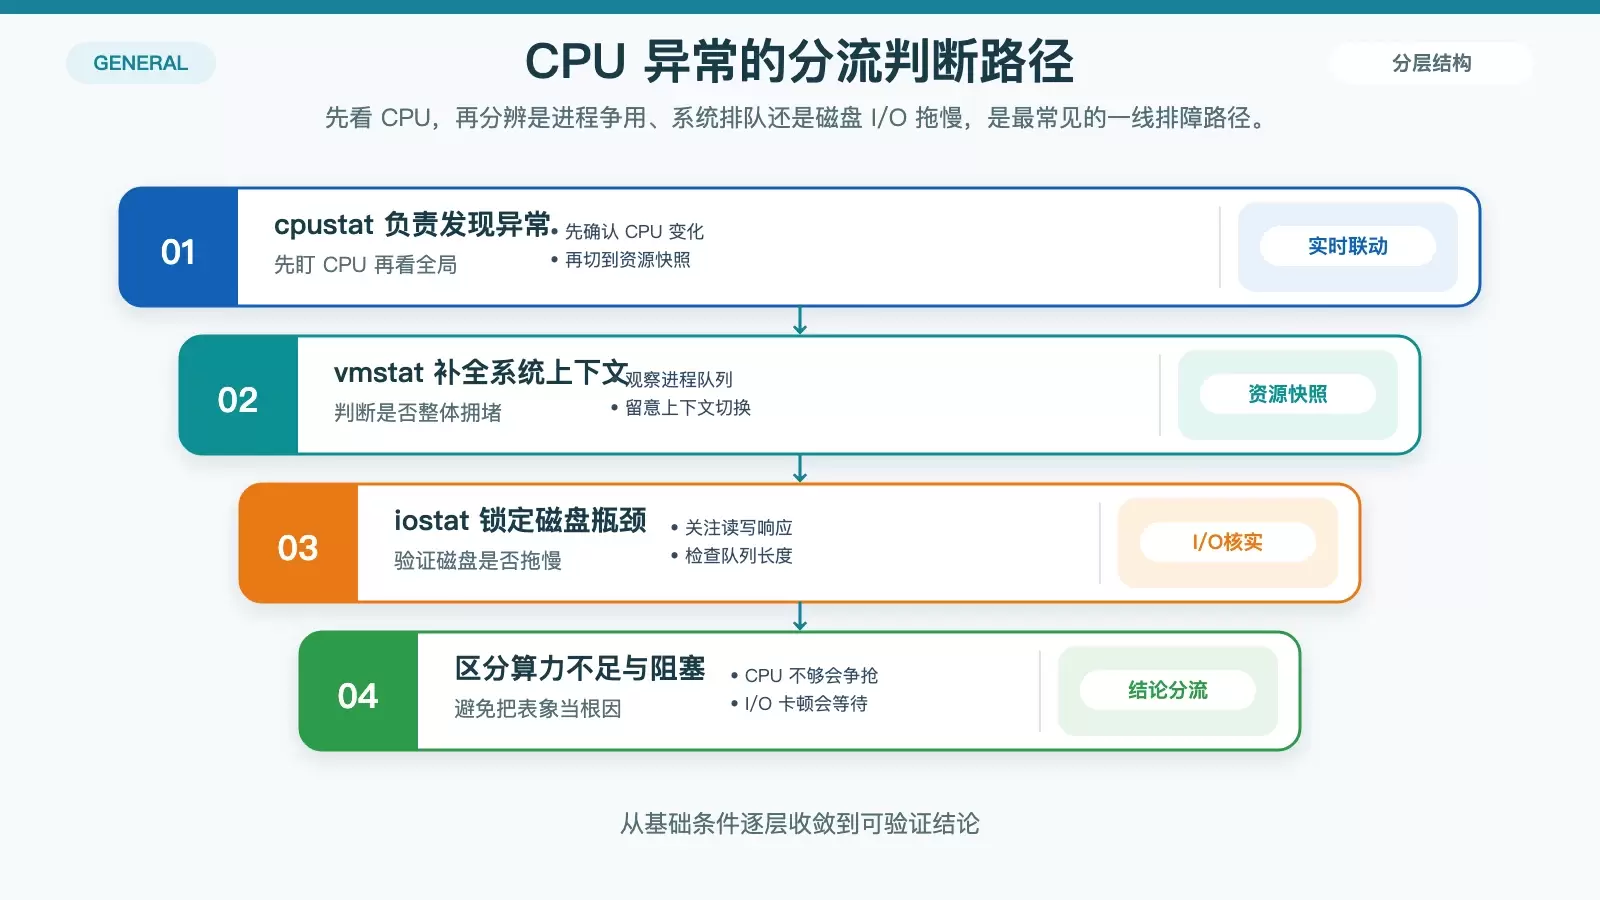
`cpustat` 适合盯住 CPU 变化,但单独使用很难解释性能波动背后的真正原因。把它和 `top`、`vmstat`、`iostat`、`sar`、`perf`、`dstat` 以及日志和脚本结合起来,才能从实时定位、历史回溯到自动采集形成完整的排障链路。 `cpustat` 能快速告诉你 CPU 有没有异常,但它很难单独解释性能问题究竟出在进程、内存调度、磁盘 I/O 还是更底层的调用热点。
Linux 上排查 C++ 多线程死锁时,`gcore` 可以在进程未崩溃的情况下抓取现场,但前提、命令写法和后续分析方法都有限制。本文按“能否抓、怎么抓、抓完怎么看、为什么看不清源码”四个问题展开,帮助你判断 `gcore` 何时可用、何时该换手段。
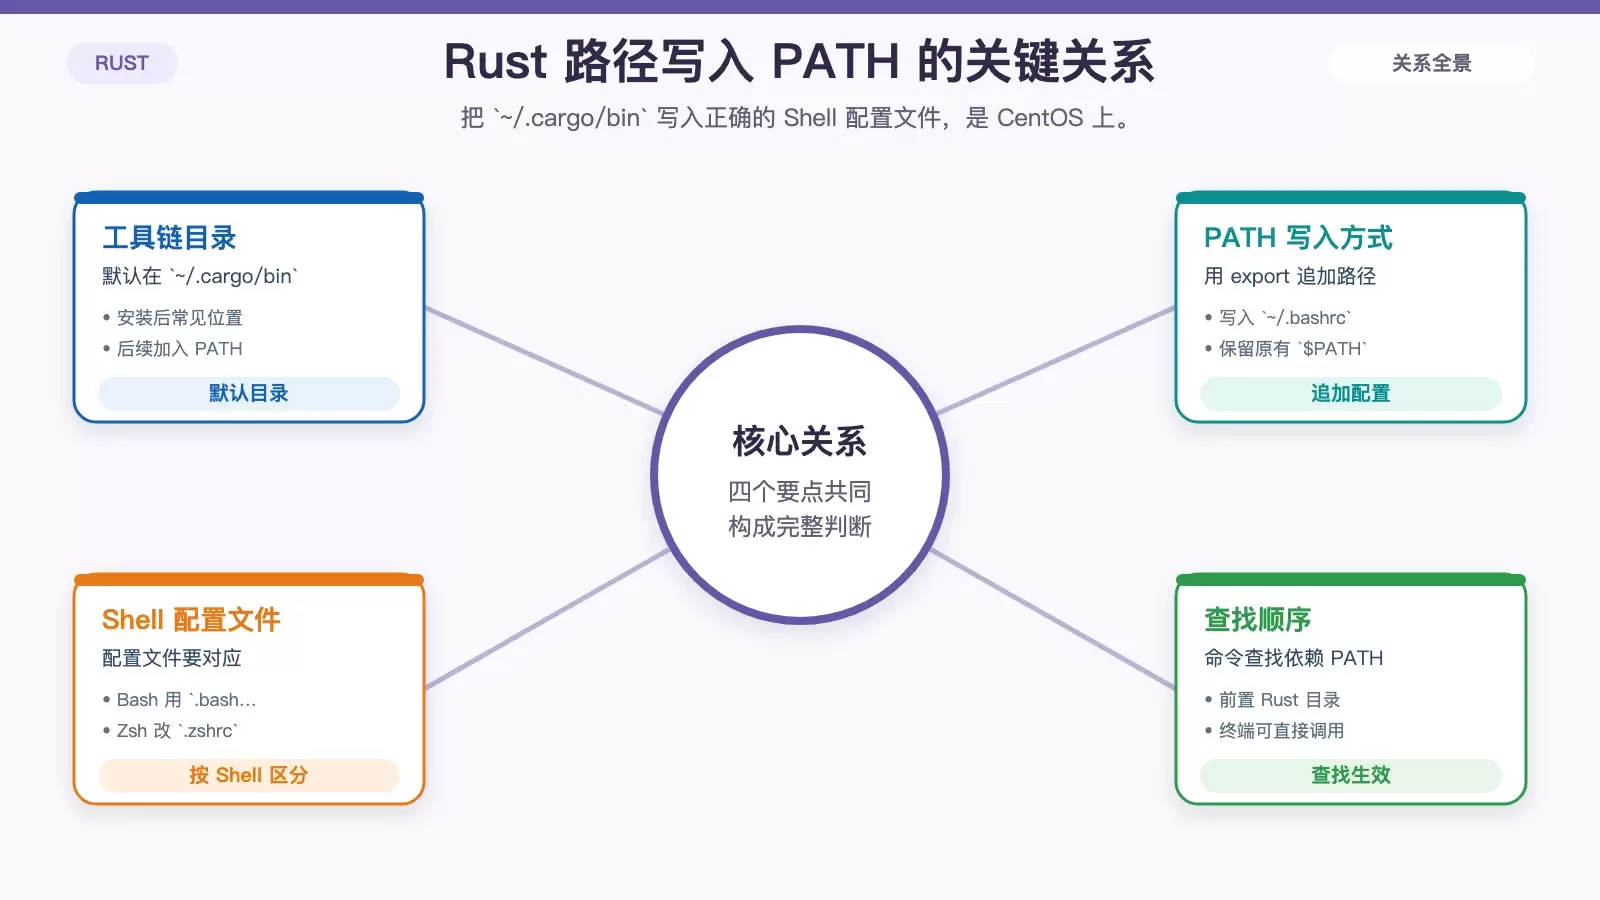
在 CentOS 上配置 Rust,关键不是安装命令本身,而是让系统能正确找到 `rustc` 和 `cargo`。这篇文章按“安装、写入 PATH、立即生效、验证排错”的顺序梳理操作,并补出不同 Shell 下该改哪个配置文件,方便快速判断环境是否已经配置完成。
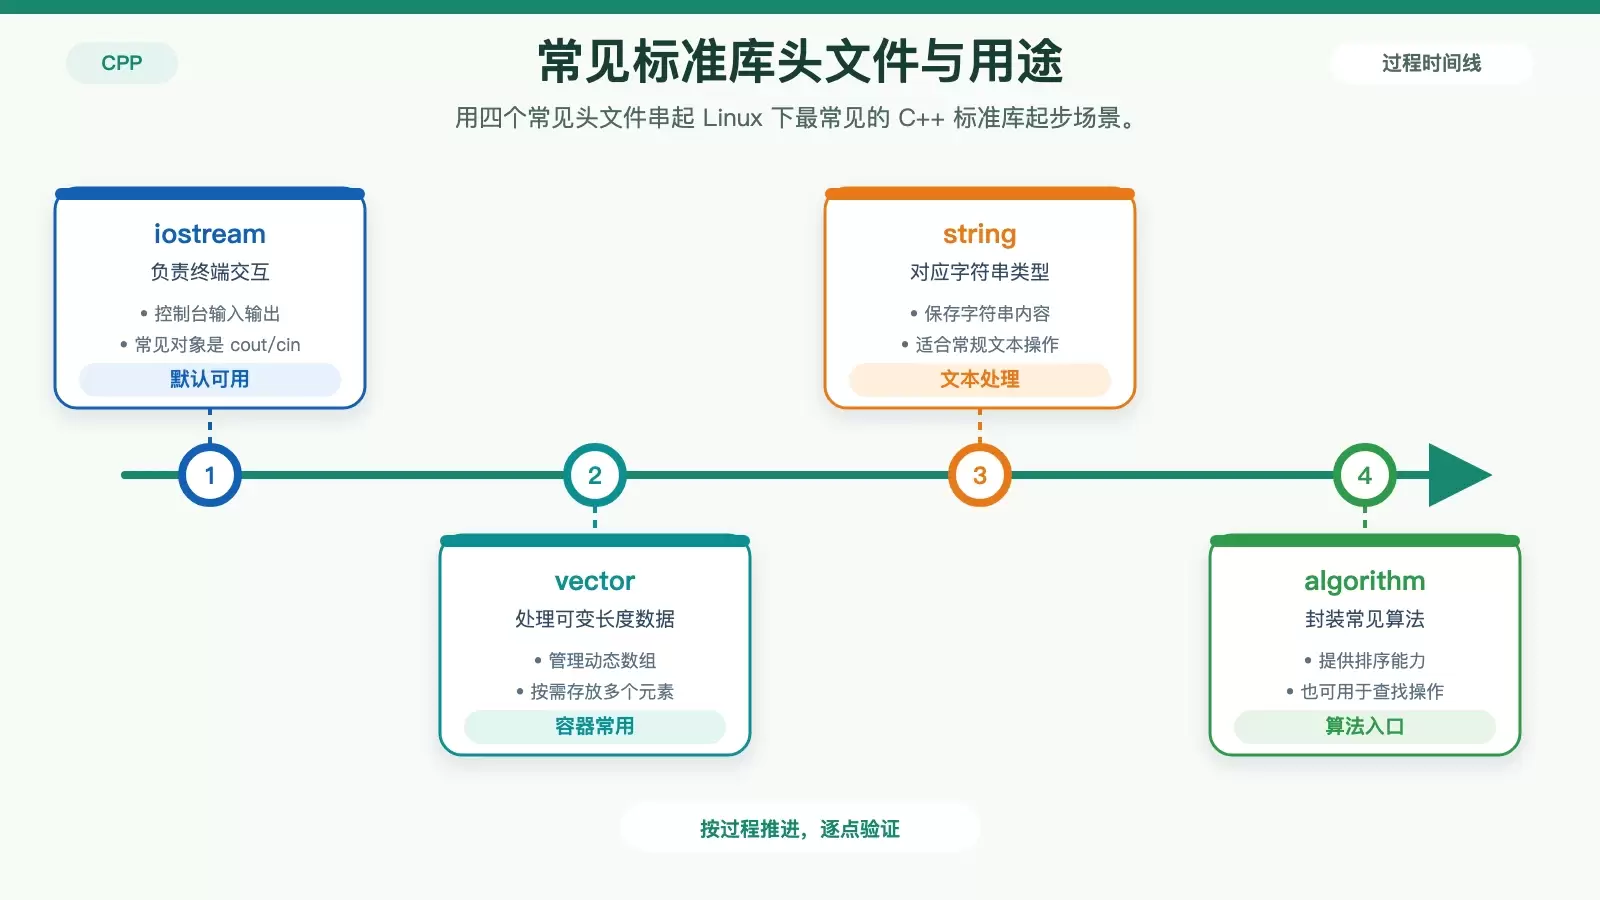
在 Linux 上使用 C++ 标准库,核心并不在“安装”,而在于正确包含头文件、按命名空间调用接口,再用 g++ 完成编译运行。本文用最基础的输入输出示例串起完整流程,同时补出常见标准库头文件的对应关系,方便刚开始写 C++ 的读者快速判断该引什么、怎么编译、运行后会得到什么结果。
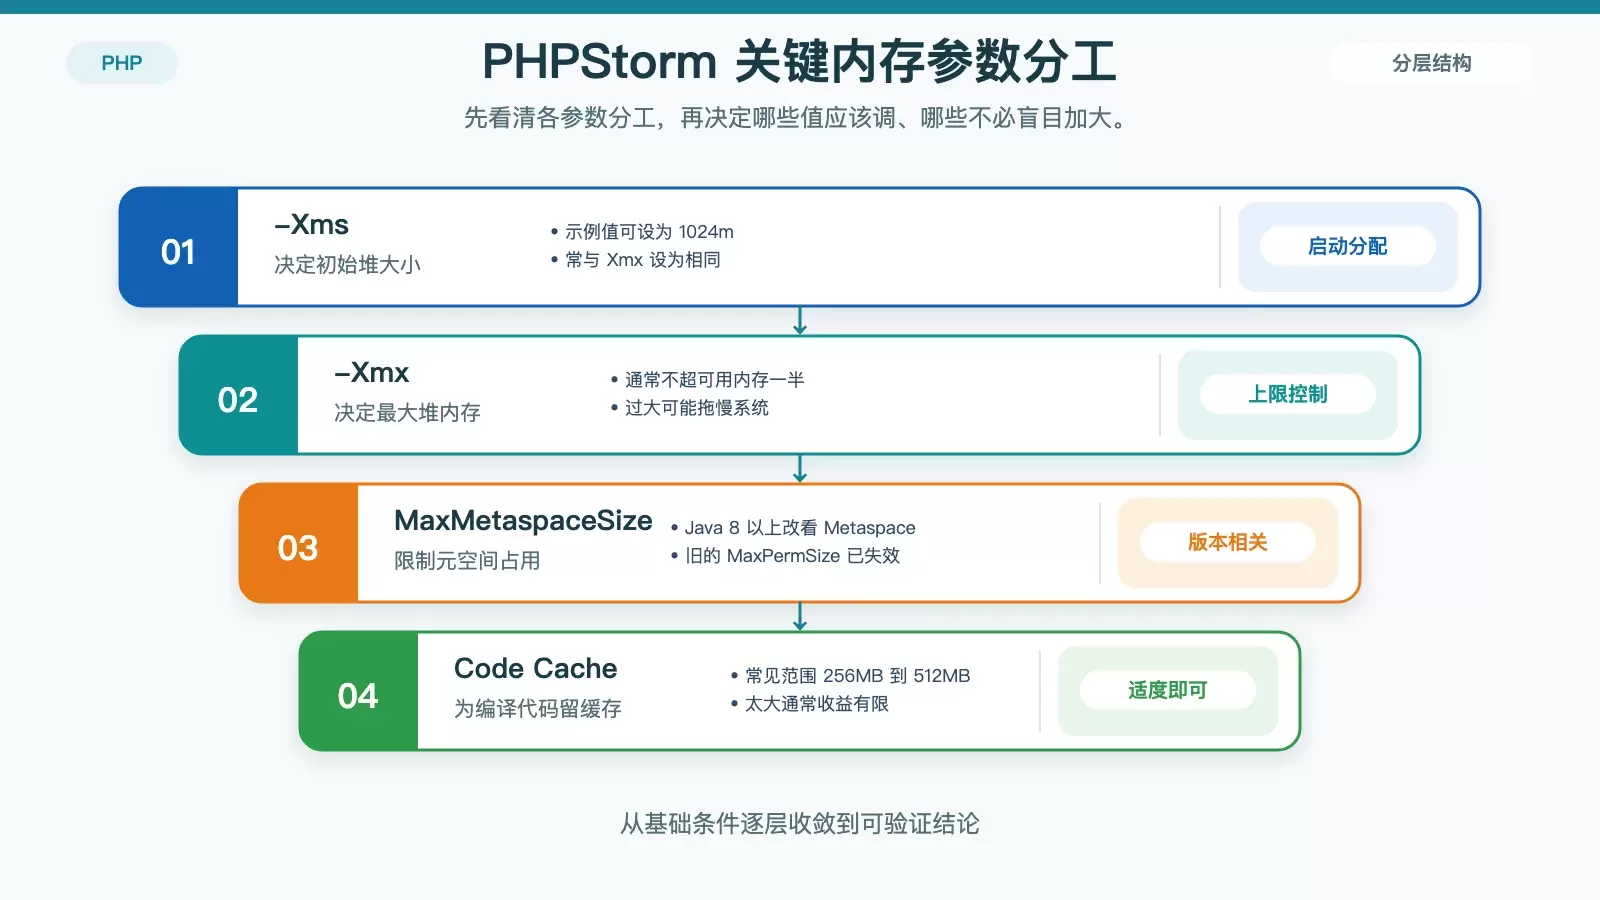
在 CentOS 上调整 PHPStorm 内存,关键不在“设得越大越好”,而是先看机器可用内存、再按 JVM 参数分配堆、元空间和代码缓存。本文结合 2GB 到 16GB 以上机器,整理出可直接套用的配置思路、参数含义和常见避坑点。
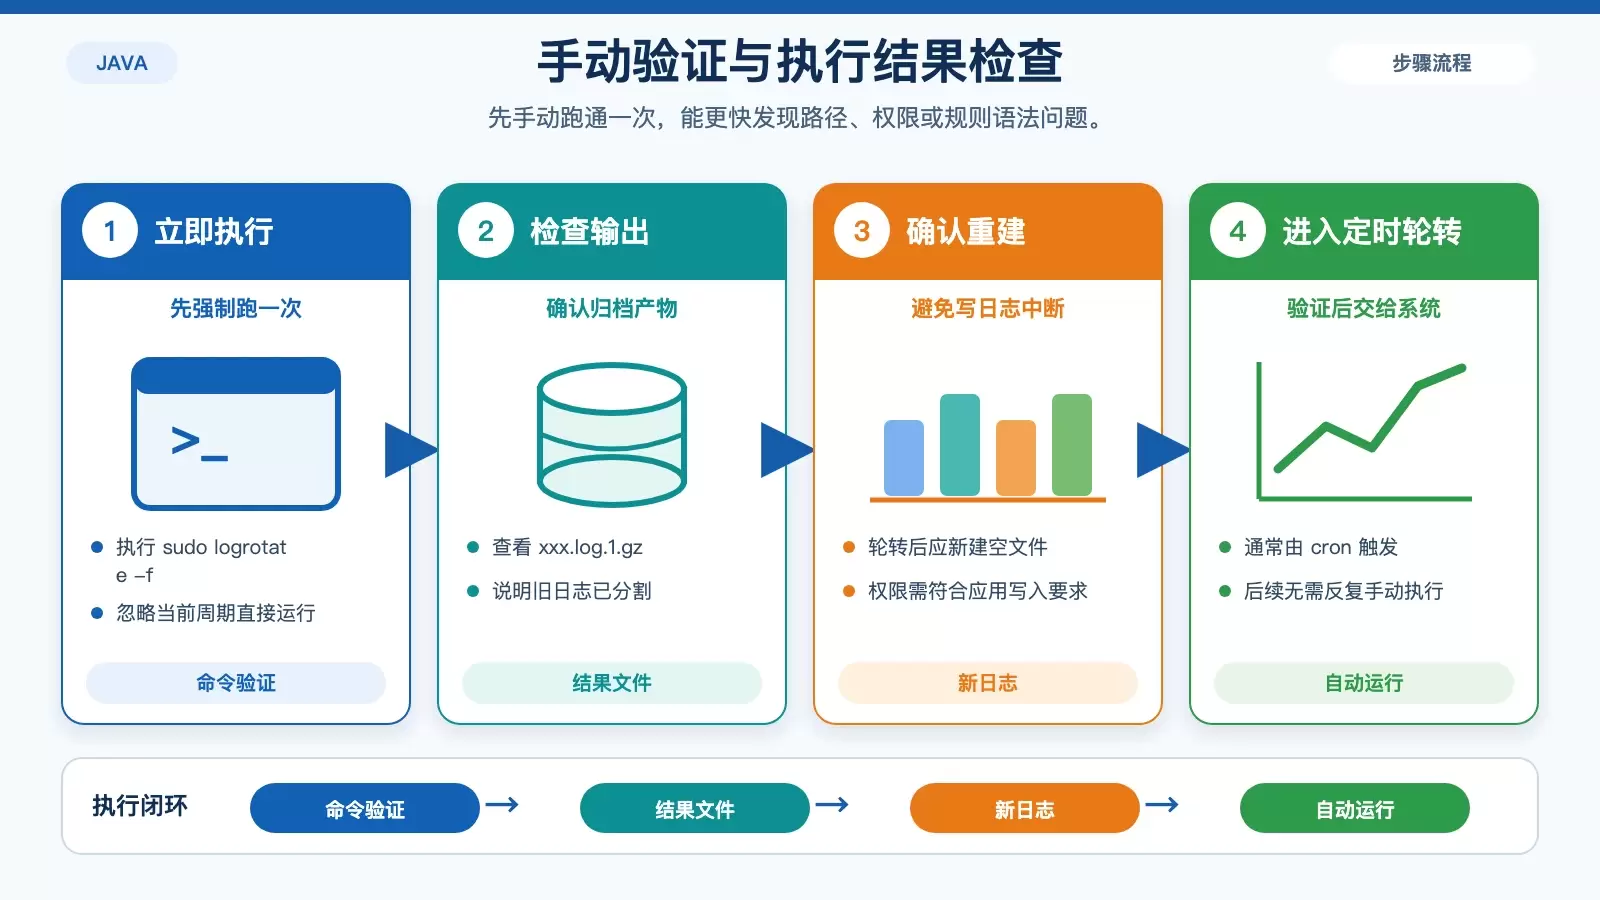
在 Ubuntu 上管理 Java 应用日志,最省事的办法通常是直接用系统自带的 logrotate。本文按安装、规则编写、参数含义、手动验证和自动轮转几个环节整理出一套可落地配置,方便你快速判断这套方案是否适合自己的日志目录和保留策略。