


想实时观察 Linux 下 C++ 线程的状态变化,很多人第一反应是去读 /proc/[tid]/status,或者循环查线程名、线程号。但对真正的排查工作来说,这类方法既慢,也经常来不及捕捉短生命周期线程,最后看到的只是一个不稳定快照。
更实用的判断方式,是把“线程状态变化”转成“线程发生了多少次上下文切换、这些切换是主动还是被动、是否需要进一步定位触发点”。下面按这个思路展开:先用轻量方案拿到线程级统计,再看深度排查时如何归因,最后把几个常见误区一次说清。
用 getrusage 获取线程级切换统计
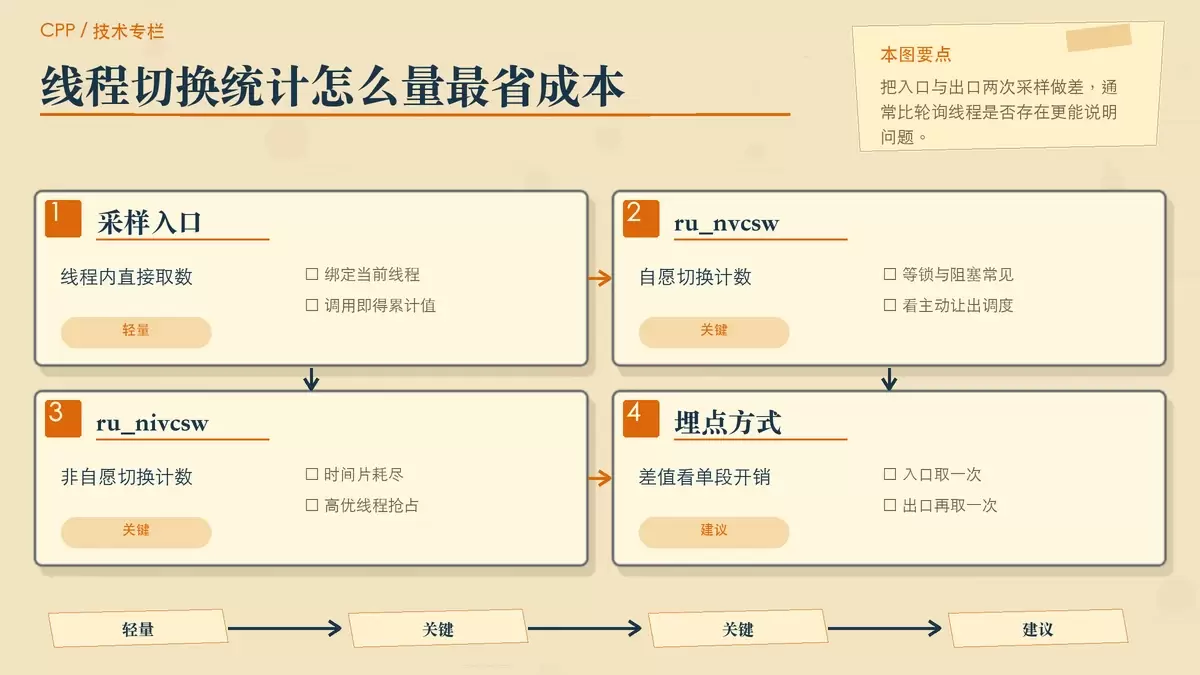
如果目标是在线程内部实时衡量某段逻辑的调度开销,最轻量、也最可靠的入口就是 getrusage(RUSAGE_THREAD, &ru)。它直接返回当前线程的资源使用情况,不需要先查 tid,也没有额外的路径查找和文本解析成本。
对于线程调度观察,最值得关注的是这两个字段:
ru.ru_nvcsw:自愿上下文切换次数。典型场景包括等待锁、执行pthread_cond_wait()、read()阻塞等。ru.ru_nivcsw:非自愿上下文切换次数。通常表示时间片耗尽,或被更高优先级线程抢占。
它的价值在于“调用即得累计值”。如果你在关键函数入口和出口各调用一次,那么两次结果的差值,就能近似表示这段逻辑引发了多少线程切换开销。对性能定位来说,这比单纯判断线程是否还活着更接近问题本身。
getrusage(RUSAGE_THREAD, &ru)这种方式还有几个实际优势:
- 线程绑定明确,拿到的就是当前线程自身数据。
- 不依赖
tid对应路径是否可见,避免线程刚退出就找不到对象的问题。 - 适合高频、低扰动采集,尤其适合作为函数级或阶段级埋点指标。
不过,使用前仍要确认运行环境支持 RUSAGE_THREAD。在 musl libc 或一些嵌入式环境里,这个选项可能没有实现;编译前也应确认已经定义 _GNU_SOURCE,并且头文件具备对应声明。
需要定位触发源时再用 perf_event_open
如果你不仅想知道“切换发生了多少次”,还要进一步回答“是谁触发了切换”“切换卡在哪条指令附近”,那就需要更重一点的工具:perf_event_open() 配合 PERF_COUNT_SW_CONTEXT_SWITCHES。
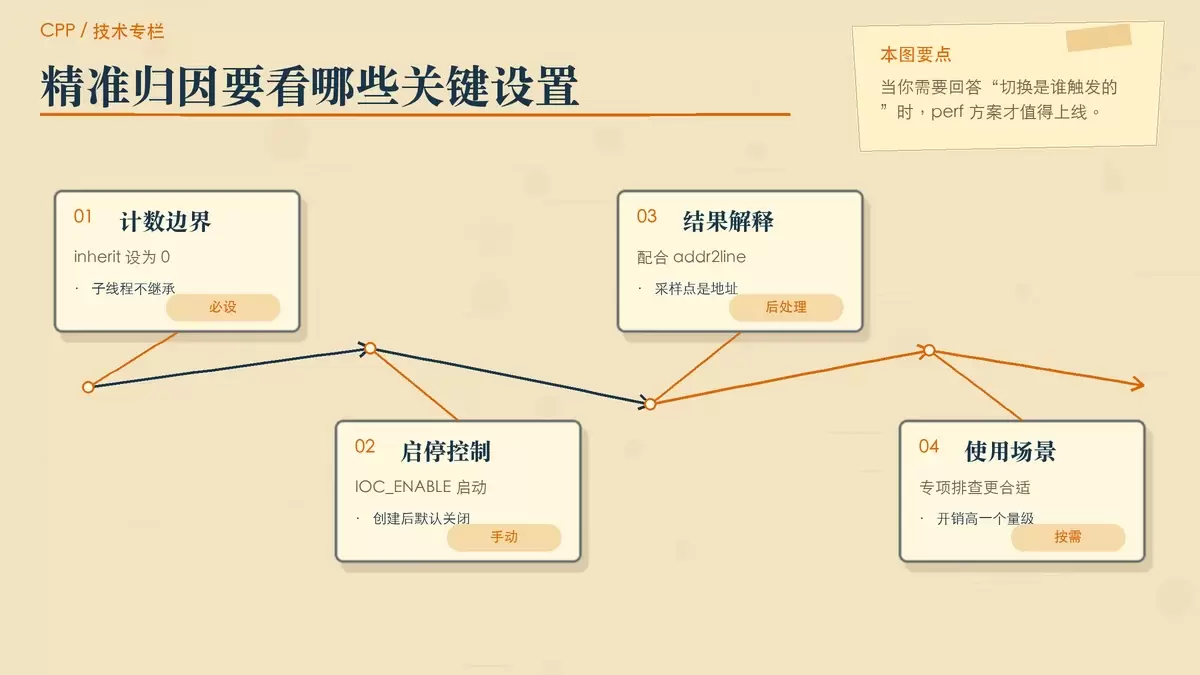
这类方案适合深度排查调度异常、锁竞争、意外抢占等问题。它和 getrusage 的区别,不在于能不能看到次数,而在于能否把切换和更具体的执行点关联起来。
使用时有几个细节不能忽略:
- 必须显式设置
attr.inherit = 0。否则子线程会继承计数器,最终把不属于当前分析对象的数据混进来。 attr.disabled = 1表示创建后默认不启用,因此还需要手动调用ioctl(fd, PERF_EVENT_IOC_ENABLE, 0)才会开始计数。- 事件回调里拿到的是内核采样点地址,后续通常还要借助
addr2line或 DWARF 信息做符号反解,才能回到具体代码位置。
这也是它比 getrusage 更适合“专项排查”而不是“全程常驻监控”的原因。原文已经给出结论:它的开销比 getrusage 高一个数量级,不适合高频采集,最好按需启停,用在怀疑有异常的阶段。
perf_event_open()
PERF_COUNT_SW_CONTEXT_SWITCHES
ioctl(fd, PERF_EVENT_IOC_ENABLE, 0)
addr2line
为什么不建议轮询 /proc/[tid]/status
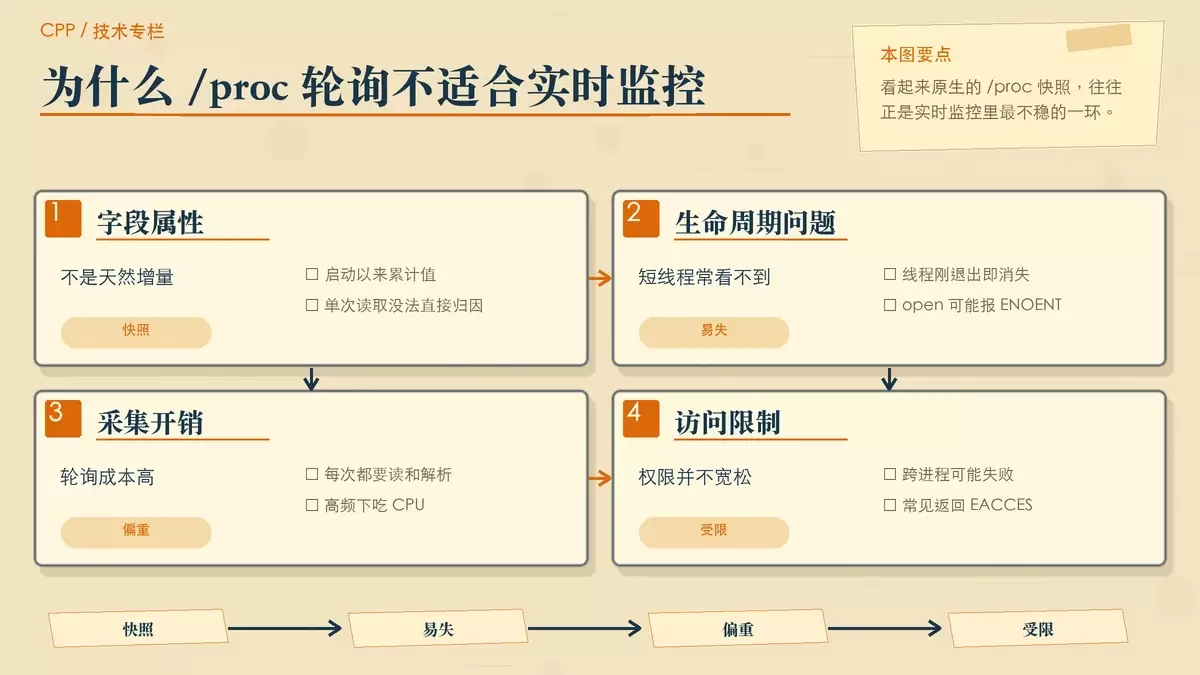
/proc/[tid]/status 里的 voluntary_ctxt_switches 看起来很直接,像是“现成答案”。但它并不适合拿来做实时线程监控,原因主要有三层。
它给你的只是快照,不是天然可用的实时增量
这个字段记录的是线程启动以来的累计值。也就是说,单次读取本身并不能告诉你“刚刚这段代码导致了多少切换”,你还得额外保存上一次结果,再自己做差值计算。
一旦采集逻辑进入多线程环境,这种“读取累计值再自行减法”的做法很容易引入竞态,最终让监控结果和真实执行过程错位。
线程生命周期太短时,路径本身就可能消失
gettid() 返回的 tid 虽然看起来可直接映射到 /proc/[tid],但这个目录并不保证在你需要时始终可读。线程刚退出时,open() 可能直接返回 ENOENT,短生命周期线程尤其容易“还没来得及看就已经没了”。
读取成本和权限限制都不友好
- 每次读取都要经历
open + read + parse,高频轮询下会明显消耗 CPU。 - 没有额外权限时,读取其他进程的
/proc/[tid]/status可能失败,并返回EACCES。 - 相比之下,
getrusage和perf_event_open在同属一个 uid 的前提下,更适合直接观察自身线程行为。
所以,这条路径更像是调试时顺手查看的静态信息来源,而不是稳定的实时监控机制。
实际选型:先定性,再归因
把几种方法放到同一个判断框架里,结论其实很清楚:真正值得实时观察的,不是“线程还在不在”,而是“线程是否频繁发生上下文切换、这些切换偏主动阻塞还是被动抢占、是否已经需要精确定位原因”。
在这个前提下,getrusage(RUSAGE_THREAD, &ru) 适合做第一层快速定性。它足够轻,能嵌在线程关键路径里,帮助你判断某段逻辑是否伴随异常切换增长。
当你已经确认存在调度异常,或者怀疑锁竞争、抢占行为有问题,再切换到 perf_event_open() 监听 PERF_COUNT_SW_CONTEXT_SWITCHES,去拿更细的触发归因信息。至于轮询 /proc/[tid]/status、拼接字符串查线程名这类方法,更多时候只会把采集系统本身变成新的噪声来源。
换句话说,实时线程状态监控的重点从来不是“看见线程”,而是“量化切换,再追到原因”。按这个顺序选工具,结论会更稳,排查成本也更低。









