Python读取文本文件生成词云并去除停用词
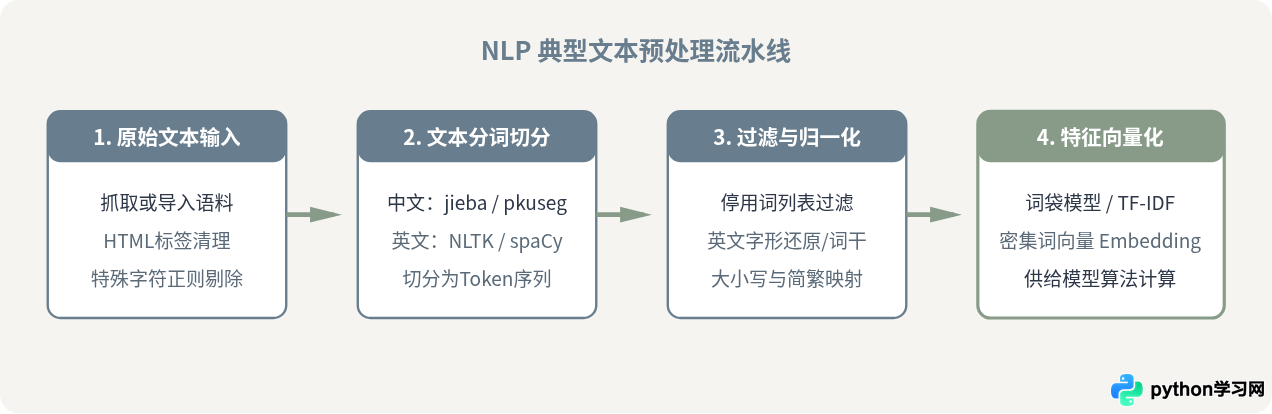
使用Python读取本地文本文件、通过jieba分词、构建停用词集合过滤无意义词元,并配置中文字体生成高质量词云图的完整操作指南与代码实现。
2026-10-29
32

使用Python读取本地文本文件、通过jieba分词、构建停用词集合过滤无意义词元,并配置中文字体生成高质量词云图的完整操作指南与代码实现。
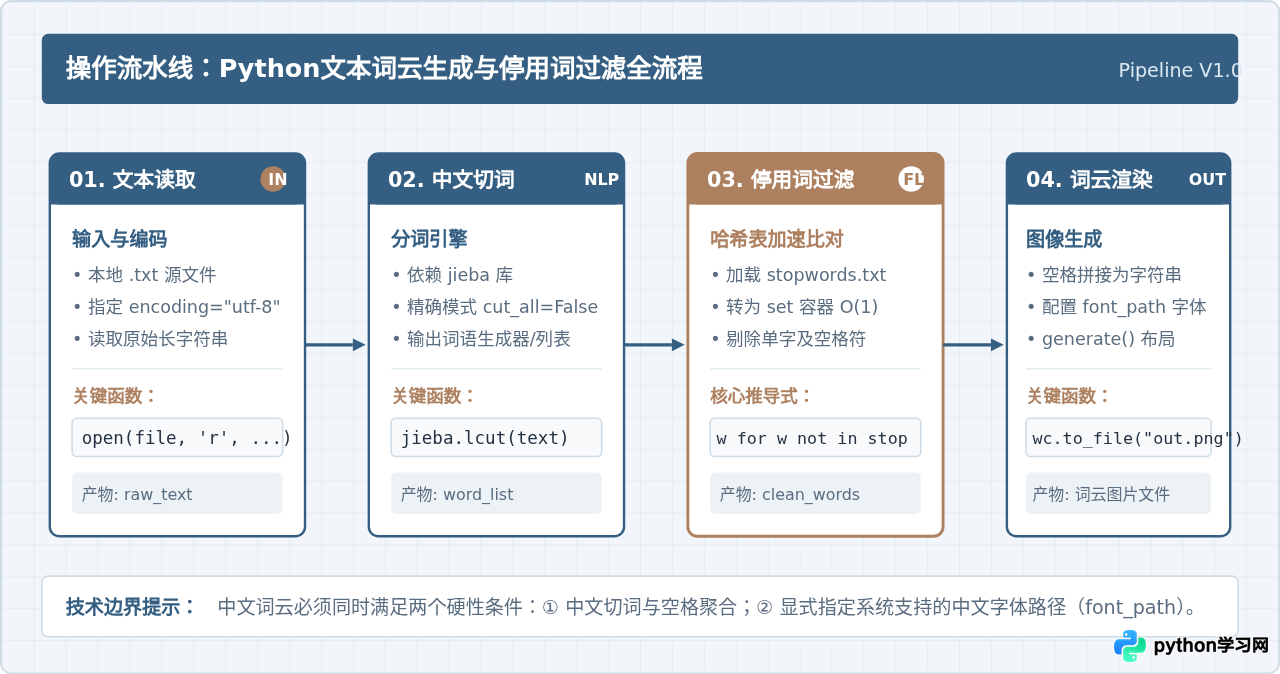
系统剖析在Python中直接使用字符级编辑距离导致中文模糊搜索准确率偏低的根因,提供结合Jieba分词、Pypinyin拼音转写、RapidFuzz多维加权打分及倒排粗筛的完整工程化解决路径与可执行代码。
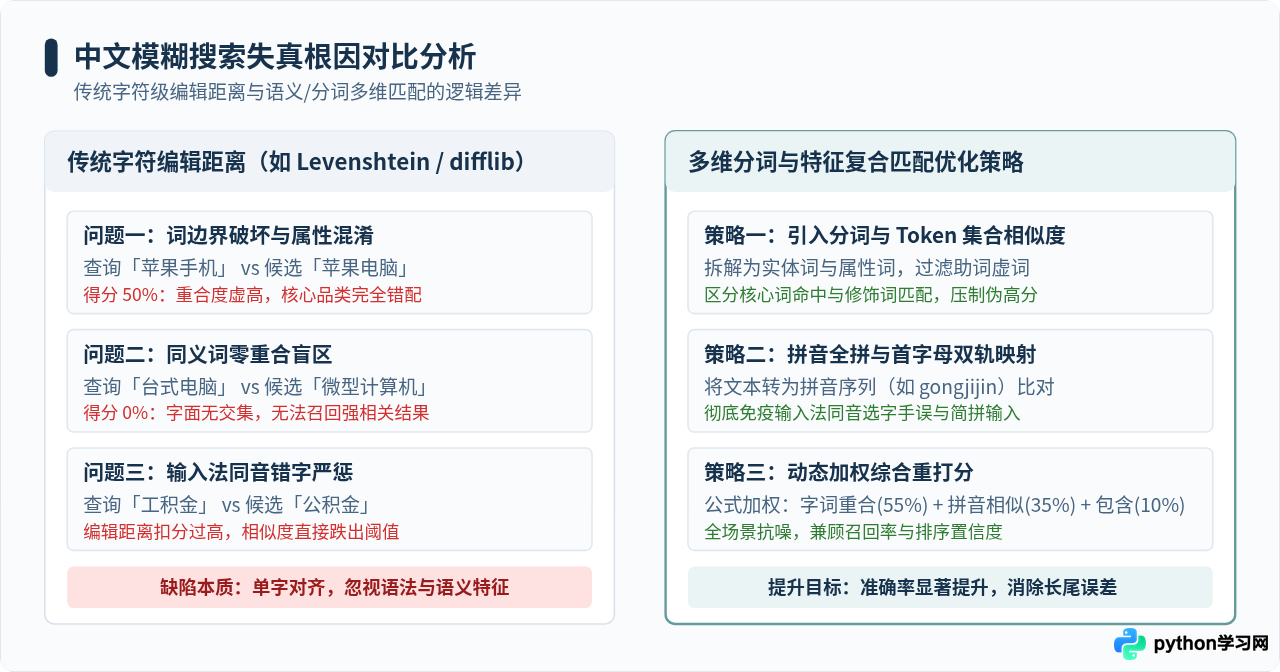
一份系统实用的Python自然语言处理(NLP)入门指南,深入讲解文本预处理、向量化特征工程、词嵌入等核心概念,并规划了三阶段进阶学习路径与代码实践。
本文介绍如何使用Python的requests和BeautifulSoup库抓取指定网页的正文内容,并利用jieba库对提取的文本进行分词处理。通过具体代码示例,展示了从获取HTML、解析DOM、提取文本到写入文件及分词输出的完整流程,适用于简单的网页内容分析与预处理场景。
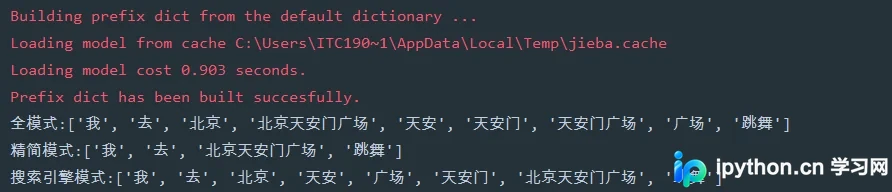
本文深入解析Python jieba库的三种分词模式(全模式、精简模式、搜索引擎模式),详解如何添加自定义词典以控制词语切分,并探讨基于隐马尔可夫模型(HMM)和Viterbi算法处理未登录词的底层原理。通过代码示例展示jieba在实际应用中的灵活配置与参数调整方法。
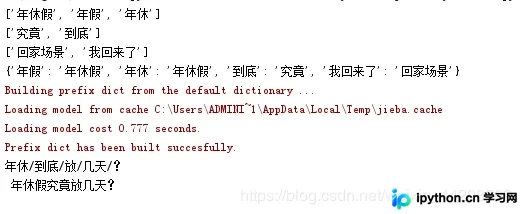
本文介绍如何利用Python的jieba库结合自定义同义词词典实现文本中的词汇替换。通过读取指定格式的TXT文件构建映射字典,调整特定词汇的词频以确保正确分词,随后对输入字符串进行切分并执行替换逻辑。该方法适用于需要标准化术语或进行文本预处理的自然语言处理场景。