

基于Python神经网络的手写数字识别实战与代码解析
本文基于《Python神经网络编程》一书,详细解析了使用Python构建简单神经网络以识别手写数字的实现过程。内容涵盖从图像像素读取、数据预处理(如灰度值取反与归一化)到模型训练及测试统计的完整代码逻辑。同时,文章探讨了针对特定像素图片训练的局限性,并分析了识别模糊现象的可能原因,为初学者提供了一份可直接参考的实践指南。
2026-10-13
6

本文基于《Python神经网络编程》一书,详细解析了使用Python构建简单神经网络以识别手写数字的实现过程。内容涵盖从图像像素读取、数据预处理(如灰度值取反与归一化)到模型训练及测试统计的完整代码逻辑。同时,文章探讨了针对特定像素图片训练的局限性,并分析了识别模糊现象的可能原因,为初学者提供了一份可直接参考的实践指南。
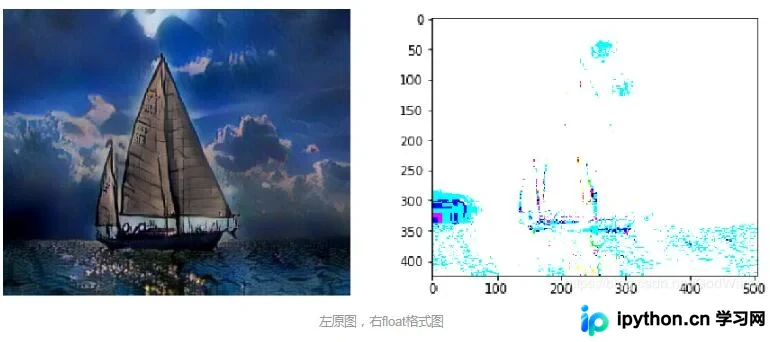
本文详解在TensorFlow中加载Vgg预训练模型时遇到的uint8与float数据类型不匹配报错。通过对比tf.image.decode_jpeg默认行为,说明使用tf.to_float进行类型转换的必要性与安全性,并指出保存float格式图片时需转回uint8,否则会导致显示异常或API报错。
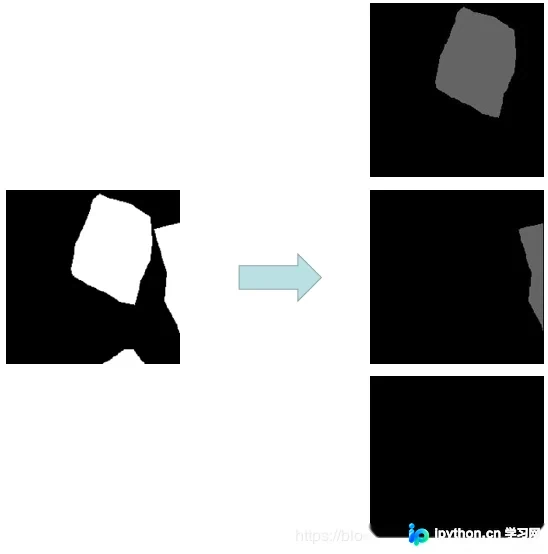
本文介绍如何使用Python和OpenCV库完成图像分割及目标物提取。通过读取图片、灰度化与二值化处理,利用cv2.findContours提取边界轮廓。随后结合cv2.pointPolygonTest判断像素点位置,在黑色底板上精准提取目标区域并保存结果,适用于Windows平台下的Spyder环境开发。
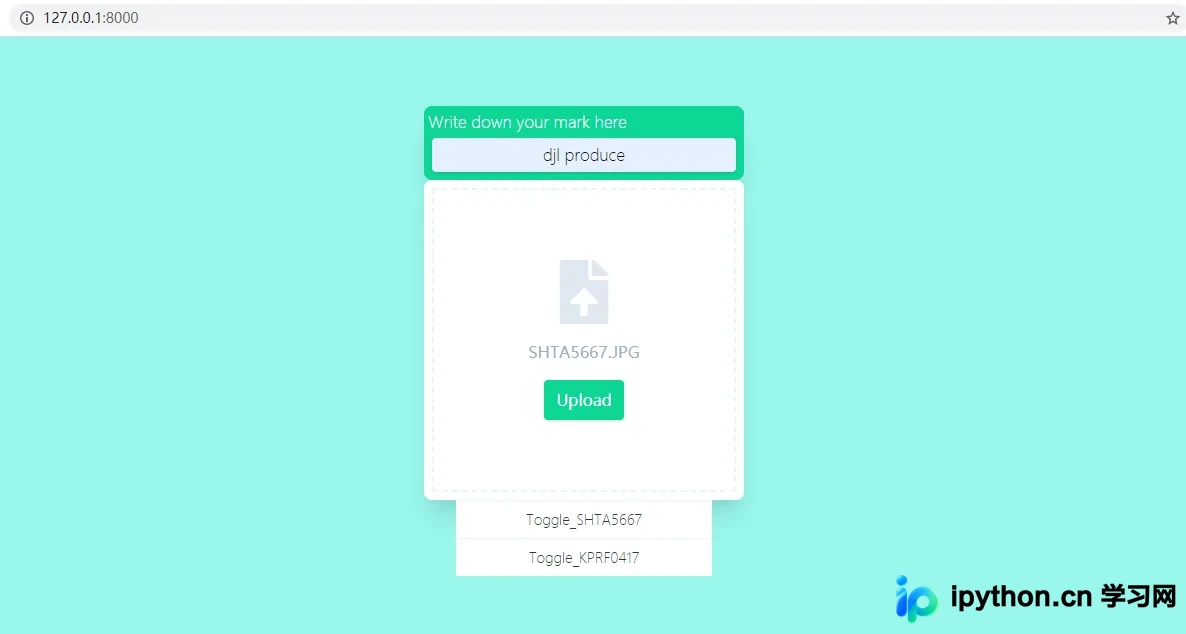
本文介绍如何使用 Django Micro 框架快速搭建一个图片加水印功能。通过整合前端表单与后端处理逻辑,用户可输入水印文字并选择图片,系统自动生成带有指定文字水印的图片。支持多图片预览及缩略图显示隐藏功能,代码示例展示了核心路由配置与图像处理方法。
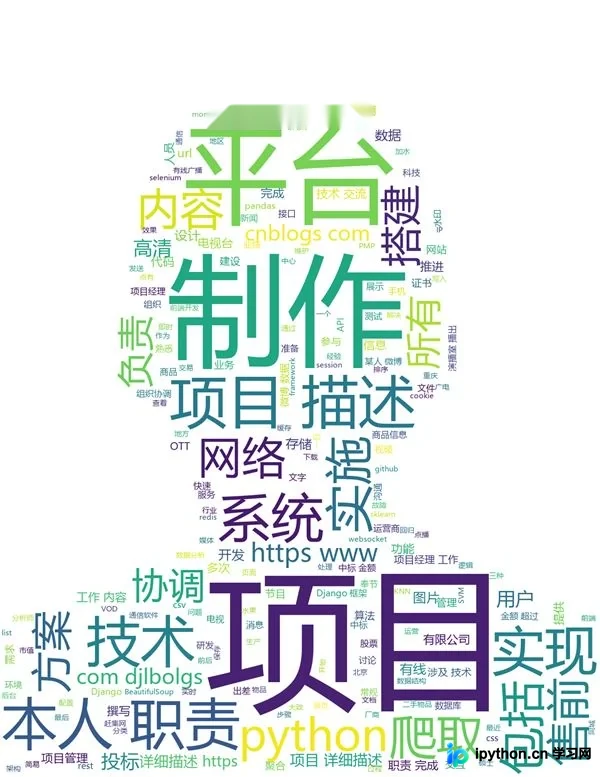
本文介绍如何使用Python的wordcloud库,结合jieba分词和imageio图像处理,通过读取文本文件和背景图片生成自定义形状的词云。文章提供了完整的代码示例,涵盖文本预处理、词语分割、图片读取及词云生成保存的全过程,帮助开发者快速实现可视化效果。
本文详细介绍 Django 中 FilePathField 字段的定义与核心参数,包括 path、match、recursive 等配置方法。通过实际案例演示如何利用该字段结合 ImageField 实现大图上传与自动缩略图生成的完整流程,涵盖路径管理、文件匹配及前端展示逻辑,帮助开发者优化媒体文件管理。
本文详细介绍如何使用Python将普通照片转化为由“我爱你”等文字组成的艺术图片。通过OpenCV读取像素信息,结合PIL库在白色背景上逐块填充指定文字,并映射原图颜色值,最终生成独特的文字云效果。教程涵盖环境准备、核心代码逻辑及完整实现步骤,适合Python初学者尝试创意编程。
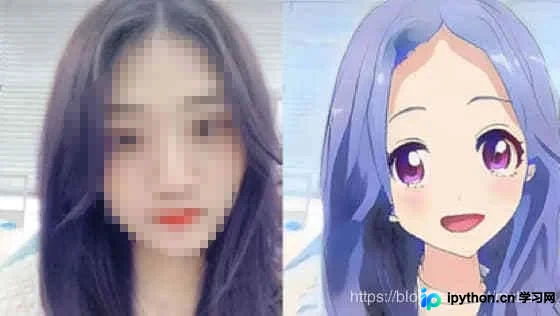
本文介绍如何使用Python调用百度AI开放平台的人像动漫化接口。通过获取Access Token并发送图片数据,实现照片到动漫风格的自动转换。文章包含完整的代码示例、API地址及注意事项,帮助开发者快速集成该功能。
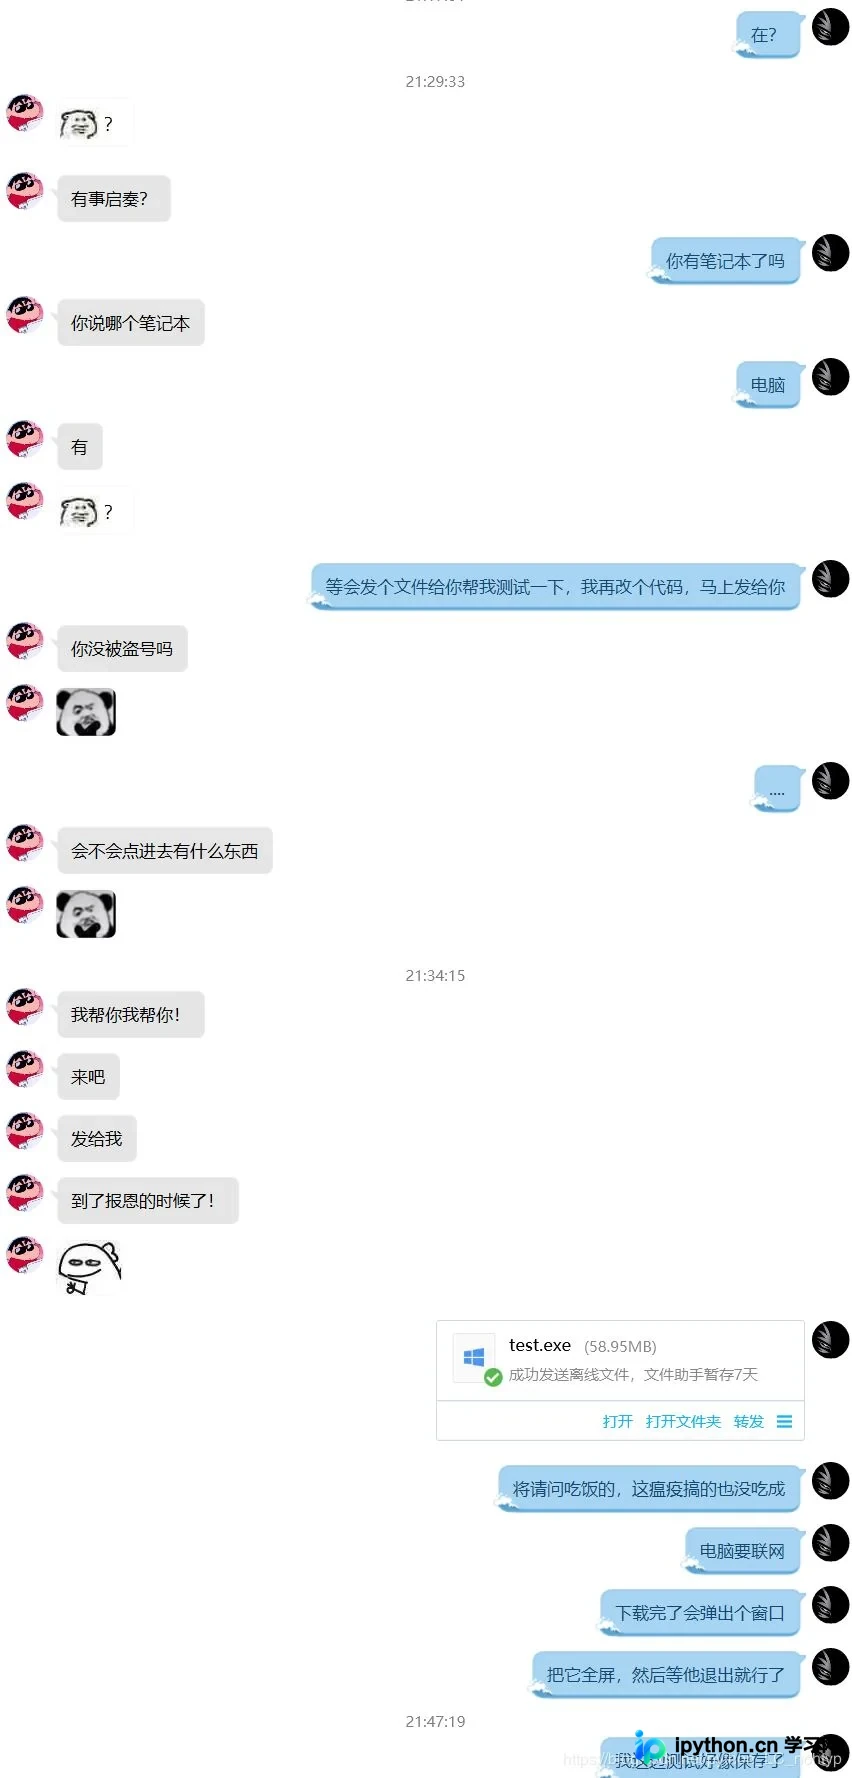
本文详细介绍如何使用Python结合OpenCV调用本地摄像头,通过内置email模块将截图发送至QQ邮箱,并利用PyInstaller将脚本打包为独立EXE文件。教程涵盖邮件配置、代码实现及打包步骤,适用于技术学习与自动化测试场景。
本文详细介绍如何使用Python的PIL库在图片上绘制线条和添加文字。通过ImageDraw模块,您可以自定义线条颜色、宽度及文字字体、透明度。此外,文章还补充了结合OpenCV从文本文件读取人脸坐标并批量绘制检测框的实用代码示例,帮助开发者快速掌握图像标注技巧。
本文通过Python代码实测四种常见图像填充方法的执行时间。对比结果显示,OpenCV颜色填充耗时约3.67秒最快,切片赋值约6.55秒次之,矩阵乘法约74.28秒,而双重循环遍历赋值最慢,耗时超3200秒。文章提供了完整测试代码及规则多边形填充示例,帮助开发者根据场景选择高效方案。
本文介绍如何使用Python将小尺寸图片叠加到大尺寸底图上,并在空白区域添加个性化文本。通过PIL库生成带字体的透明图层,再利用OpenCV进行图像融合与位置调整,最终输出合成后的完整图片。