

HTML CSS 清除浮动详解:原理、影响与两种主流方案
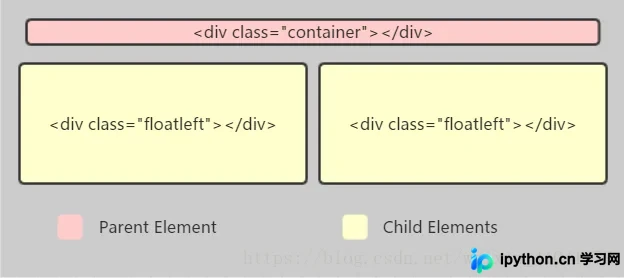
本文深入解析 HTML 中 CSS 浮动的概念及其导致的父元素高度坍塌问题。重点对比两种清除浮动的方法:添加空标签法与 :after 伪元素法。详细阐述 clearfix 类的实现原理、兼容性处理(如 IE6/7 的 zoom 属性)及优缺点,帮助开发者掌握现代网页布局中的浮动清理技巧。
2026-10-13
6

本文深入解析 HTML 中 CSS 浮动的概念及其导致的父元素高度坍塌问题。重点对比两种清除浮动的方法:添加空标签法与 :after 伪元素法。详细阐述 clearfix 类的实现原理、兼容性处理(如 IE6/7 的 zoom 属性)及优缺点,帮助开发者掌握现代网页布局中的浮动清理技巧。
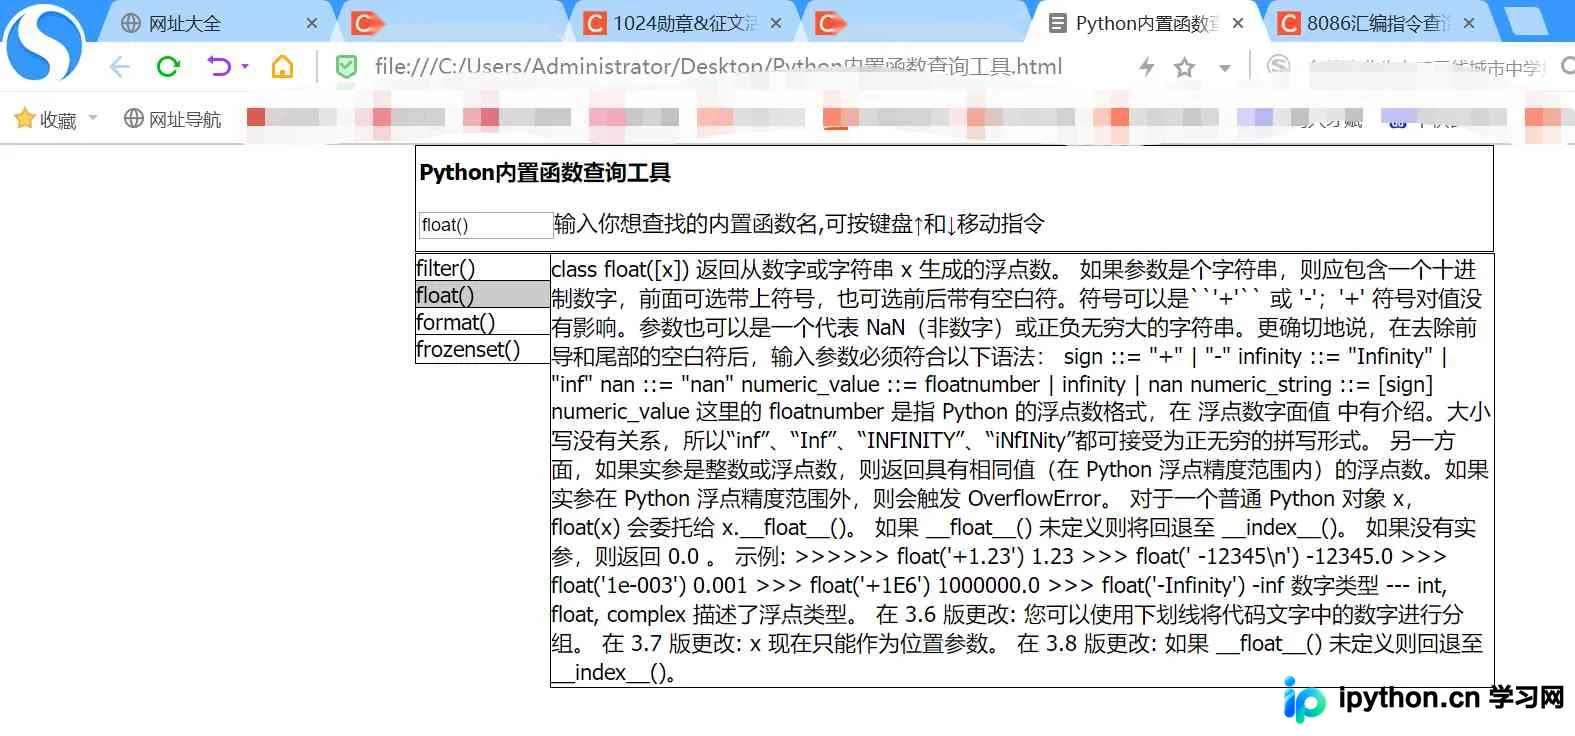
本文介绍如何利用纯JavaScript和HTML构建一个无需网络连接的Python内置函数查询工具。通过将函数数据嵌入DOM节点,结合键盘事件监听与动态标签生成,实现输入即搜、上下键切换的交互体验。该方案适用于本地学习环境,代码结构清晰,适合前端初学者参考实践。
本文详解如何使用Python实现邮件自动下载功能。通过对比SMTP、POP3和IMAP协议,重点讲解基于IMAP协议的邮件登录与解析。代码示例展示了如何提取邮件主题、下载附件至指定路径,并解析HTML正文保存为文本文件,同时提及利用Pandas处理表格附件,提供完整的类封装与运行逻辑。
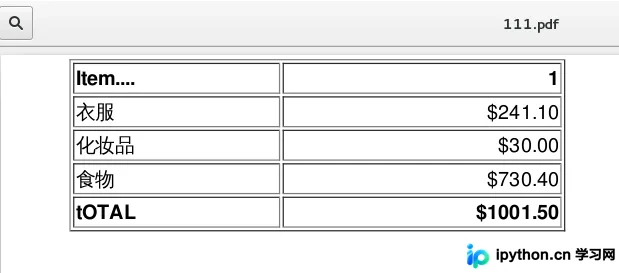
本文详解Python中利用pdfkit库将HTML转换为PDF的实现方法。内容涵盖pdfkit及wkhtmltopdf在Debian、CentOS和MacOS下的安装步骤,演示from_url、from_file及from_string等核心API用法,并深入讲解自定义页面选项、CSS注入及Meta标签配置。针对常见的IOError和中文乱码问题提供排查方案,附带完整代码示例。
本文介绍如何在Python中使用lxml模块结合XPath语法解析HTML文档。通过对比jQuery和正则表达式,演示如何定位特定节点、提取文本及处理嵌套结构,并详细解析XPath基本语法如路径分隔、属性过滤及节点函数,帮助开发者掌握高效的网页数据抓取技巧。
本文详细介绍在Python中处理HTML转义字符的五种方法。涵盖Python2的HTMLParser模块、Python3中html.parser的迁移、Python3.4新增的html.unescape推荐用法,以及xml.sax模块的支持方案。文章对比了各版本的兼容性与废弃状态,帮助开发者选择合适的数据清洗工具。
本文详解Python中使用lxml进行XPath定位时,在循环内复用XPath表达式常遇到的陷阱。当使用绝对路径(如//td)时,解析器会重新搜索整个文档而非当前节点,导致返回错误数量的元素。核心解决方案是在XPath前添加点号(.//td)以指定相对路径,确保搜索范围限制在当前节点及其子节点内,从而准确获取预期数据。
本文详解如何利用Python内置的re模块通过正则表达式高效处理HTML文件。涵盖基础标签定位、开启与关闭标签区分、带参属性解析、同行标签对验证以及全局HTML标记剥离等核心操作,帮助开发者在简单场景下快速完成文本清洗与数据提取。
本文介绍如何使用Python脚本批量抓取百度贴吧指定帖子的多页内容,并将每一页的原始网页代码自动下载至本地。文章提供适配Python 3的标准代码示例,涵盖参数输入、分页循环、HTTP请求与文件写入的完整操作路径,适用于基础网络数据采集与静态页面本地存档需求。
本文介绍如何使用 Python 的 win32com 模块开发 Windows ActiveX 组件。通过定义类、注册 COM 服务器,并在 HTML 页面中调用,实现 Python 与 Web 环境的交互。
本文详解如何使用 Python 的 smtplib 和 email 库发送包含纯文本、HTML 正文、内嵌图片及文件附件的复杂邮件。通过构建 MIMEMultipart 对象,分别处理文字、图片与附件内容,并配置 SMTP 服务器参数,实现自动化邮件发送功能。
本文介绍如何使用Python将Word文档批量转换为HTML格式。通过安装python-docx和PyDocX库,利用os模块遍历目录,自动处理文件名空格问题,并循环调用转换函数生成对应的HTML文件。转换后的内容可直接存入数据库进行展示,适用于文档批量处理场景。