Go 反射性能优化实战:哪些地方最耗时,应该怎么改
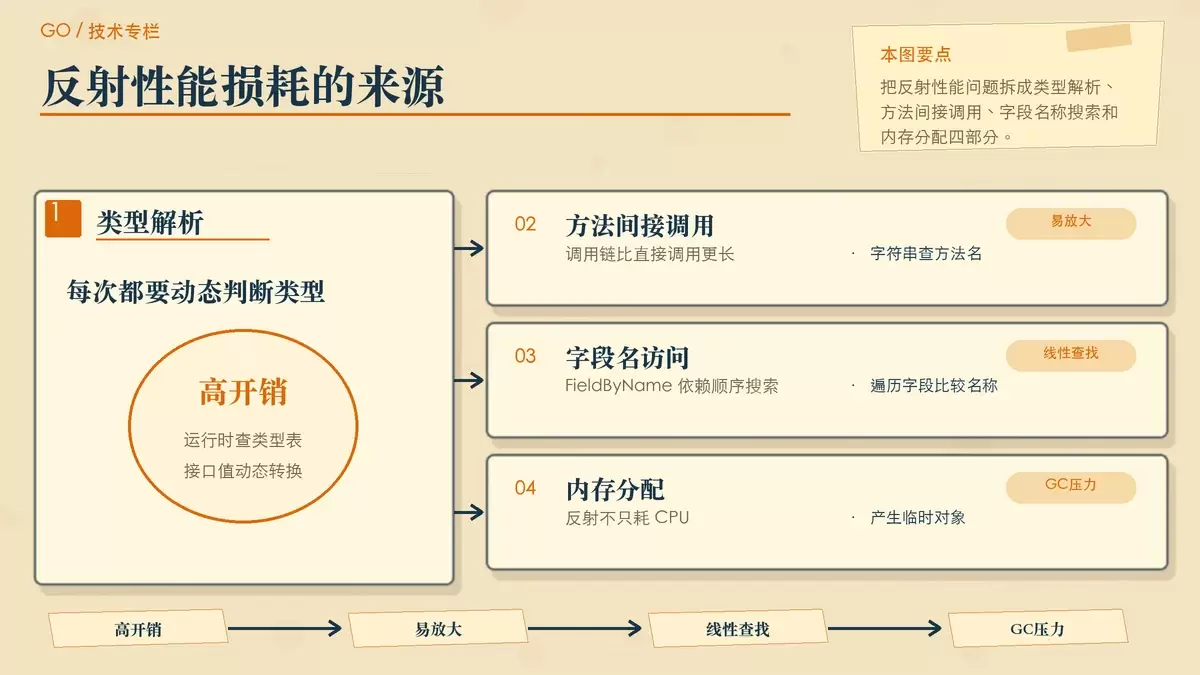
Go 反射很灵活,但一旦落到高频路径上,类型解析、字段查找和临时对象分配都会迅速放大成本。本文围绕“为什么慢、该怎么改、不同场景怎么选”三件事展开,结合缓存、字段索引、批处理、代码生成和接口断言,梳理一套更适合实战的优化思路。
2026-08-25
79
Go 反射很灵活,但一旦落到高频路径上,类型解析、字段查找和临时对象分配都会迅速放大成本。本文围绕“为什么慢、该怎么改、不同场景怎么选”三件事展开,结合缓存、字段索引、批处理、代码生成和接口断言,梳理一套更适合实战的优化思路。
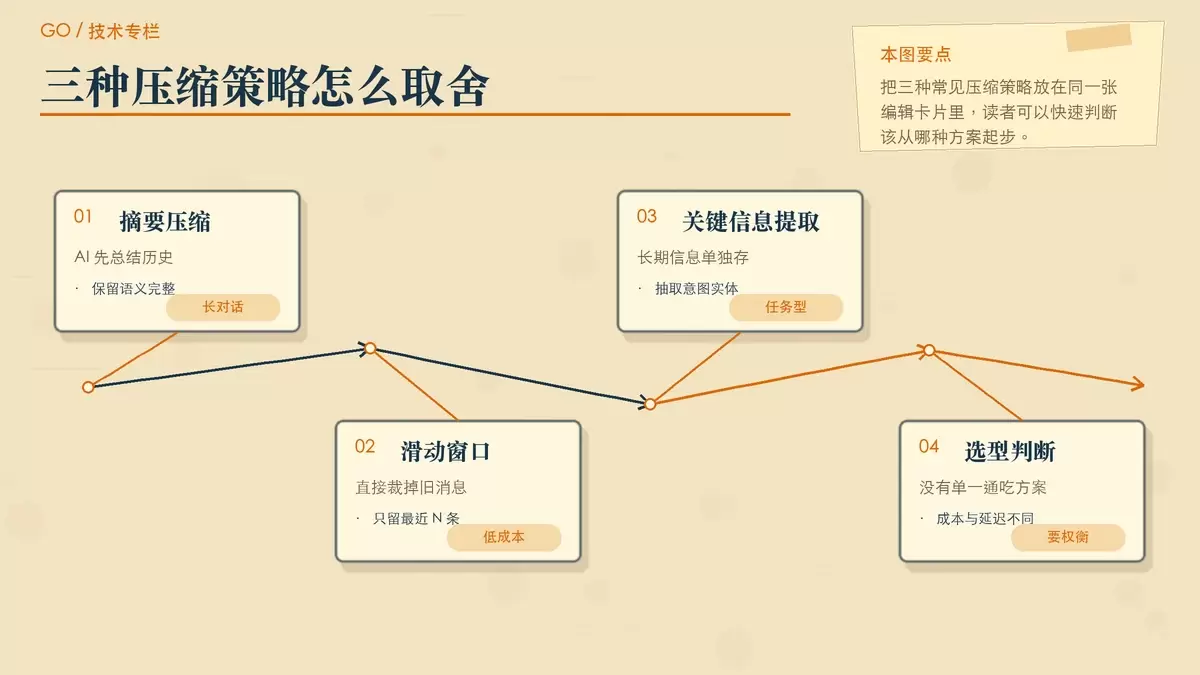
大模型会“忘事”,本质上往往不是能力问题,而是上下文窗口和成本双重限制。本文结合 Go 示例,把摘要压缩、滑动窗口、关键信息提取三种常见做法拆开说明,并给出组合策略、触发阈值和几个容易踩坑的实现细节。
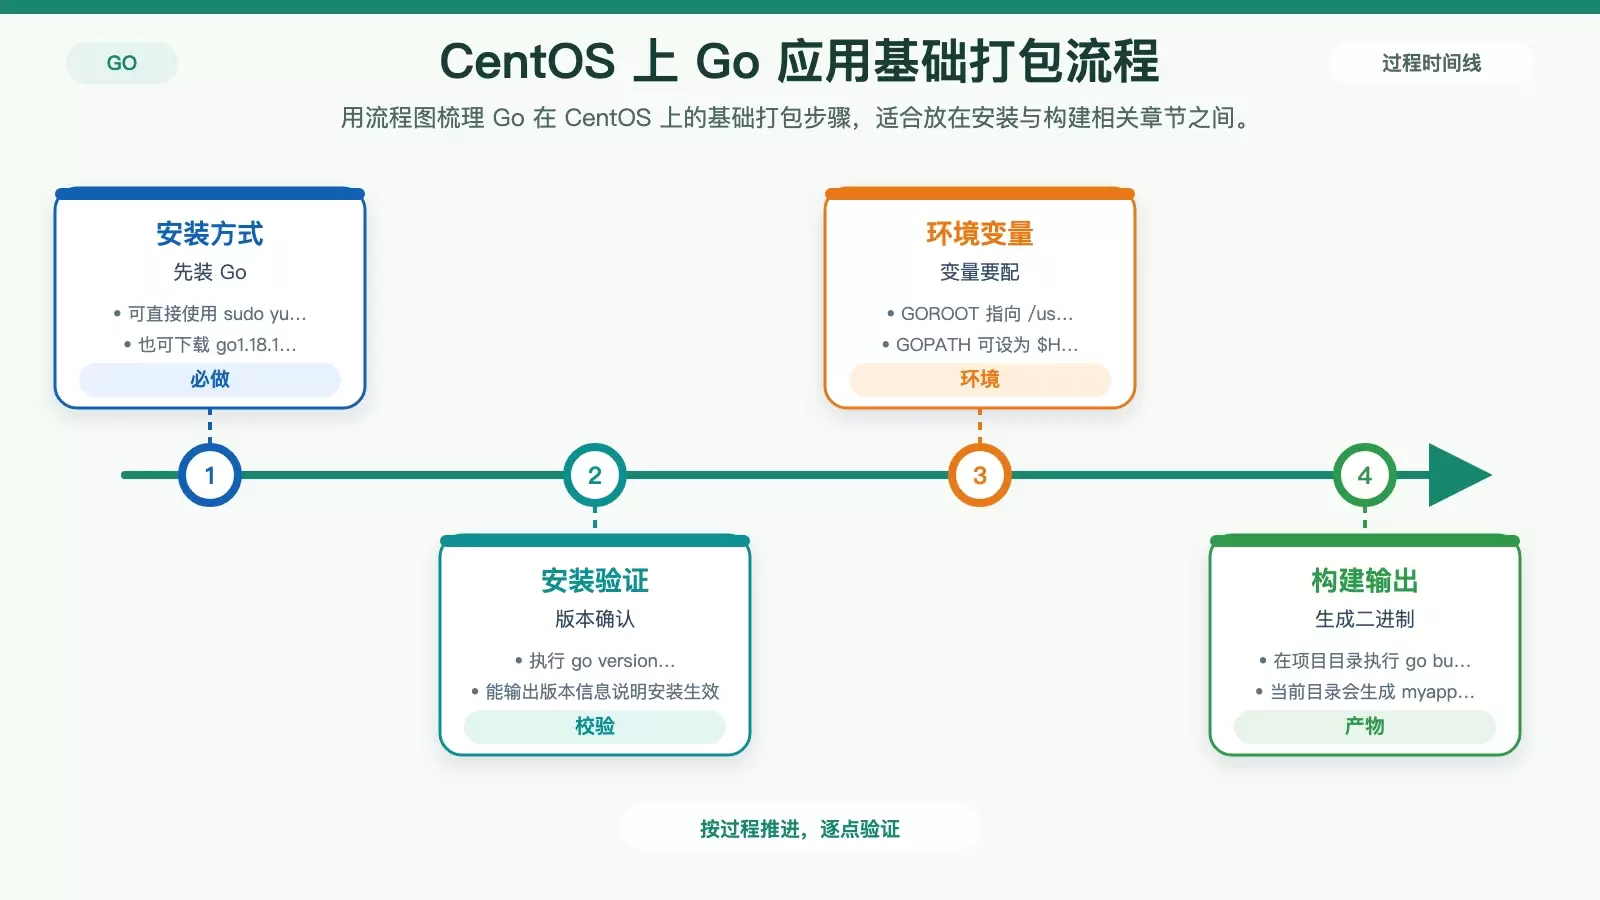
这篇文章把在 CentOS 上打包 Go 应用的流程拆成安装、环境变量、构建、压缩和服务化几个环节,并补充了 CentOS 7/8 下可直接使用的命令。对于需要跨环境部署的场景,文中也给出静态编译和容器化的判断建议。
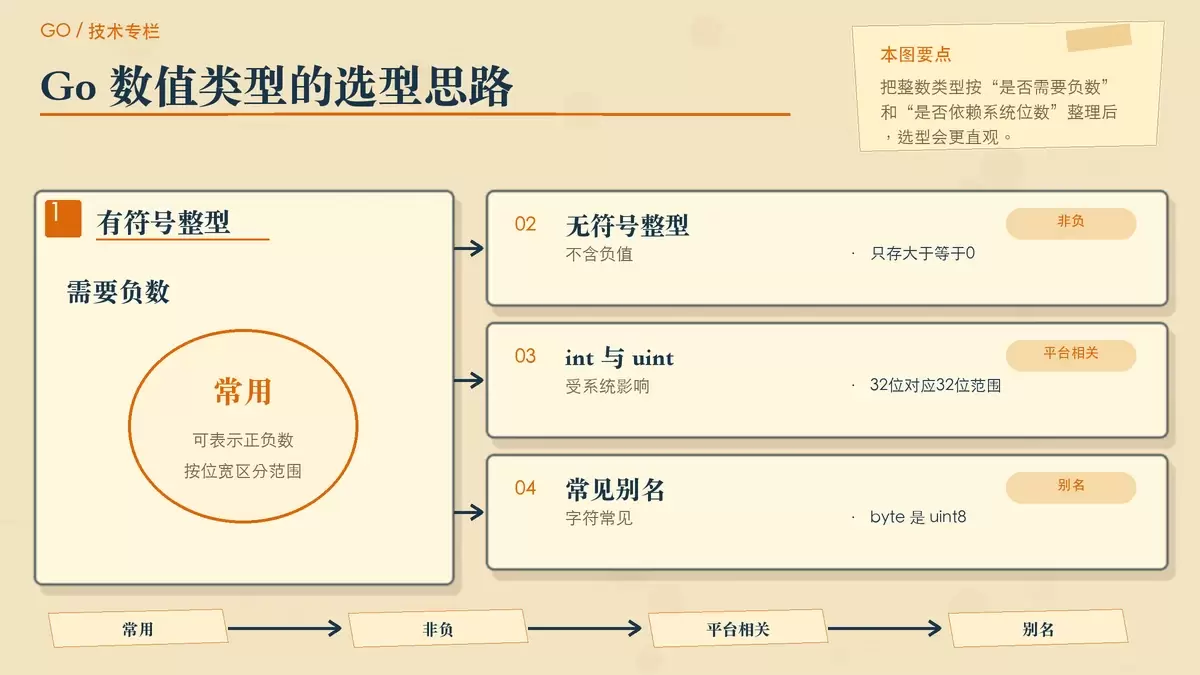
这篇文章围绕 Go 里最常用的基础类型展开,重新梳理了布尔、数值、字符串和类型转换的实际用法。重点保留了各类整数、浮点数、复数和 `strconv` 转换示例,并补上选择类型时最容易混淆的判断依据。
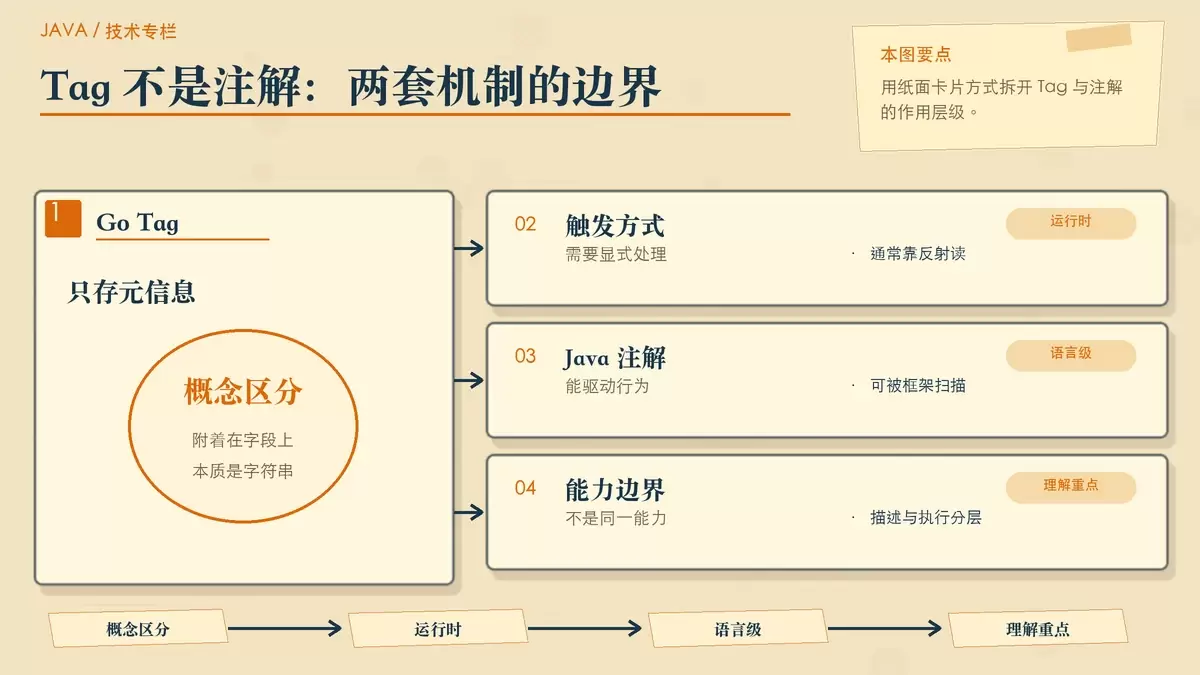
Go 没有 Java 式注解,并不是能力不够,而是刻意避开“隐式魔法”的设计选择。本文从注解与 Tag 的区别、Go 的设计哲学、常见场景替代写法和工程取舍四个角度,说明 Go 为什么更偏向显式调用,以及这种克制在维护、调试和编译速度上的实际价值。
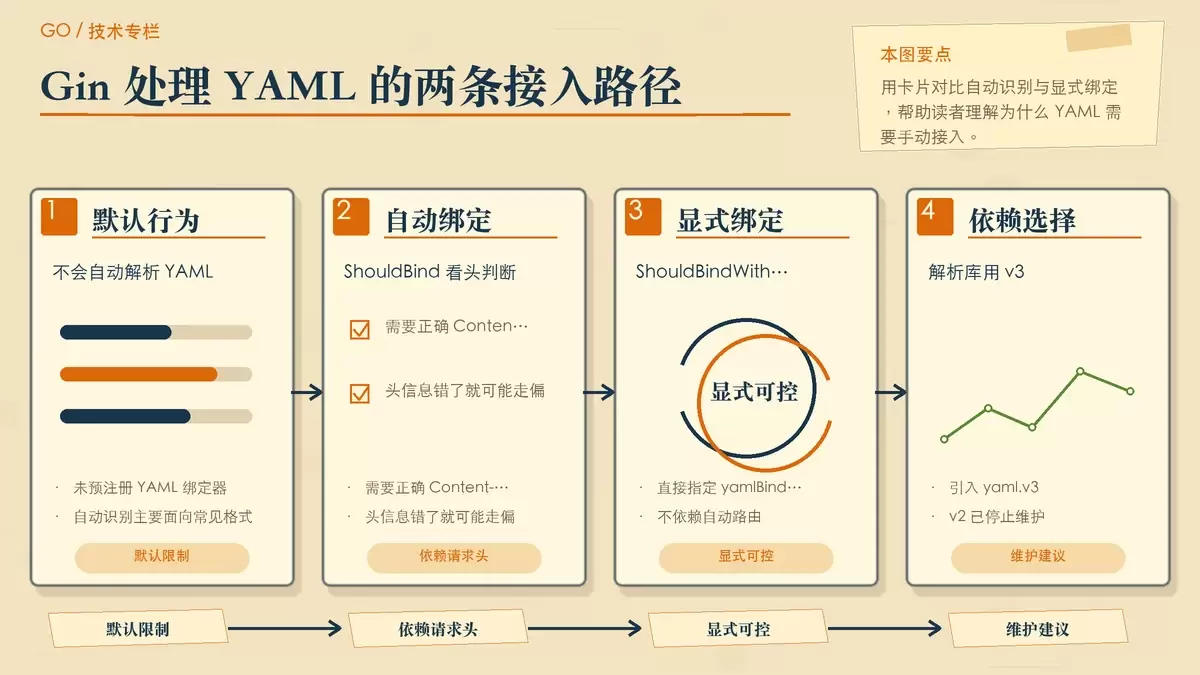
Gin 默认不会自动解析 YAML 请求体,这不是缺陷,而是出于依赖控制和反序列化安全的设计。本文从原因、两种接收方式和常见坑位入手,说明在 Gin 中怎样显式绑定 YAML、何时直接读取原始文本,以及该如何规避 Content-Type 和请求体重复读取问题。
`io.Discard` 是 Go 标准库里一个很小却很常用的对象:它实现了 `io.Writer`,但会把写入的数据直接丢掉。真正值得关注的不是“丢弃”本身,而是它在 HTTP 连接复用、日志开关、网络读取和测试替身中的实际价值,以及 `ReadFrom` 带来的性能收益。
Go 1.13 引入的 errors.Is 和 errors.As,解决了错误被层层包装后难以判断、难以提取的问题。本文从传统字符串匹配的痛点讲起,梳理 Unwrap、%w、错误链,以及两者各自适用的场景,帮助你判断该比对错误值,还是提取具体错误类型。
Go 1.23 引入的标准库包 `unique`,把过去常见但容易踩坑的值去重做成了官方能力。它适合重复值很多、比较频繁的场景,既能减少冗余内存占用,也能把等值判断从字符串比较转成更轻量的句柄比较。
Go 的命名返回值不算复杂,却很容易在多返回值、错误处理和 defer 场景里提升可读性。本文从语法、适用场景到使用边界梳理这个特性,帮助你判断它什么时候能让函数签名更清楚,什么时候又该保持普通写法。
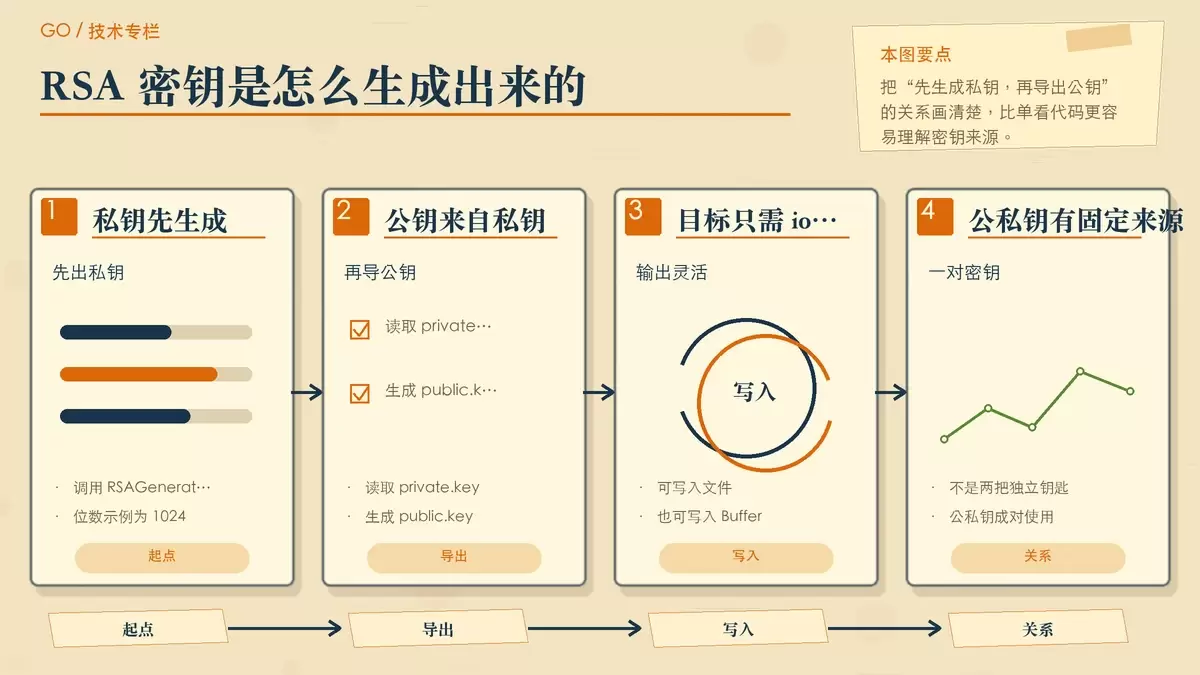
这篇文章用一个更省代码的 Go 封装库,梳理 RSA 在实际开发里的三个基本动作:生成密钥、公钥加密私钥解密、私钥签名公钥验签。示例都基于 `github.com/forgoer/openssl`,适合想快速落地 RSA 功能、同时分清加密和签名职责的 Go 开发者。
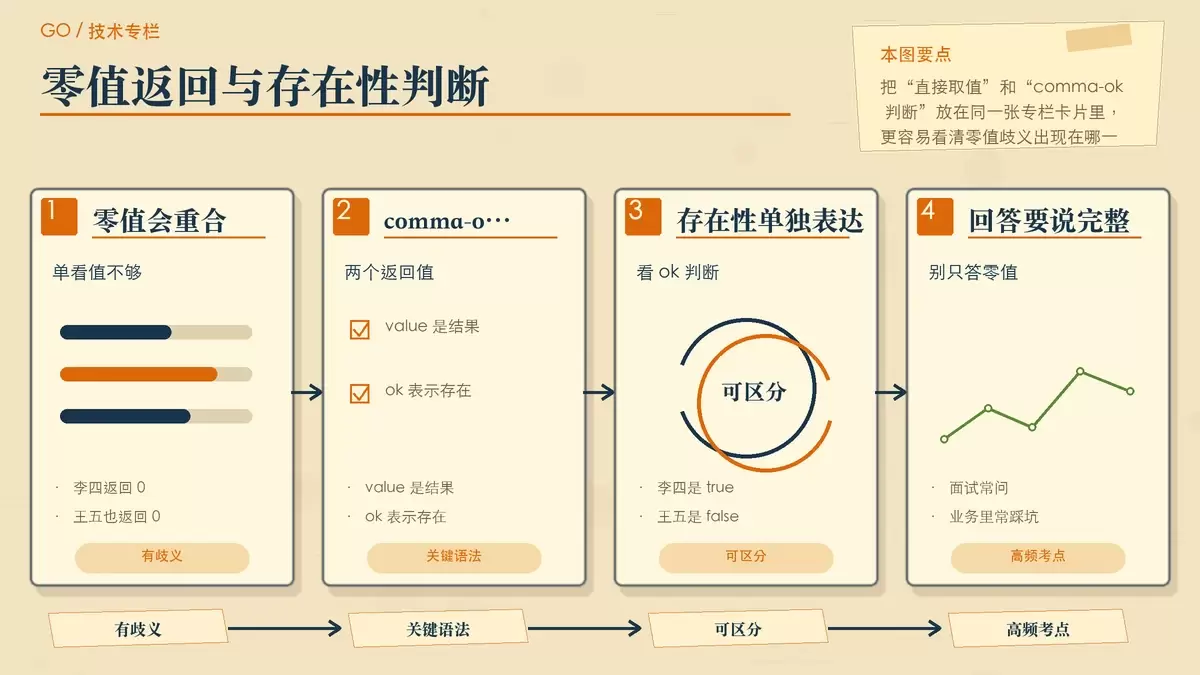
Go 的 map 在读取不存在的 key 时不会报错,而是直接返回 value 类型的零值。这种设计让代码更简洁,但也会带来“key 不存在”和“值本来就是零值”难以区分的问题。本文结合常见示例,讲清零值返回规则、comma-ok 用法,以及初始化、并发和容量预分配等实战注意点。