


很多 Go 开发者第一次看到 io.Discard,会把它理解成“把数据扔掉”的语法糖,但它的价值远不止省一行变量。遇到只关心状态码、不关心响应体,或者需要满足 io.Writer 接口但又不想真的落盘、打印、缓存时,io.Discard 往往就是最直接的标准答案。本文从定义、实现和常见场景三部分展开,帮助你判断它该在什么地方用、为什么这样用,以及什么时候配合 io.Copy 才能真正发挥性能优势。
什么是 io.Discard
io.Discard 是 Go 标准库 io 包中的一个变量。它实现了 io.Writer 接口,但行为非常特殊:写进去的数据会被立即丢弃,不做保存,也不会产生实际输出。
它的定义很简单:
var Discard Writer = discard{}从 Go 1.16 开始,Discard 直接由 io 包导出;在更早的版本里,它位于 io/ioutil 中。随着 io/ioutil 逐步淡出日常使用,现在通常直接写 io.Discard 即可。
这类对象的意义在于:有些代码路径并不是“不需要处理数据”,而是“必须把数据读完或必须提供一个 Writer,但结果本身不需要保留”。这时,io.Discard 比自定义空实现更规范,也更容易读懂。
为什么丢数据也值得专门处理
表面上看,既然数据最终不要,似乎最好的办法是完全不处理它。但在很多 I/O 场景里,事情并没有这么简单。
一个典型例子是 HTTP 客户端。很多时候你只想知道请求是否成功,真正关心的是状态码,而不是响应体内容。可如果响应体没有被完整读取,底层连接往往无法复用,连接可能直接关闭,后续请求就要重新建连,额外带来延迟和资源开销。
也就是说,“不需要内容”不等于“可以不读内容”。这正是 io.Discard 出场的地方:把数据读取出来,但不保留它,让资源生命周期保持正确。
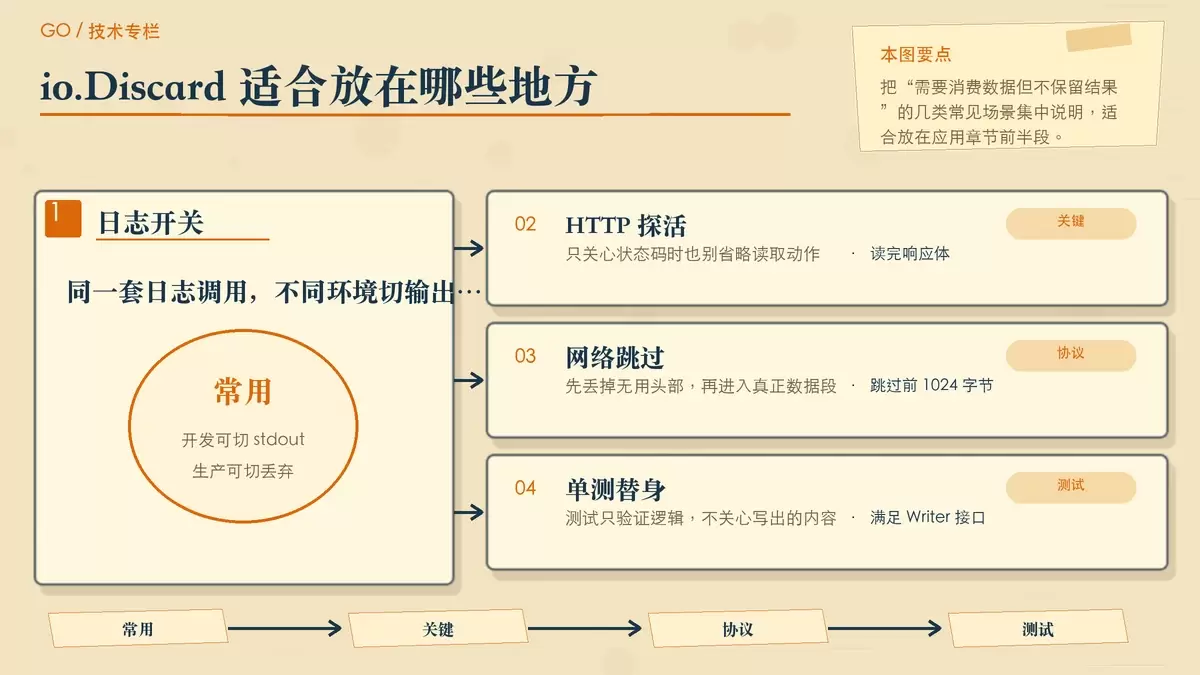
同样的逻辑也常见于以下场景:
- 日志系统需要一个可切换的输出目标
- 网络协议处理中,需要跳过某段不关心的报文内容
- 测试里需要传入
io.Writer,但不希望产生真实副作用
从这个角度看,io.Discard 不是“偷懒”,而是把“我需要消费这段数据,但不需要保留结果”明确写进代码里。
io.Discard 的实现原理与性能点
io.Discard 的实现本身很小,但设计得很到位。它底层使用空结构体,不占额外存储空间:
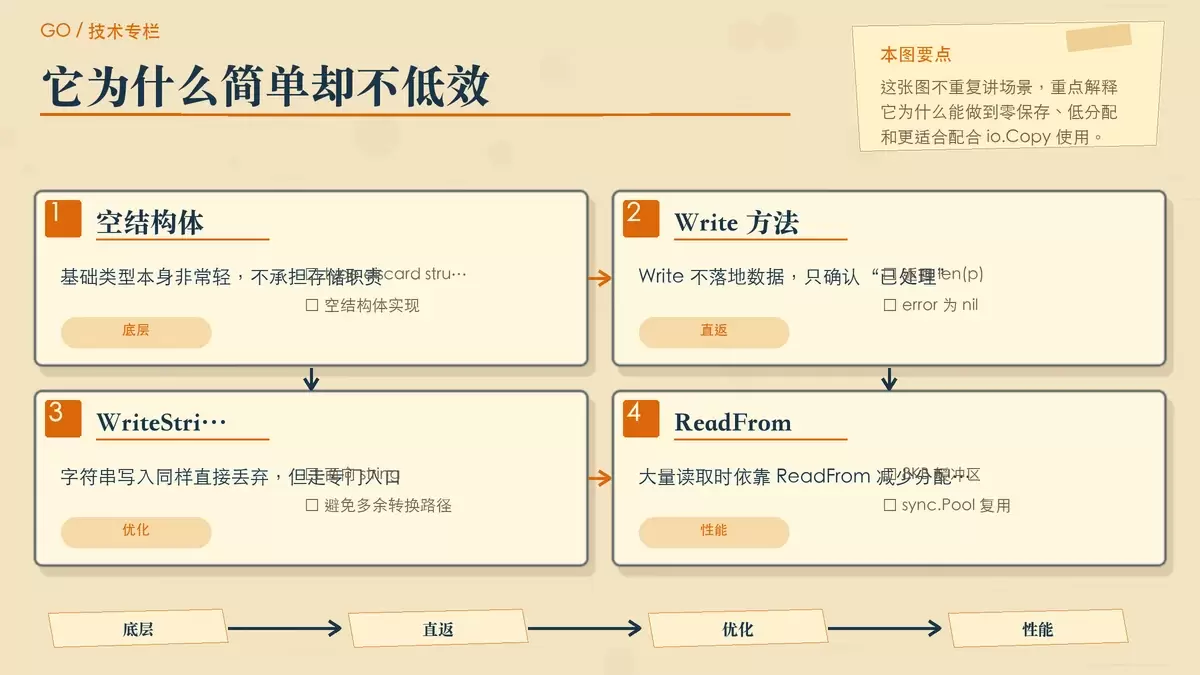
type discard struct{}它至少覆盖了几个关键方法。
Write:收到字节后直接视为写入成功
func (discard) Write(p []byte) (int, error) {
    return len(p), nil
}
这里没有任何真实写入动作,只是告诉调用方:你传来的这些字节已经“处理完了”。对调用侧来说,这就满足了 io.Writer 的契约。
WriteString:针对字符串路径做了专门处理
func (discard) WriteString(s string) (int, error) {
    return len(s), nil
}
逻辑和 Write 一样,依旧是丢弃,只是避免某些场景下多余的转换成本。
ReadFrom:真正影响大流量场景效率的关键
当你使用 io.Copy(io.Discard, reader) 时,性能优势主要来自这里。因为 io.Discard 实现了 ReadFrom,io.Copy 会优先走这条更高效的路径。
var blackHolePool = sync.Pool{
    New: func() any {
        b := make([]byte, 8192) // 8KB缓冲池
        return &b
    },
}

func (discard) ReadFrom(r Reader) (n int64, err error) {
    bufp := blackHolePool.Get().(*[]byte)
    // 读取数据并丢弃
    // ...
    blackHolePool.Put(bufp) // 归还缓冲区
}
这里有两个值得注意的点:
- 使用了固定大小的
8KB缓冲区 - 缓冲区通过
sync.Pool复用,减少频繁分配和回收
结果就是,在需要丢弃大量数据时,它不仅语义清晰,而且通常比你自己手写一套“读出来再扔掉”的循环更省事,也更容易拿到稳定表现。
几个最常见的使用场景
调试日志与生产环境静默输出
日志系统最常见的需求之一,就是在不同环境切换输出目标。开发环境希望看到足够多的调试信息,生产环境则可能希望关掉某些噪声日志,避免性能损耗或敏感信息外泄。
这时可以把日志输出直接指向 io.Discard:
var logger io.Writer

// 开发环境
// logger = os.Stdout

// 生产环境
logger = io.Discard

log.SetOutput(logger)
log.Println("这条调试消息在生产环境中将被丢弃")
这种写法的好处是,调用日志的代码不需要改,真正变化的只有输出目标。对于依赖注入、环境切换、可配置输出这类需求,它比到处写条件分支更干净。
网络编程里跳过无用数据
在 TCP 或其他流式协议处理中,有时你需要先跳过一段不关心的数据,比如固定长度头部、探测信息或冗余内容。与其先读到临时缓冲区再忽略,直接复制到 io.Discard 更直白:
// 建立网络连接
conn, err := net.Dial("tcp", "example.com:80")
if err != nil {
    log.Fatal(err)
}
defer conn.Close()

// 丢弃前1024字节(如协议头部)
bytesToDiscard := int64(1024)
_, err = io.CopyN(io.Discard, conn, bytesToDiscard)
if err != nil {
    log.Fatal(err)
}

// 处理真正需要的数据
这里的重点不是“少存了一份数据”,而是把“主动跳过前 1024 字节”的意图表达得足够明确。后续接手代码的人,一眼就能看出这段数据是有意丢弃,而不是漏处理。
HTTP 请求中只看状态码,不消费内容
这是 io.Discard 最容易被低估、但实际收益很高的场景之一。健康检查、探活请求、轻量状态判断,都可能只关心返回状态是否正常。
示例代码如下:
func healthCheck() {
    // 发送健康检查请求
    resp, err := http.Get("http://127.0.0.1:5555/healthz")
    if err != nil {
        panic(fmt.Sprintf("请求失败: %v", err))
    }
    defer resp.Body.Close()

    // 丢弃响应体
    _, _ = io.Copy(io.Discard, resp.Body)

    // 只检查状态码
    if resp.StatusCode != http.StatusOK {
        panic(fmt.Sprintf("非预期状态码: %d", resp.StatusCode))
    }
    fmt.Println("健康检查通过")
}
这里的关键动作其实是两步:
defer resp.Body.Close()负责关闭响应体io.Copy(io.Discard, resp.Body)负责把内容读取完
如果只关闭、不读取,连接复用的效果可能会打折;而把响应体完整读掉,即使内容最终不保留,也能让底层连接管理更符合预期。
单元测试中的无副作用 Writer
测试代码里经常会遇到这种函数签名:业务逻辑需要传入一个 io.Writer,但当前用例并不关心输出内容。此时使用 io.Discard,可以把测试聚焦在真正要验证的行为上。
func TestSomeFunction(t *testing.T) {
    // 假设SomeFunction会写入数据到传入的io.Writer
    // 在测试中,我们不需要这些数据,所以用io.Discard替换
    SomeFunction(io.Discard)
    // 检查其他逻辑而不是输出内容
}
相比手写一个空 Writer,标准库自带的 io.Discard 更简洁,也避免了重复造轮子。对读代码的人来说,它表达的是一种约定俗成的意图:输出存在,但当前场景不关心。
什么时候优先用 io.Copy(io.Discard, reader)
如果你的目标是丢弃一小段已经拿到手的数据,直接写给 io.Discard 就够了;但如果目标是从某个 reader 持续读取大量内容并丢弃,优先考虑:
io.Copy(io.Discard, reader)原因主要有三点:
io.Discard实现了ReadFrom,io.Copy会优先走优化路径- 底层使用固定大小的
8KB缓冲区,并通过sync.Pool复用 - 代码更短,语义更清楚,也通常比自定义读取循环更稳妥
换句话说,io.Discard 的最佳用法不只是“当个黑洞”,而是配合标准库现成的 I/O 管道一起用。这样既保留了可读性,也把性能细节交给标准库处理。
可以把它当成 Go 里最省心的“空输出”工具
io.Discard 看上去只是一个很小的标准库对象,但它解决的是一类很常见、也很容易写得不够优雅的问题:你必须消费数据、必须提供输出接口,但并不需要任何结果。
在实际项目中,它至少有几项很稳定的价值:
- 实现“有接口、无输出”的最小成本方案
- 在 HTTP 等场景中帮助资源按预期释放或复用
- 通过标准库现成优化减少额外内存分配
- 让代码意图比“读了但没用”“写了个空实现”更清晰
如果你以后在 Go 代码里遇到“这段数据得处理,但结果不需要”的场景,先想一想 io.Discard。多数时候,它就是最合适、也最标准的答案。









