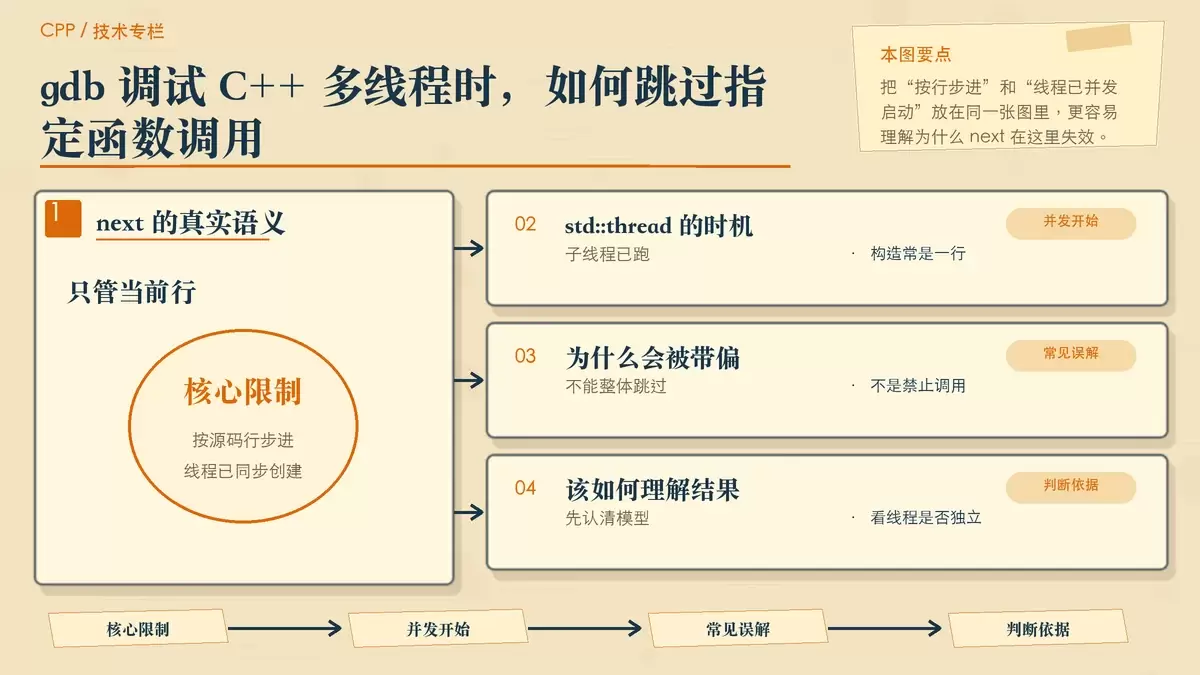
gdb 调试 C++ 多线程时,如何跳过指定函数调用
在 GDB 调试 C++ 多线程程序时,很多人会以为 `next` 可以像单线程那样跳过函数调用,但 `std::thread` 启动线程后,子线程会立即并发运行,这条路行不通。本文把“跳过线程函数”拆成断点控制、函数退出和线程调度三件事,说明哪些做法有效,哪些只是表面绕开。
2026-08-24
48


在 GDB 调试 C++ 多线程程序时,很多人会以为 `next` 可以像单线程那样跳过函数调用,但 `std::thread` 启动线程后,子线程会立即并发运行,这条路行不通。本文把“跳过线程函数”拆成断点控制、函数退出和线程调度三件事,说明哪些做法有效,哪些只是表面绕开。
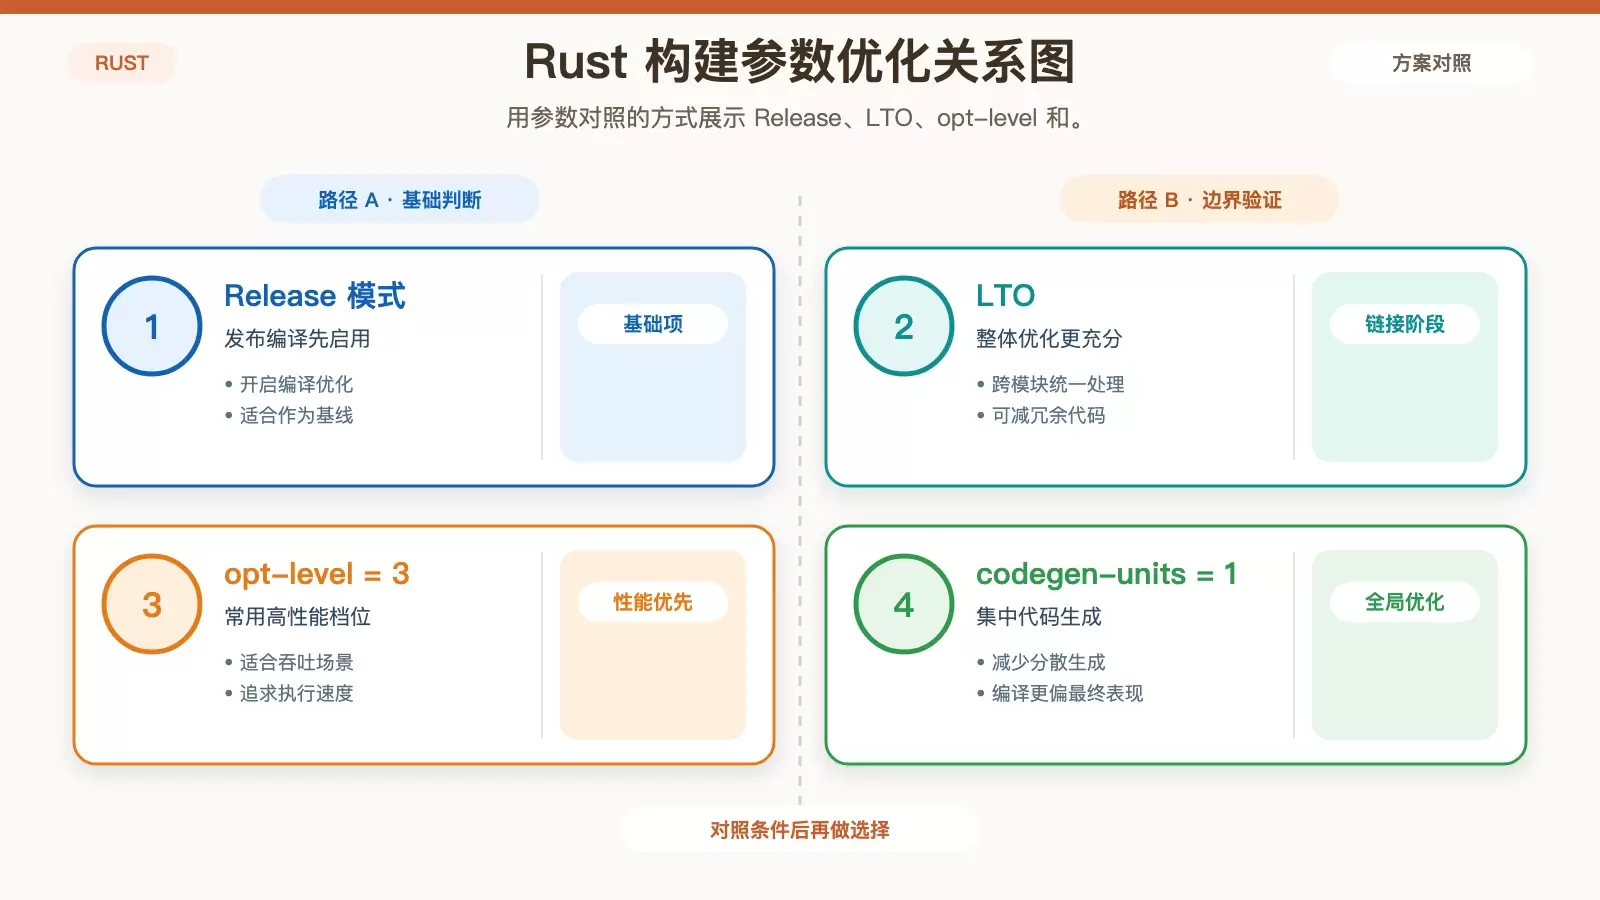
在 Debian 上做 Rust 内存优化,关键不只是“换个库”或“开发布模式”,而是把编译参数、分配器、数据结构、分配次数、并发方式和系统设置串成一条链路。本文按实操顺序梳理这些手段,并给出适用场景与判断依据。
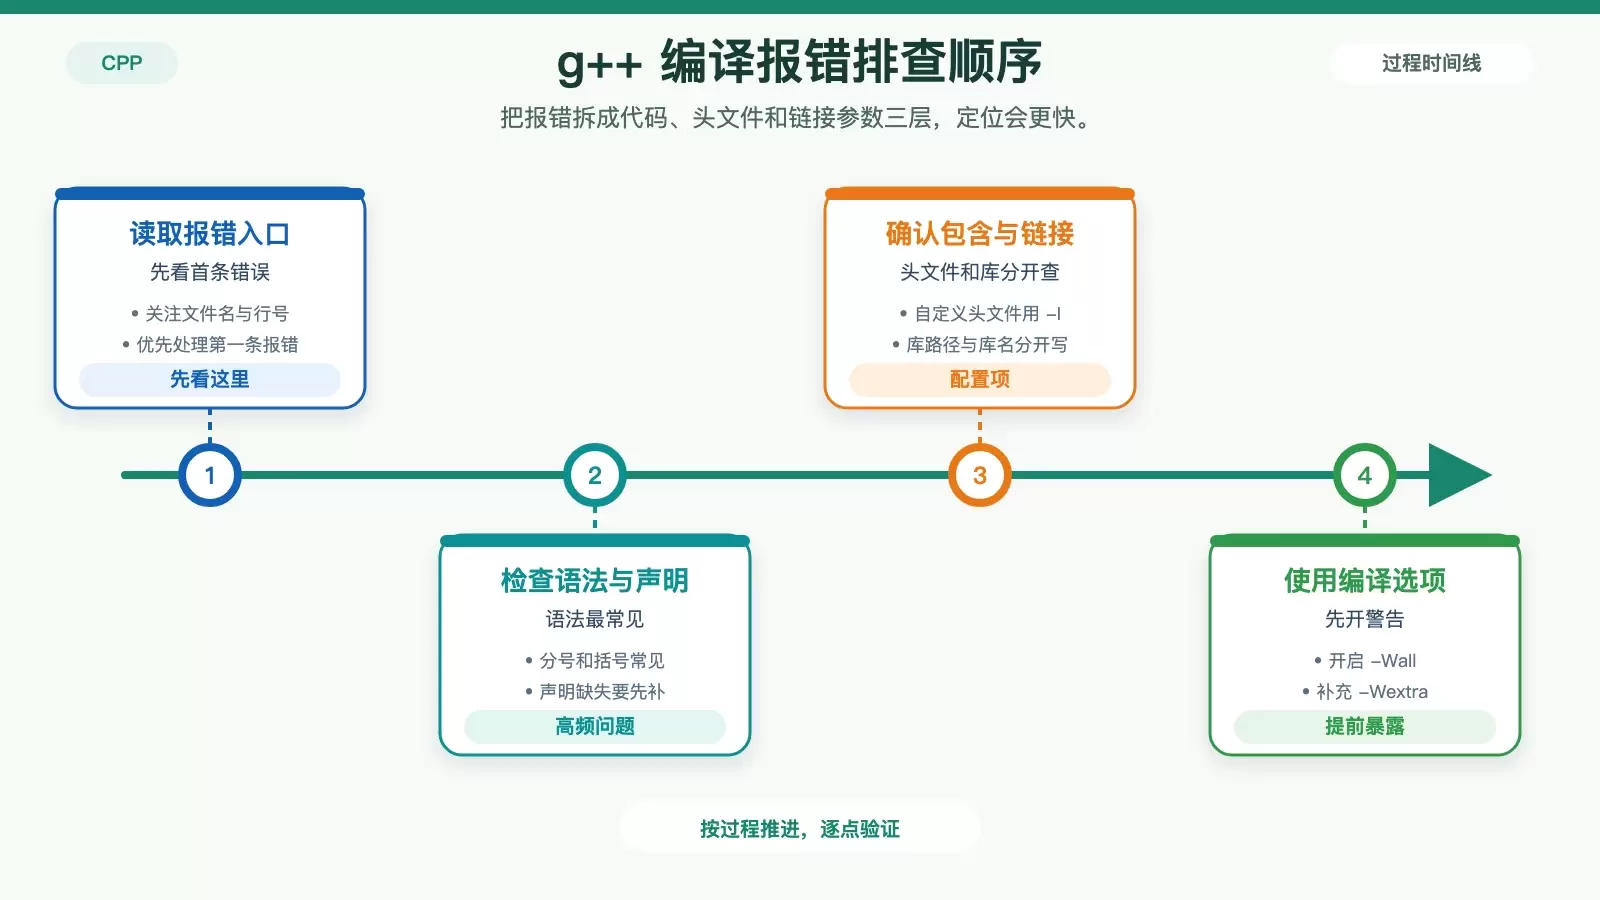
在 Linux 下用 g++ 编译 C++ 程序时,报错并不一定复杂,关键是按顺序定位:先读懂错误位置和类型,再排查语法、类型、头文件、库链接与编译器版本。本文结合一条常见的 `cout was not declared in this scope` 报错,整理出一套更适合日常排障的处理思路。
CentOS 上的 PHPStorm 卡顿,往往不只是 IDE 本身的问题,还可能和系统服务、磁盘调度、PHP 运行环境以及 JVM 参数有关。本文按“先系统、再 PHP、后 IDE、最后硬件”的顺序整理可直接落地的优化项,方便你逐项排查并判断哪些调整最值得优先做。
这篇文章围绕“套接字为什么还能配合标准 I/O 使用”展开,梳理标准 I/O 的性能收益、缓冲机制与局限,并结合 `fdopen`、`fileno` 以及回声客户端/服务端示例,说明它在网络编程中的适用场景和常见注意点。
在 Ubuntu 上分析 JS,尤其是 Node.js 应用的性能问题,关键不在“看日志”,而在把日志、系统指标和分析工具串成一条排查链。本文按日志定位、字段提取、瓶颈识别到持续监控的顺序,整理出一套可直接落地的方法。
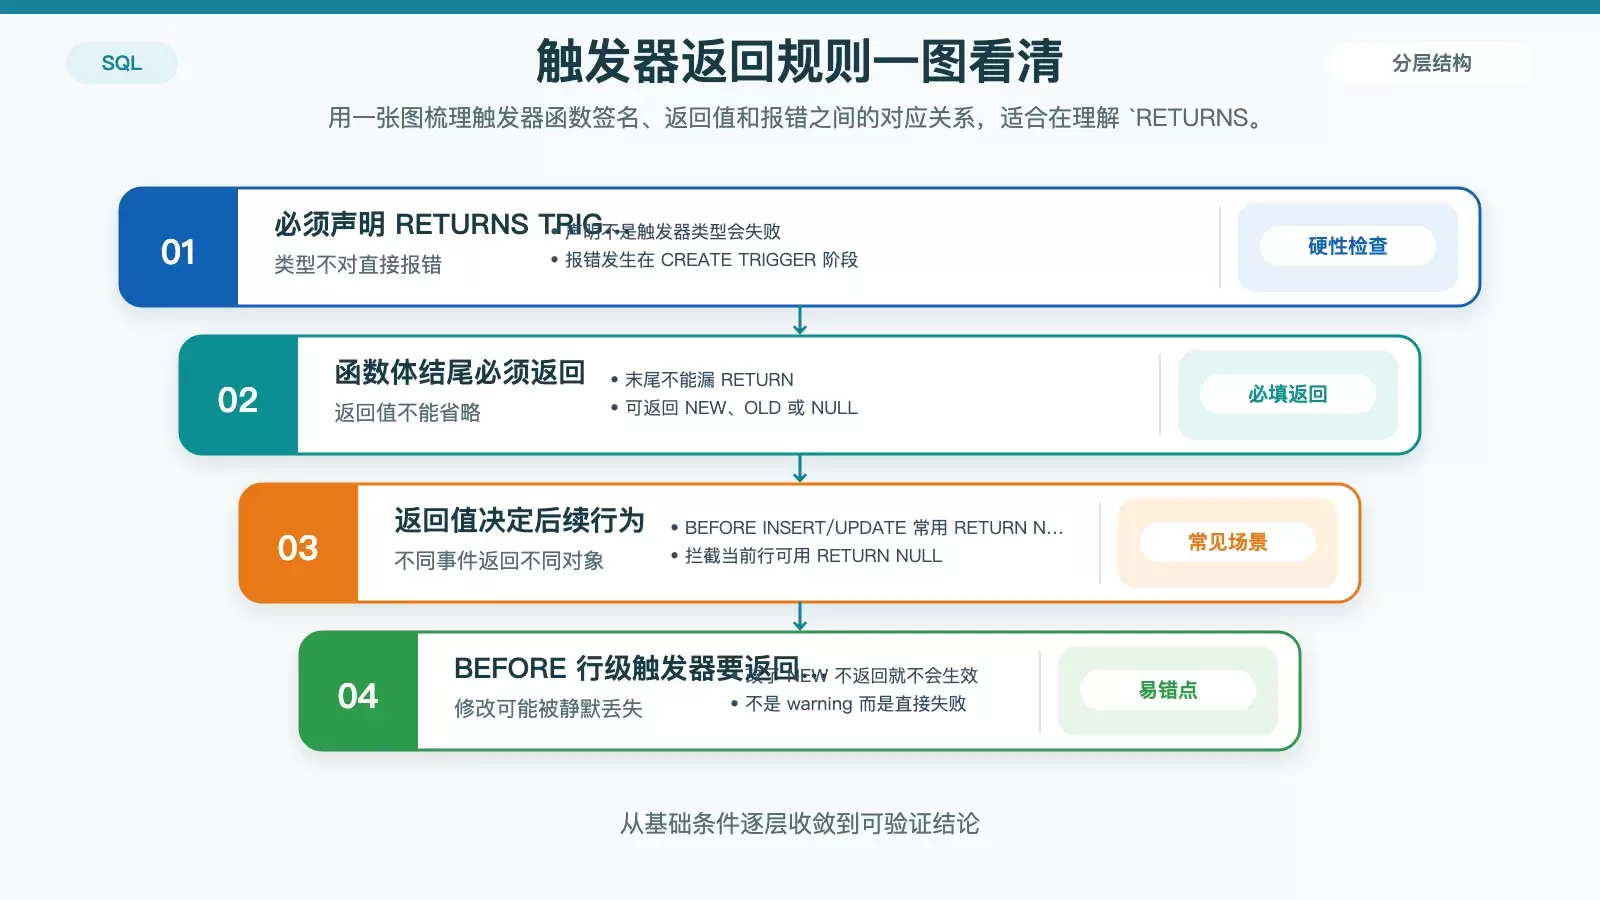
在 PostgreSQL 14 里,SQL 触发器函数有几条不能踩的硬规则:返回类型必须是 `TRIGGER`,结尾必须返回 `NEW`、`OLD` 或 `NULL`;动态 SQL 里表名、列名要用 `format('%I', ...)`;`NEW` 和 `OLD` 只能按 `TG_OP` 对应场景访问。再加上行级触发器在批量更新时的性能成本,这些细节决定了触发器是稳定运行还是一上生产就报错。
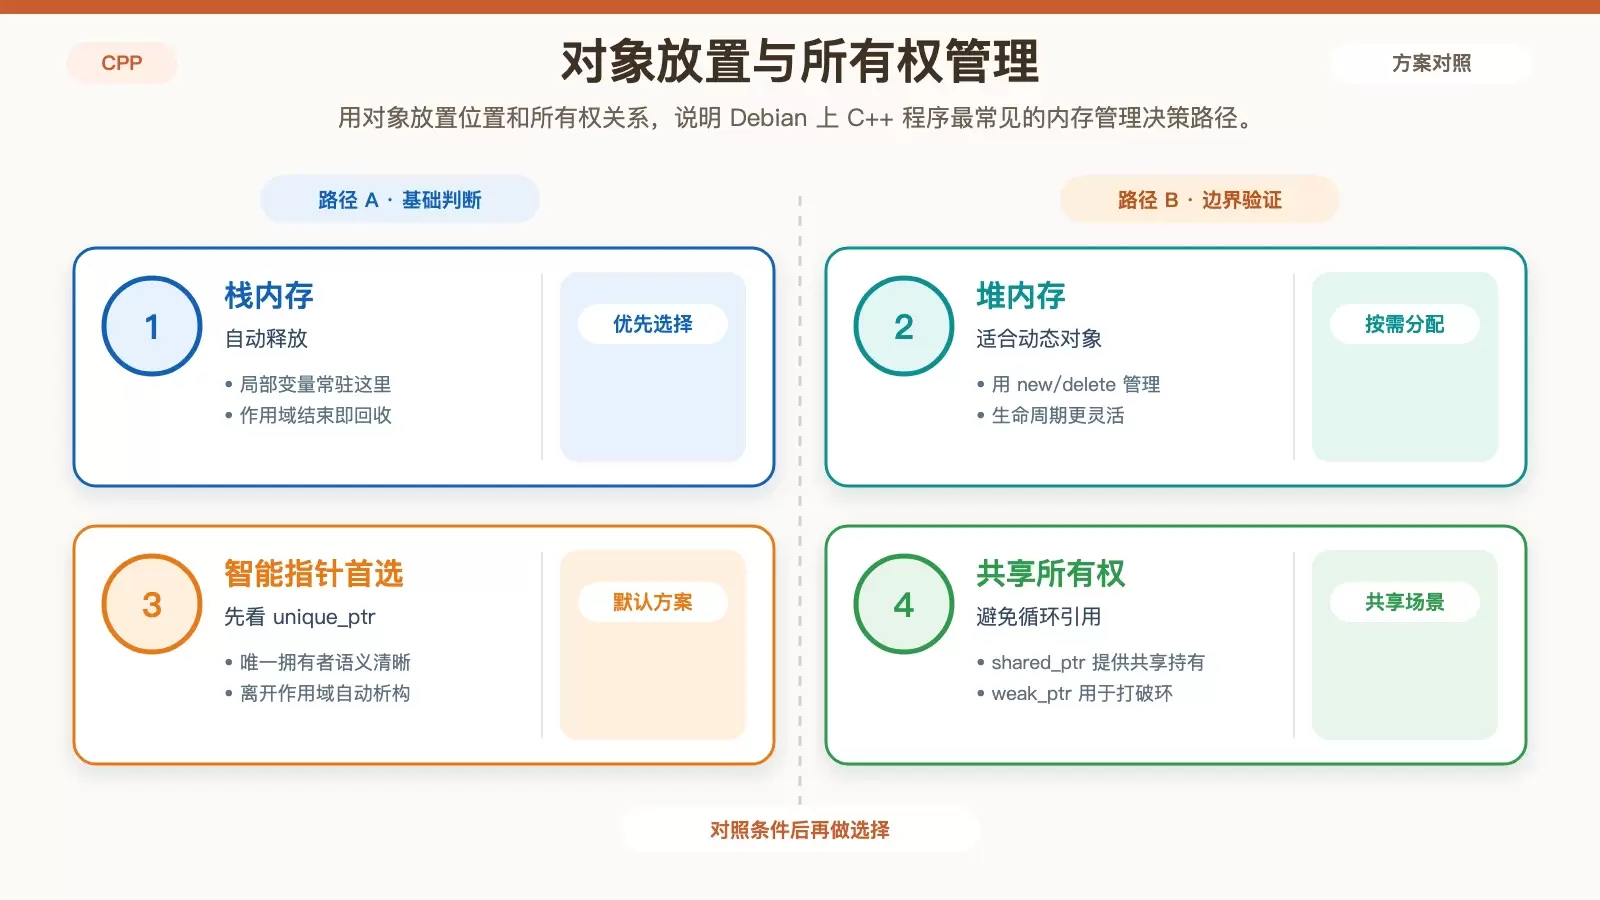
Debian 上的 C++ 内存管理并不只是一组语法用法,真正关键的是把语言特性、系统机制和调试工具配合起来。本文从堆栈、智能指针、内存池,到 Valgrind、AddressSanitizer、NUMA 和大页支持,梳理在 Debian 环境里兼顾安全性与性能的常见做法。
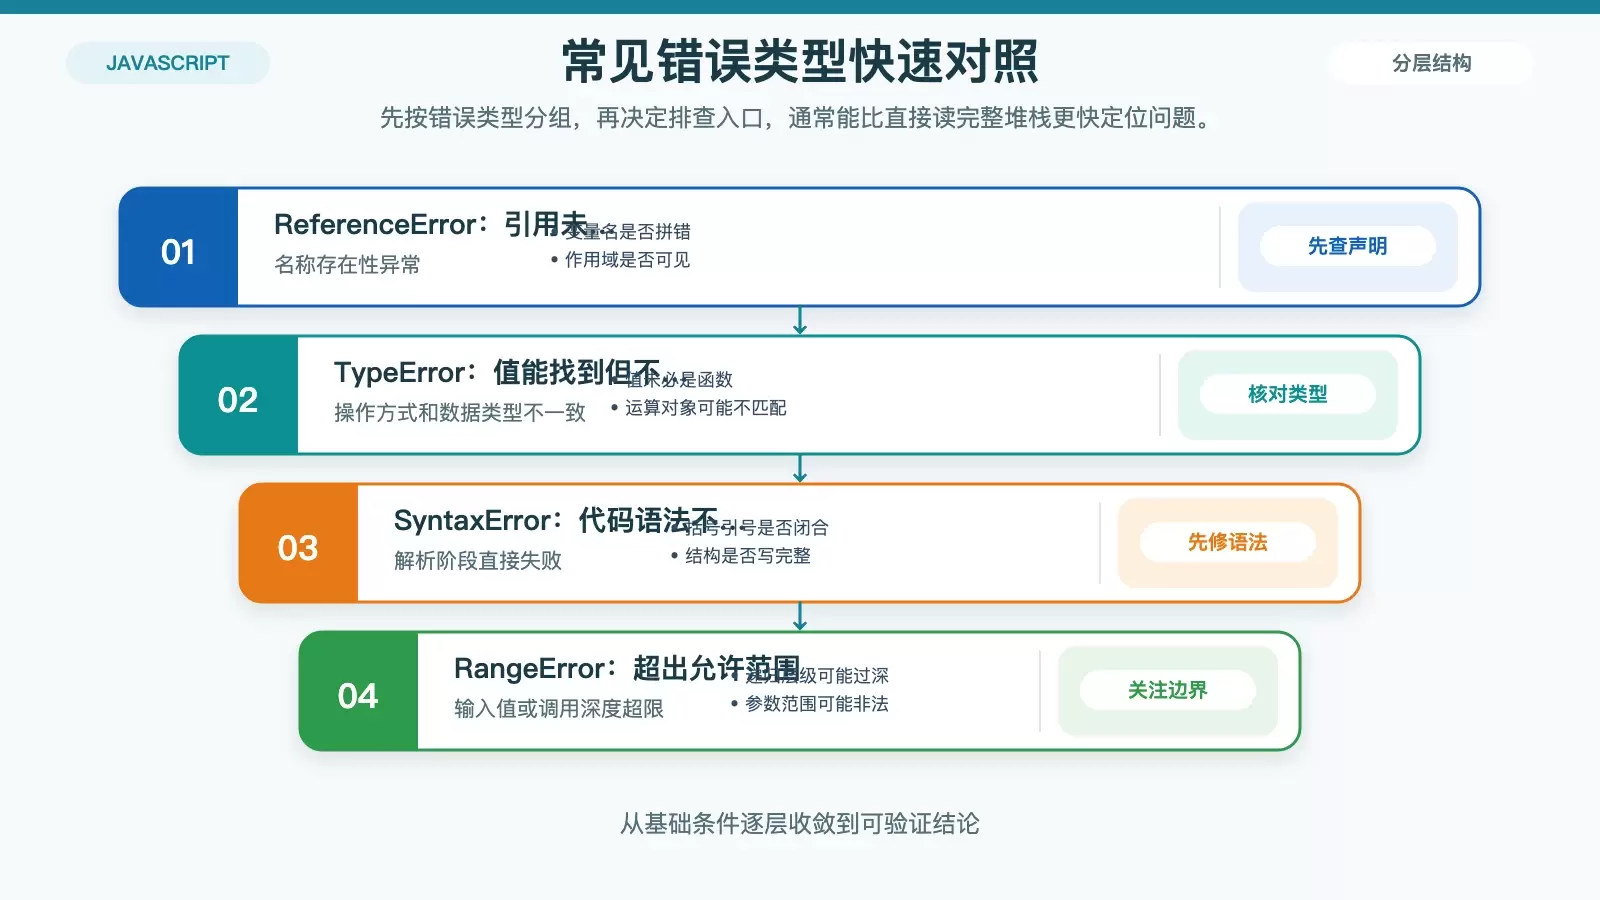
在 Ubuntu 环境里排查 JavaScript 日志,先看懂错误类型往往比盲目改代码更有效。本文把日志中最常见的几类错误码拆开说明,并按“未定义、类型不匹配、语法问题、范围越界、URI 编码异常、通用错误”来梳理判断方法,帮助你更快定位报错行和修复方向。
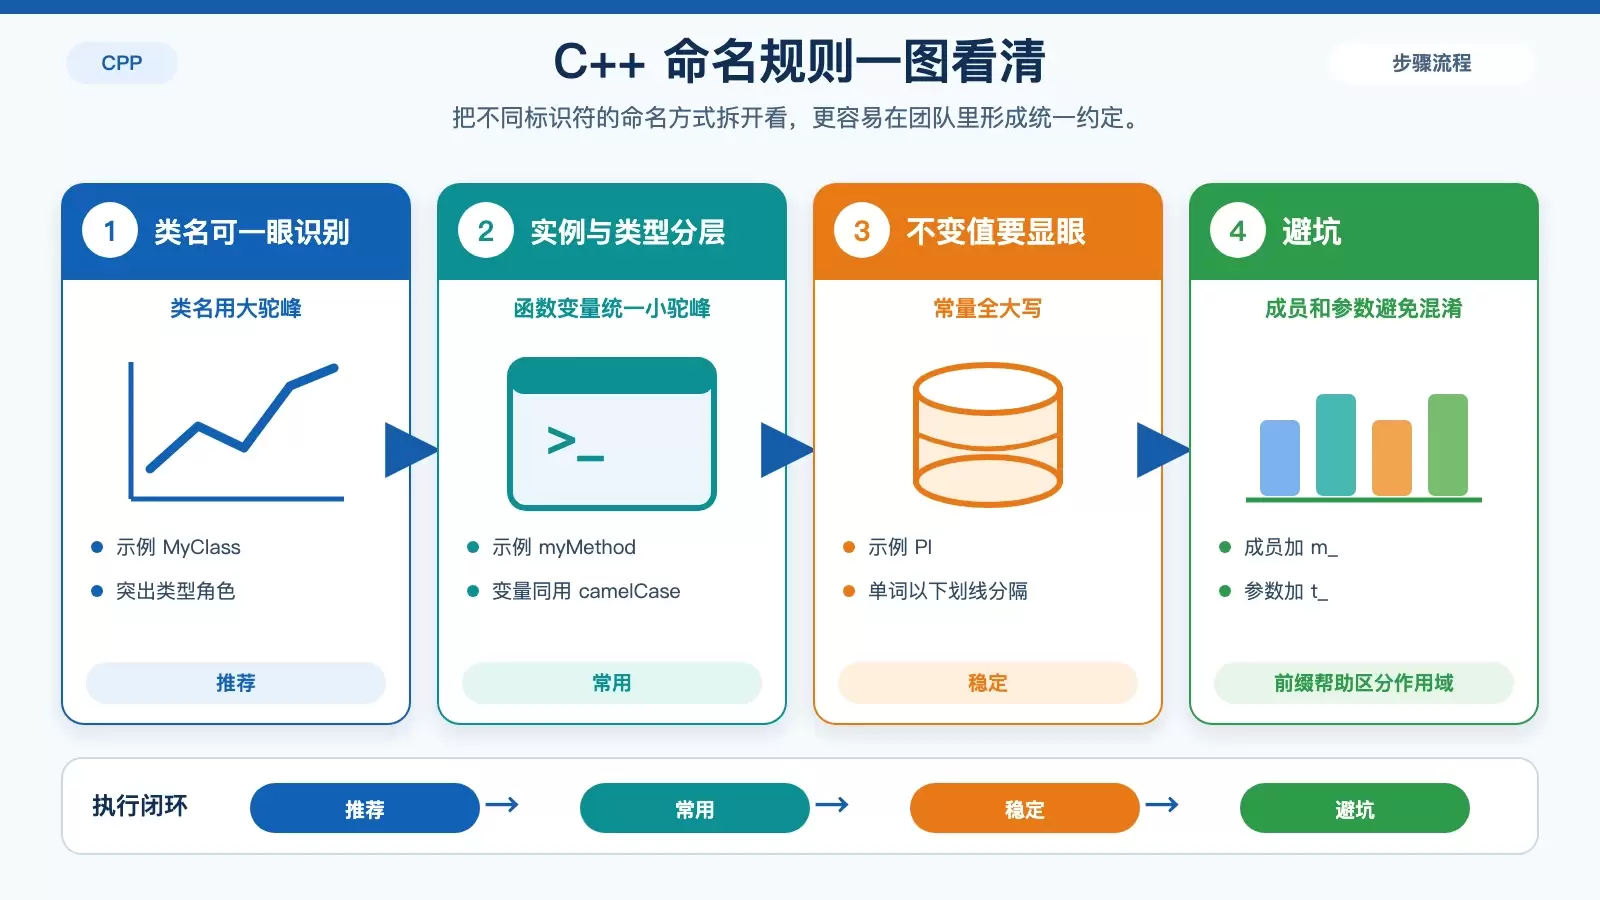
Debian 的 C++ 代码风格规范并不追求花哨,而是把命名、排版、关键字选择和项目组织统一下来,减少沟通和维护成本。本文按“读代码时最容易出问题的地方”重新整理这些规则,便于快速判断哪些做法值得直接落到团队规范里。
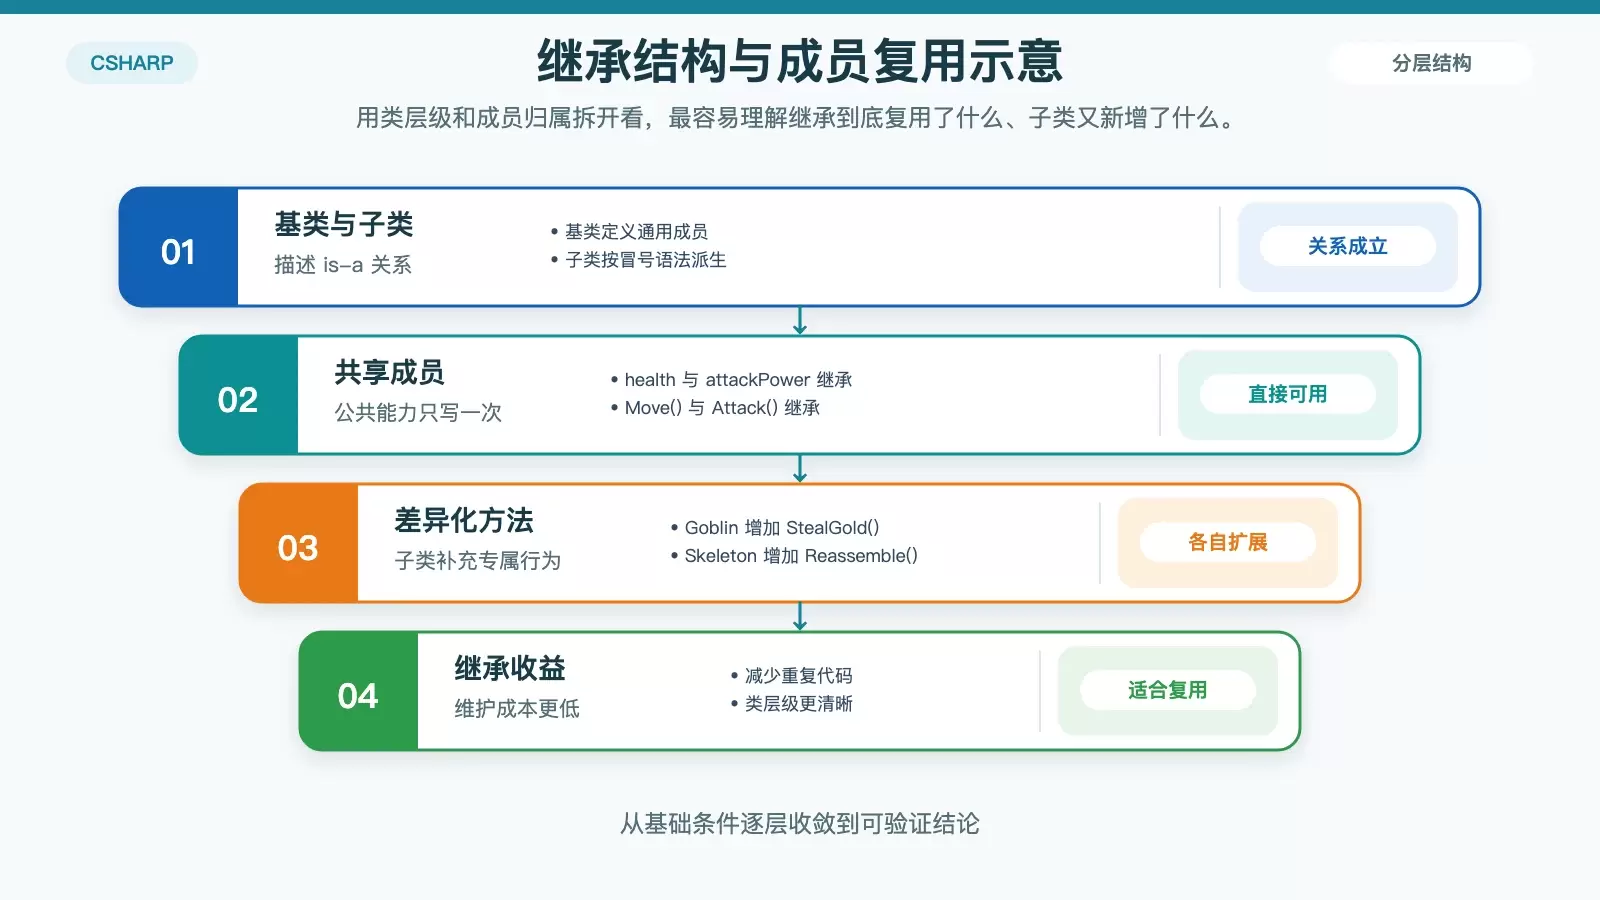
这篇文章用一组敌人类示例,把 C# 里的继承、多态以及 `abstract`、`sealed`、`new` 的区别串起来讲清楚。你可以据此判断哪些场景该复用基类能力,哪些场景该用重写实现真实多态,避免把方法隐藏误当成动态分派。
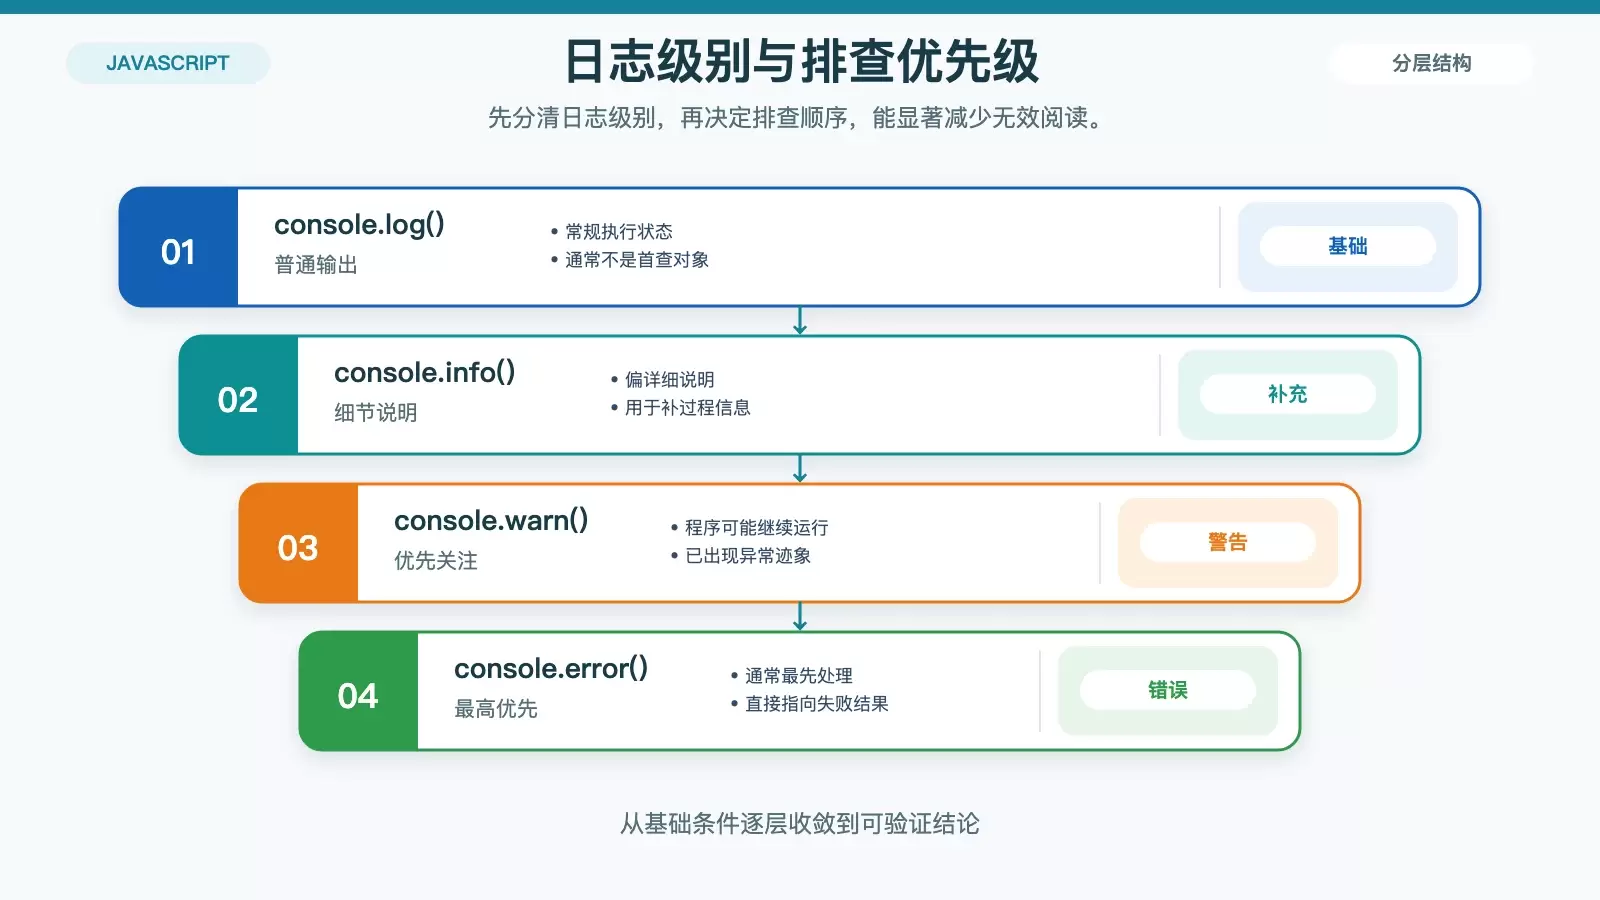
面对 Node.js 应用里层层叠叠的日志输出,关键不是逐字硬读,而是先建立一套筛选顺序。本文把原本分散的九个处理动作整理成一条可执行路径,帮助你从日志级别、来源、堆栈到上下文与工具选择,逐步判断问题位置并进入调试验证。