Python shutil标准库文件操作详解
本文详细介绍Python标准库shutil的高级文件操作功能,涵盖copyfile、copytree、move及rmtree等常用方法。解析参数如follow_symlinks的作用,并讲解make_archive与unpack_archive在压缩归档中的应用,助力高效文件管理。
2026-10-13
7

本文详细介绍Python标准库shutil的高级文件操作功能,涵盖copyfile、copytree、move及rmtree等常用方法。解析参数如follow_symlinks的作用,并讲解make_archive与unpack_archive在压缩归档中的应用,助力高效文件管理。
本文介绍使用Python批量将.dat文件后缀改为.txt的方法。针对原代码仅支持程序与文件同目录的局限,详细解析了通过拼接绝对路径解决跨目录重命名失败的问题。提供完整代码示例,涵盖路径拼接、文件列表获取及os.rename的正确用法,帮助开发者实现灵活的文件批量处理。
本文介绍在Python爬虫开发中如何自动创建目标文件夹。通过os.path.exists判断路径存在性,若不存在则使用os.makedirs创建多级目录。同时补充了Python中处理文件名、后缀、目录分割及遍历重命名等常用文件操作技巧,帮助开发者更高效地管理爬虫数据存储。
本文介绍利用Python的multiprocessing模块实现文件夹内所有文件的并行复制功能。通过创建子进程处理单个文件读写,并使用Queue队列统计已完成任务数,实时计算并打印复制进度百分比,最终实现高效且可视化的文件传输过程。
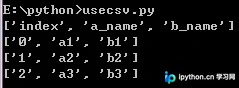
本文介绍Python中如何使用csv模块进行CSV文件的读写操作。重点解析写入时因换行符导致的多余空行问题,并提供通过设置newline=''参数的解决方案。包含完整的写入与读取代码示例,帮助开发者快速掌握Python处理CSV数据的核心技巧。
本文介绍 Python 中读取文件并替换字段的三种常见方法。第一种通过新建文件写入实现字符串替换;第二种利用 re 模块进行正则替换并输出到新文件;第三种演示如何在原文件中通过 seek 定位指针实现原地修改,同时指出长度不一致时的潜在问题。
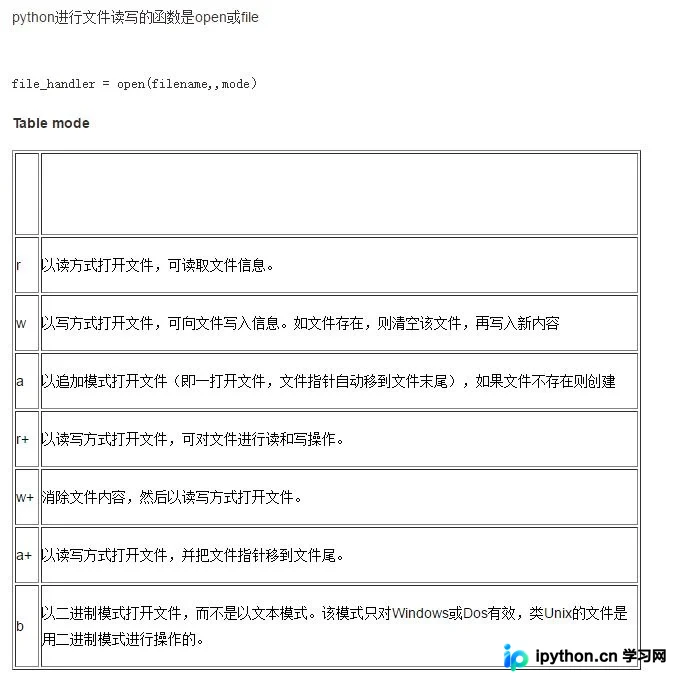
本文介绍在 Python 中如何高效地按行读取文件内容,并通过列表索引修改特定行的数据,最后将更新后的内容写回原文件。主要涉及 open 函数的读写模式、readlines 获取行列表以及 writelines 批量写入的操作流程,适用于需要局部更新文本文件的场景。
本文介绍如何在Python中按名称顺序读取文件夹下的文件。通过os.listdir获取文件列表并使用sort()排序,可确保按字母或数字顺序处理文件。代码示例展示了路径拼接与遍历过程,适用于需要按序处理文件的场景。
本文介绍如何使用Python的xlrd库读取Excel工作表数据,并通过遍历行列将内容逐行写入TXT文件。示例代码展示了如何获取工作表信息、遍历单元格数据以及处理文件路径,适合需要批量转换Excel数据为文本格式的用户参考。
本文介绍Python中csv模块的使用,重点解决写入CSV文件时自动产生多余空行的问题。通过指定newline=''参数,可有效避免空行,确保数据格式正确。
本文系统梳理了Python中处理CSV文件的两种主流方式:内置csv模块与第三方Pandas库。详细解析了csv.writer、csv.DictWriter等核心类的创建与读写方法,涵盖数据写入、读取及方言注册;同时深入讲解Pandas中read_csv、to_csv等导入导出接口,以及数据筛选、清洗、分组聚合、合并与统计等高频操作,助力开发者高效处理结构化数据。
本文介绍如何使用Python将两个CSV文件的数据进行合并,重点演示追加模式。通过直接读取源文件内容并写入目标文件,实现快速的数据整合。文中提供了具体的代码示例及操作前后的数据对比,帮助读者掌握这一基础且实用的数据处理技巧。