

Python查找文件中包含中文的行方法
本文介绍利用Python脚本从文本文件中筛选包含中文字符行的方法。通过结合文件读写操作与正则表达式匹配Unicode范围,实现高效的内容过滤。文中提供了完整代码示例,解析了with语句的资源管理优势及正则匹配原理,适用于多语言版本处理场景。
2026-10-13
6

本文介绍利用Python脚本从文本文件中筛选包含中文字符行的方法。通过结合文件读写操作与正则表达式匹配Unicode范围,实现高效的内容过滤。文中提供了完整代码示例,解析了with语句的资源管理优势及正则匹配原理,适用于多语言版本处理场景。
本文详解Python中字典与JSON的核心区别,指出JSON强制双引号而字典灵活,并解析传输时需序列化。重点区分json.dumps/loads处理字符串与json.dump/load操作文件的场景,通过代码示例展示字典转JSON及文件读写的具体实现,帮助开发者正确进行数据序列化与持久化。
本文介绍如何使用 PHP 接收前端提交的 Base64 图片数据,并自动将其解码后保存到服务器指定的文件夹中。代码包含获取图片类型、检查并创建目录、生成唯一文件名及写入文件的完整逻辑。
本文详解 Python 模块导入机制,指出模块需置于 sys.path 指定目录方可被识别。针对运行脚本时常见的文件句柄找不到问题,提供了两种解决方案:使用绝对路径或调整执行目录。建议采用绝对路径以确保路径引用的稳定性,避免环境变动导致的引用失效。
本文介绍使用Python读取TXT文件并按指定字符串提取所在行的方法。通过逐行读取文件内容,利用split()按空格分割字符段,并遍历列表判断指定索引位置的字符串是否匹配目标值,从而筛选并输出符合条件的行。该方法适用于结构化的文本数据处理场景。
本文介绍如何利用Python脚本,结合pandas读取包含图片类别信息的CSV表格,并通过os和shutil库自动创建文件夹及移动图片。该方法适用于需要将大量图片按预设标签(如0-19类)批量整理至独立目录的场景,代码已优化修正,可直接参考使用。
本文介绍在Python中创建文件时,如何通过检查同名文件并使用递归函数自动添加编号后缀来避免覆盖已有数据。核心方案利用os.path.isfile判断存在性,并通过可变列表传递计数器实现动态命名,确保新文件拥有独立名称。
本文通过实例对比Python中两种常见的文件读取方式:逐行迭代读取与readlines一次性读取。测试结果显示,逐行遍历虽然内存占用低,但耗时较长;而使用readlines将内容一次性加载至列表后处理,在速度上具有明显优势。文章提供了具体的代码实现及性能差异说明,帮助开发者根据实际需求选择高效的文件读取策略。
本文介绍如何使用Python生成符合Gnuplot格式要求的绘图数据。通过Python的文件写入功能,生成包含x和y坐标值的文本文件,供Gnuplot直接读取绘图。
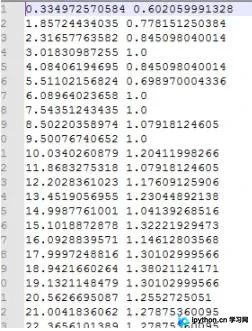
本文详细介绍在Python中如何新建文件夹及复制文件夹内所有内容。通过os模块的os.path.exists和os.makedirs函数实现路径判断与多级目录创建,利用shutil模块的copytree函数完成文件夹内容的完整拷贝。提供具体代码示例与参数说明,帮助开发者快速掌握相关操作。
本文介绍利用Python和ArcPy遍历指定目录下的MDB文件,并从中提取特定FeatureClass名称的方法。通过遍历文件列表,筛选MDB文件,并构造FeatureClass路径,实现对地理数据的高效处理。
本文提供一段Python代码,用于将指定目录下包含Detect_0文件夹中的source与mask图片批量复制到新目录,并按顺序重命名。通过遍历1至22号文件夹,程序自动清空并重建目标路径,依次复制源图与掩码文件,保持.bmp格式,实现自动化整理。