

Python正则表达式re.group()方法详解与常见错误处理
本文详细解析Python中正则表达式模块re的group()方法。通过实例说明如何利用括号进行分组匹配,解释group()、group(0)与group(n)的区别。重点分析匹配失败返回None导致的AttributeError,以及未定义分组引发的IndexError,帮助开发者避免常见编码错误。
2026-10-16
5

本文详细解析Python中正则表达式模块re的group()方法。通过实例说明如何利用括号进行分组匹配,解释group()、group(0)与group(n)的区别。重点分析匹配失败返回None导致的AttributeError,以及未定义分组引发的IndexError,帮助开发者避免常见编码错误。
本文详解Python标准库ElementTree处理XML文件的方法,包括ElementTree对象的创建、Element对象的常用属性与操作方法。重点分析解析非法XML时常见的ExpatError异常,如no element found、mismatched tag及not well-formed错误,并提供对应的代码示例与排查建议。
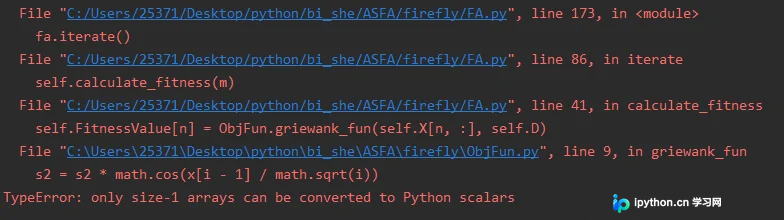
本文介绍在 Python 中将 numpy.ndarray 数据转换为 int 类型的方法。通过遍历数组元素,利用 list() 提取值后调用 tolist() 实现类型转换。针对出现的 only size-1 arrays can be converted to Python scalars 错误,分析原因为数据类型未正确转换,并提供 list(m)[0].tolist() 的解决方案,确保数据成功转为标准 Python int 类型。
本文详细记录在Windows 64位系统中为Python配置OpenGL环境的完整过程。针对直接通过pip安装导致的32位库冲突及NullFunctionError错误,提供了从官网下载对应版本whl文件并通过命令行安装的解决方案,同时包含在PyCharm中正确切换Python解释器路径的方法及测试代码。
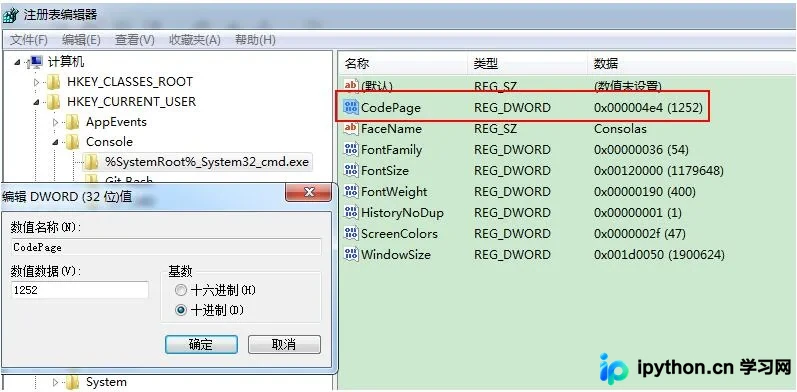
本文介绍了Python执行过程中遇到的unknown encoding: idna及cp65001 LookupError问题。通过导入encodings.idna模块或修改系统注册表CodePage值,可有效解决此类编码识别失败导致的脚本运行中断,适用于fetch v8等工具执行场景。
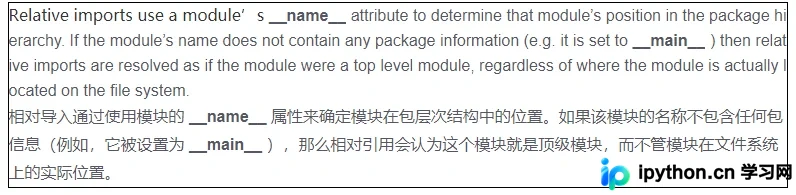
本文深入解析Python中模块相互引用时常见的ModuleNotFoundError及相对导入报错。通过构造测试案例,详细阐述了__main__命名空间对相对路径的影响,并对比了绝对路径与相对路径的查找机制。文章提供了在src同级目录创建入口文件、修改sys.path以及调整import语句等多种解决方案,帮助开发者解决模块导入时的路径与层级混乱问题。
本文介绍在 PyCharm 中利用 Tab 和 Shift+Tab 快捷键实现代码块的多行批量缩进与反向缩进操作。针对因混用 Tab 和空格导致的 Inconsistent indentation 报错,建议统一使用 Tab 重新缩进代码以解决兼容性问题,避免混用带来的潜在风险。
本文解决Python脚本中执行Shell命令无法获取返回值的问题。通过对比os.popen、subprocess和commands模块,分析因环境变量缺失导致命令未找到的原因,并给出使用绝对路径执行非系统自带工具(如supervisorctl)的解决方案。
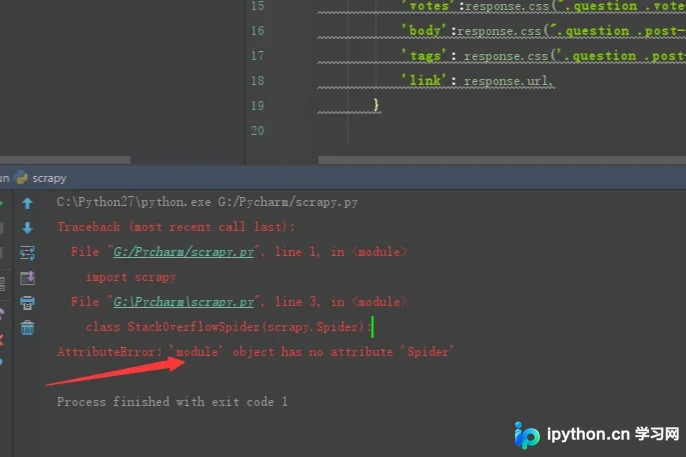
本文针对Python中使用Scrapy框架搭建爬虫时遇到的报错问题,深入分析了错误原因。核心问题在于用户自定义文件命名为scrapy.py,导致与Scrapy官方包名冲突,进而引发Spider属性查找错误。文章提供了具体的解决步骤和命名规范建议,帮助开发者快速定位并修复此类常见搭建错误,确保爬虫项目正常运行。
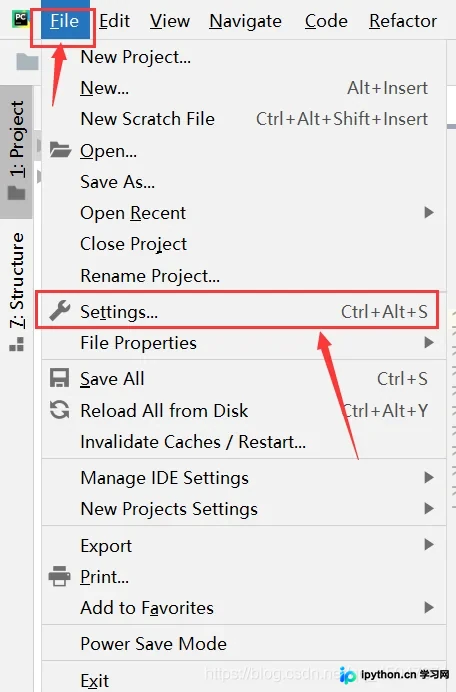
本文解决PyCharm中pip已安装第三方库但import时仍标红的问题。提供两种方案:一是重启PyCharm刷新索引;二是通过Project Interpreter手动搜索并重新Install Package,直至提示安装成功。
本文详细解析Python在服务器部署时常见的ModuleNotFoundError报错原因,重点介绍利用sys.path.append()和sys.path.insert()动态修改搜索路径的方法。通过具体代码示例,说明如何确保服务器正确识别本地自定义包,解决因路径差异导致的模块导入失败问题。
本文深入解析Python中循环导入(Circular Import)的成因,展示A模块与B模块相互引用导致的ImportError错误。同时提供两种核心解决策略:通过分层设计降低耦合度,以及在函数内部延迟导入。此外,文章还补充了Python包的安装、模块的标准引入方式及文件级导入技巧,帮助开发者规避常见陷阱。