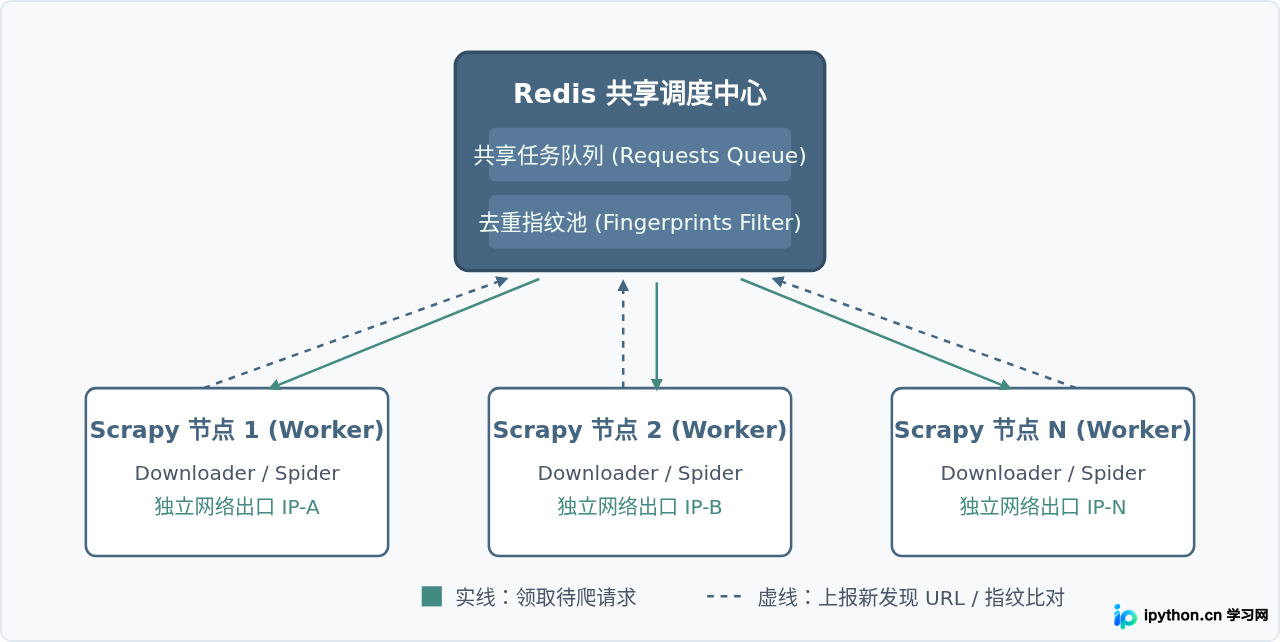
《Python3网络爬虫开发实战》与Scrapy相关书籍对比:哪本更适合进阶?
深度对比《Python3网络爬虫开发实战》与Scrapy专著的知识体系、技术侧重点与进阶场景,从反爬攻防到高并发采集架构,帮助爬虫开发者精准选书。
2026-11-01
25

深度对比《Python3网络爬虫开发实战》与Scrapy专著的知识体系、技术侧重点与进阶场景,从反爬攻防到高并发采集架构,帮助爬虫开发者精准选书。
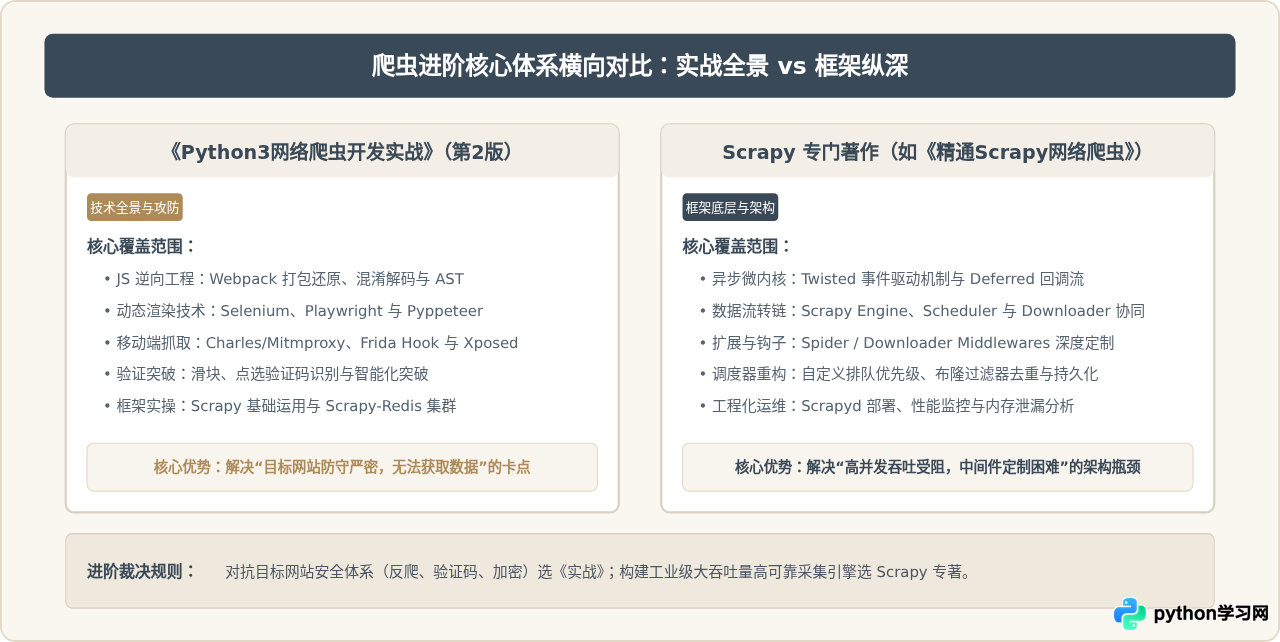
本文系统讲解如何使用Scrapy框架构建稳定、高效的Python数据抓取项目。内容涵盖虚拟环境搭建、项目骨架初始化、数据提取与清洗管道编写、中间件反爬调优,以及基于Redis的分布式集群部署与运维实践。
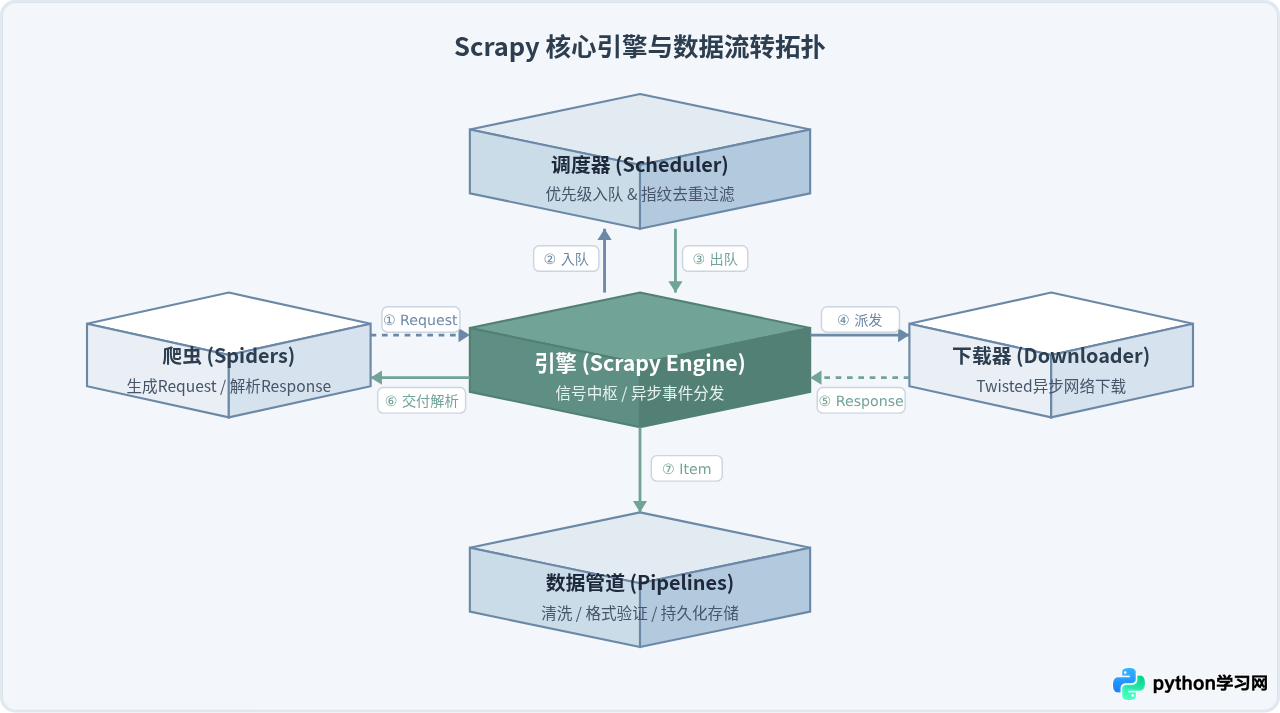
大规模数据采集任务中,单机架构往往受制于带宽与内存。本文详细对比常见Python采集方案,深入剖析Scrapy及Scrapy-Redis分布式架构的工作原理、改造步骤与生产环境调优策略。
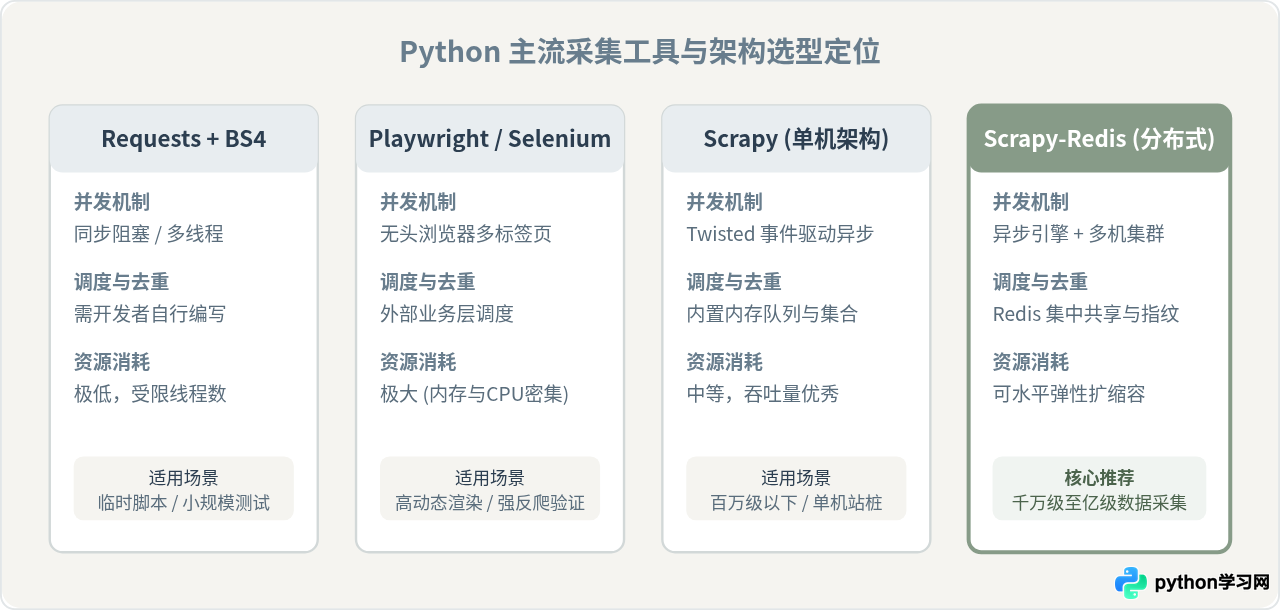
本文详细解析Python分布式爬虫中消息队列的核心作用,通过生活化类比阐释其去重与任务分发机制。重点介绍如何利用Redis队列构建生产端,实现多爬虫节点对URL任务的有序获取与高效处理,避免重复爬取,为构建高性能分布式爬虫系统提供实践参考。
本文详细解析 Scrapy 中 settings.py 的关键配置项。涵盖字符编码设置、Redis 连接参数(含密码与数据库指定)、请求超时与重试机制优化,以及基于 scrapy-redis 的去重组件、调度器和持久化断点续爬功能的配置方法。通过调整 DUPEFILTER_CLASS、SCHEDULER 及 SCHEDULER_QUEUE_CLASS 等参数,实现高效分布式爬虫与数据持久化存储。
本书系统讲解Python网络爬虫开发,从基础原理到Scrapy框架应用,深入解析动态网页抓取与JS加密分析。涵盖单机爬虫至分布式架构设计,通过9个实战项目演示反爬突破与数据去重方案,适合希望掌握大规模数据采集技术的开发者。
本教程详细讲解如何使用Python Scrapy与Redis构建高可用、大规模的分布式网络爬虫项目,涵盖架构原理、环境搭建、代码编写、节点部署及监控运维。