


很多人第一次遇到 LEFT JOIN 后 SUM 翻倍,都会怀疑是不是 SQL 写法有坑,或者数据库算错了。其实问题出在聚合粒度:只要主表一行能匹配子表多行,JOIN 之后参与计算的就已经不是“原始业务行”,而是被展开过的中间结果集。要想把统计结果算准,同时控制中间数据量,关键做法就是先对子表按关联键预汇总,再把结果回连到主表。
为什么 LEFT JOIN 后 SUM 会翻倍
根本原因很简单:当主表的一行关联到子表的 N 行时,JOIN 会先把这一行复制成 N 行,再交给后面的聚合函数处理。于是 SUM、COUNT 统计的其实是“物理展开后的行数”,结果自然会被放大。
这不是数据库 bug,而是关系代数的正常行为。比如要查“每个用户的订单总金额”,如果你在 users LEFT JOIN orders 之后直接写 SUM(orders.amount),看起来像是在按用户求和,实际上是在对 JOIN 后的明细行求和。只要后续还接了别的明细表,放大效应会更明显。
为什么会出现重复累加
可以把它理解成两步:
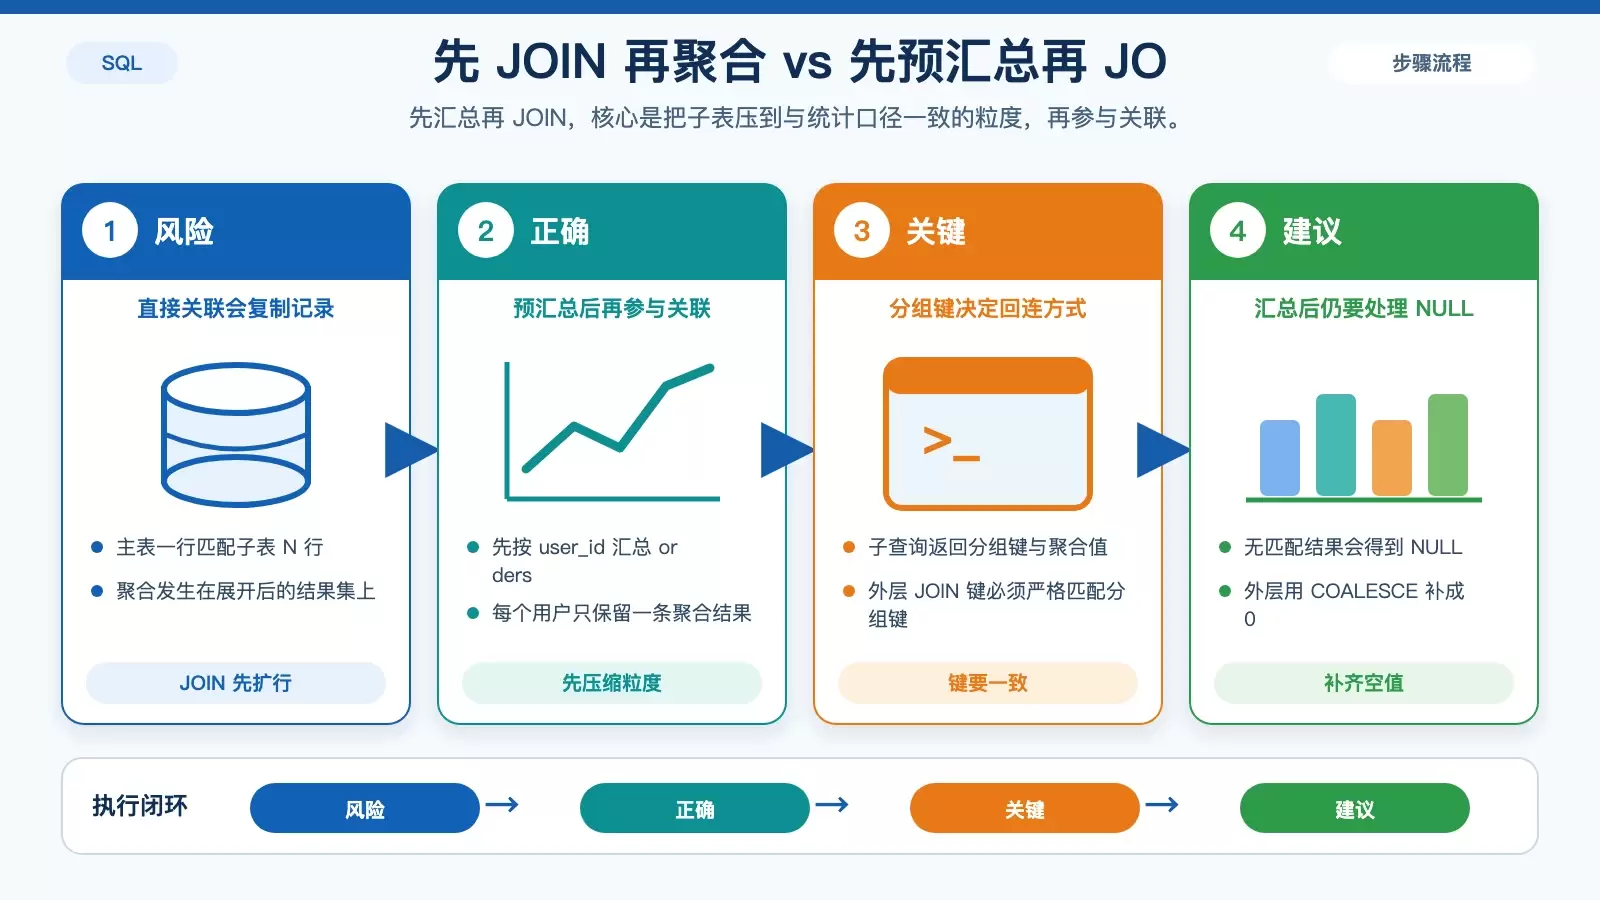
- 先做
JOIN,得到展开后的结果集。 - 再做
SUM、COUNT等聚合。
也就是说,聚合函数并不知道哪一行是“业务上重复出来的”,它只会老老实实对当前结果集逐行计算。
正确做法:先对子表预汇总再 JOIN
避免重复统计的常用方式,是先在子查询里对子表按关联键聚合,让每个逻辑单位只保留一行,再去和主表做 LEFT JOIN。这样外层 JOIN 时,子表已经不是明细表,而是“每个用户一行”的汇总结果。
SELECT user_id, SUM(amount) AS total_amount
FROM orders
GROUP BY user_id
这个子查询的意义在于:先把 orders 压缩到 user_id 粒度,再交给外层查询使用。外层如果要保留没有订单的用户,还需要配合 COALESCE 把空值补成 0。
SELECT
  u.id,
  COALESCE(o.total_amount, 0) AS total_amount
FROM users u
LEFT JOIN (
  SELECT user_id, SUM(amount) AS total_amount
  FROM orders
  GROUP BY user_id
) AS o
  ON u.id = o.user_id;
这类子查询要满足的几个条件
- 子查询只返回“分组键 + 聚合值”,例如:
SELECT user_id, SUM(amount) AS total_amount FROM orders GROUP BY user_id - 外层
JOIN键必须严格对应这个分组键 - 子查询必须带别名,MySQL 中常见的
Error Code: 1248,很多时候就是漏了AS t
过滤条件为什么要写在子查询内部
如果只统计已支付订单,像 WHERE status = 'paid' 这种条件,应该写在预汇总子查询里。原因是它决定了“参与聚合的明细范围”,属于子表内部逻辑。
SELECT
  u.id,
  COALESCE(o.total_amount, 0) AS total_amount
FROM users u
LEFT JOIN (
  SELECT user_id, SUM(amount) AS total_amount
  FROM orders
  WHERE status = 'paid'
  GROUP BY user_id
) AS o
  ON u.id = o.user_id;
如果把这个条件挪到外层 WHERE,就会把原本用于“保留主表全部记录”的 LEFT JOIN 语义破坏掉,实际效果更接近 INNER JOIN。
为什么预汇总还能明显降低开销
预汇总不仅是为了算对结果,也常常直接决定 SQL 能不能在大表场景下跑得动。
假设三张都是百万级的明细表,直接 JOIN 之后,中间结果可能膨胀到上千万行;但聚合本身往往只需要一次扫描。把 SUM 放在 JOIN 之后,相当于先让数据库把所有组合都拼出来,再去统计。反过来,如果先按 user_id 或 order_id 汇总,每个逻辑单位只保留一行,中间结果集就会从千万级压缩到百万级甚至更少。
所以“先汇总再 JOIN”本质上是在主动控制聚合粒度和中间数据规模,而不是单纯多写几行 SQL。
为什么 DISTINCT 救不了 SUM 和 AVG
很多人遇到重复统计后,会第一时间想到 DISTINCT。但它只对少数场景有效,不能把所有聚合问题都修正回来。
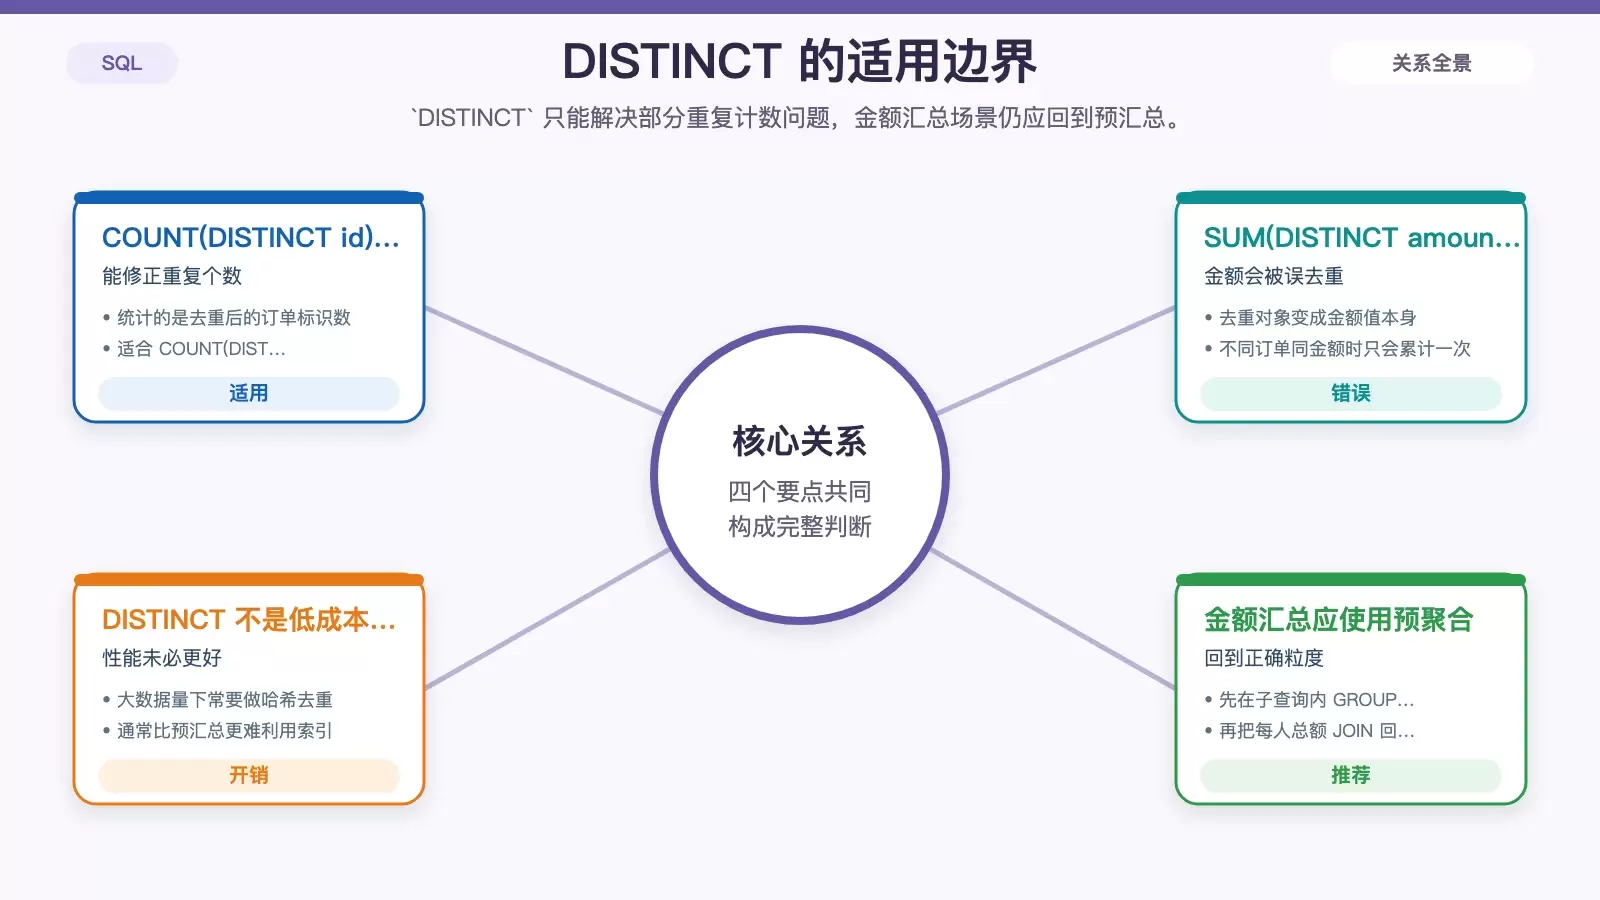
COUNT(DISTINCT id) 的确可以绕过重复计数,因为它统计的是“去重后的标识数”。可一旦换成金额类指标,问题就完全不同了:SUM(DISTINCT amount) 去重的是金额值本身,而不是订单行。两个不同订单只要金额相同,就只会被加一次,逻辑上显然是错的。
- 适用:
COUNT(DISTINCT orders.id)统计每个客户下了几个订单 - 不适用:
SUM(DISTINCT orders.amount)计算总销售额,它会把相同金额只累计一次 - 真正需要的仍然是:先在子查询里
GROUP BY user_id算好每人总额,再回到主查询
另外在大数据量下,DISTINCT 往往还要做哈希去重,通常比预汇总更慢,也未必能很好利用索引。
CTE 和子查询该怎么选
写预汇总时,既可以用嵌套子查询,也可以用 CTE。两者执行计划通常接近,差别更多在可读性、复用性和优化器处理方式上。
适合用 CTE 的场景
如果同一张表的预汇总结果要被多次引用,CTE 通常更清晰。比如同一张 order_items 表,既要算总金额,又要算商品数,用 CTE 可以把这层逻辑单独命名,避免重复写两次。
这类写法更适合逻辑分层明确、同一聚合结果需要多处复用的查询。
适合用子查询的场景
如果只是一次性引用,子查询通常更轻量,写起来也更直接。在某些场景下,尤其明细表已有覆盖索引时,子查询未必比 CTE 差,还可能避免额外的物化开销。
版本和数据库差异
- SQLite 不支持写入式 CTE,但查询类 CTE 可用
- MySQL 8.0+、PostgreSQL 12+ 一般都推荐优先用 CTE 显式表达查询意图
结论:预汇总是在主动控制聚合粒度
预汇总不是“多写几行 SQL”的形式主义,而是把聚合粒度控制权拿回到查询设计者手里。只要你的统计口径是“每个用户一条汇总结果”,那就应该先把子表压到这个粒度,再参与 JOIN。
否则,数据库到底是在对多少行做 SUM,往往连你自己都很难一眼看清。这也是为什么一旦涉及一对多 JOIN 后再聚合,先对子表预汇总几乎总是更稳妥的写法。









