

Python Scrapy shell 快速调试与规则验证指南
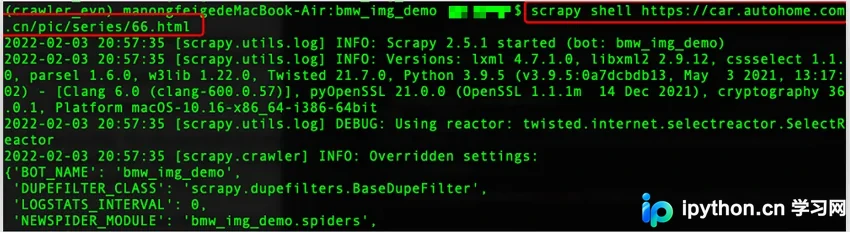
在 Python 爬虫开发中,直接使用 Scrapy 框架验证复杂的 XPath 或 CSS 选择器往往需要运行完整流程,耗时且容易打断工作流。本文详细介绍如何使用 Scrapy shell 交互终端在不启动爬虫的情况下实时抓取页面数据,快速调试提取规则,并提供标准的虚拟环境配置步骤与关键操作命令,大幅提升数据采集逻辑的验证效率。
2026-10-12
6

在 Python 爬虫开发中,直接使用 Scrapy 框架验证复杂的 XPath 或 CSS 选择器往往需要运行完整流程,耗时且容易打断工作流。本文详细介绍如何使用 Scrapy shell 交互终端在不启动爬虫的情况下实时抓取页面数据,快速调试提取规则,并提供标准的虚拟环境配置步骤与关键操作命令,大幅提升数据采集逻辑的验证效率。
本文详解Python爬虫中BeautifulSoup库的数据解析流程。从环境安装、对象实例化到标签定位(find/select)、文本提取及属性获取,结合三国演义小说爬取案例,演示如何解析列表页与详情页,实现指定内容的持久化存储。
本文详细解析了Python读取二进制文件的方法。通过open函数以二进制模式打开文件,利用read函数指定读取字节数,并使用struct模块的unpack函数将二进制数据转换为十进制数值。文章提供了完整的代码示例,展示了如何解包tuple类型的数据,帮助开发者高效处理二进制文件。
本文详细解析Python标准库json模块中dumps、loads、dump、load四个核心方法的用法,涵盖数据序列化、反序列化及文件读写操作。同时深入讲解jsonpath模块的安装与核心语法,包括根节点、子节点、递归选择及过滤操作符,帮助开发者高效处理多层嵌套的JSON数据。
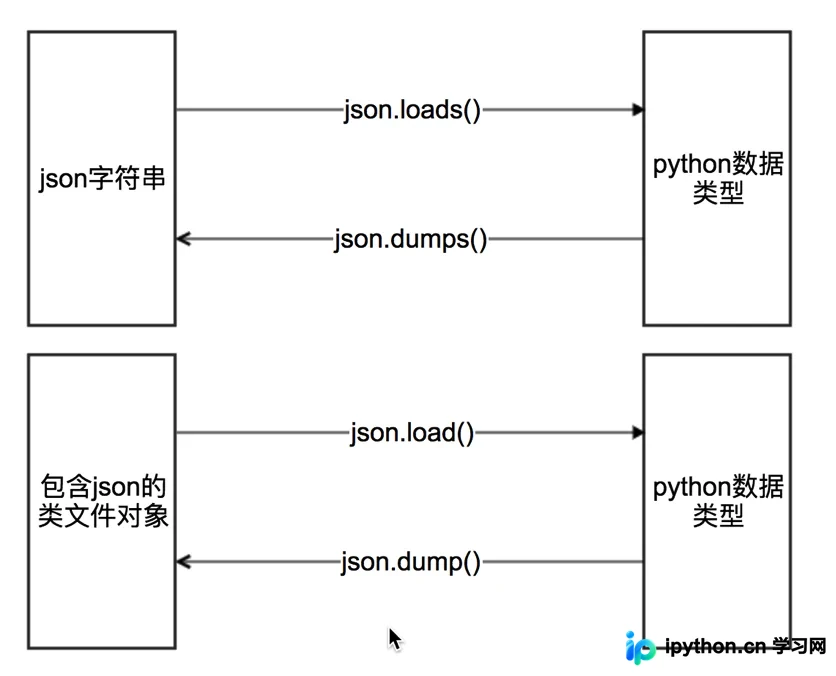
本文介绍在Python中如何使用response.read()方法接收HTTP响应数据,并将其转换为JSON格式。通过示例代码展示从读取原始字节流到解码字符串,再到使用json.loads()解析为字典对象的完整流程。
本文详解 Python 输入与输出格式化的核心方法。涵盖 input() 数据类型转换与异常捕获机制,对比 %、str.format() 与推荐的 f-string 语法,并通过购物结算实战案例展示如何编写健壮的用户交互程序,帮助开发者提升代码可读性与数据解析能力。