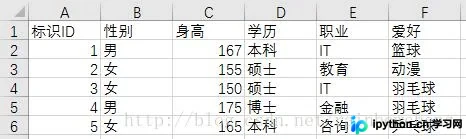
pandas中如何正确选取特定索引的行
本文介绍在pandas中选取特定索引行的方法。重点区分loc与iloc的使用场景:loc基于标签索引,适合按自定义索引值筛选;iloc基于整数位置,从0开始计数。通过示例演示如何避免常见错误,确保数据准确提取。
2026-10-13
7

本文介绍在pandas中选取特定索引行的方法。重点区分loc与iloc的使用场景:loc基于标签索引,适合按自定义索引值筛选;iloc基于整数位置,从0开始计数。通过示例演示如何避免常见错误,确保数据准确提取。
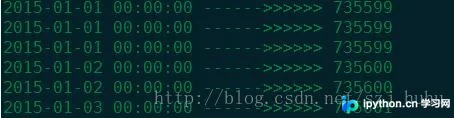
本文介绍在机器学习与深度学习中,如何利用Python的pandas和numpy库处理CSV文件中的时间变量。通过示例代码展示将时间列合并、解析为标准格式,并转换为float或int类型数值的过程,以便进行后续的分析与建模。
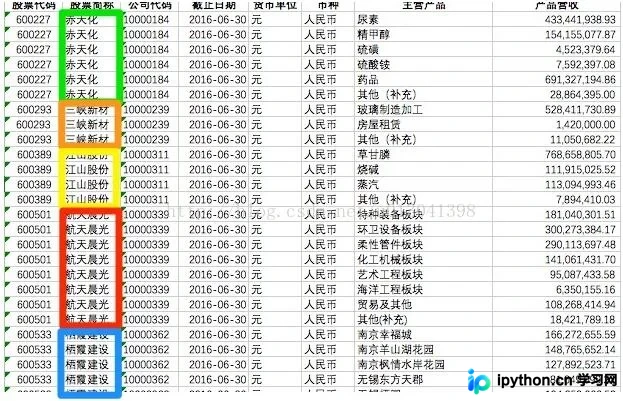
本文介绍如何利用Python的Pandas库对DataFrame进行多属性重复数据去重。通过duplicated方法生成布尔序列识别重复行,再结合drop_duplicates方法移除重复数据。示例展示了如何指定特定列(如state)进行去重判断,并保留了非重复行的完整数据,适用于数据清洗场景。
本文介绍如何使用 pandas 结合 set 对 DataFrame 中的指定列进行去重操作,并解决 set 无序导致无法直接转换的问题。通过 list 中间处理,将去重后的数据重新构建为标准的 DataFrame 格式并保存,适用于常见的数据清洗场景。
本文介绍在Python中利用pandas库将DataFrame转换为字典的方法。通过set_index设置索引并结合to_dict('list')实现转置转换,可生成以列为键、值为列表的字典结构。若未设置索引,默认将按行索引生成字典,需注意区分两种输出格式。
本文介绍如何在Python中将字典转换为二维数据及DataFrame对象。通过将字典的键值对列表化,可快速生成二维数组;利用pandas库可直接将字典项转换为DataFrame,并自定义列名。该方法简洁高效,适用于数据预处理与结构转换场景。
本文详解pandas中DataFrame的groupby分组聚合操作,涵盖Splitting、Applying、Combining三步流程。通过代码示例展示按单列或多列分组求和、求最值的方法,并重点解析reset_index()对输出结果索引结构的影响及列名提取差异,帮助开发者掌握数据预处理中的分组运算技巧。
本文介绍在Python中使用Pandas处理数据时,将DataFrame对象转换为NumPy数组的具体方法。通过调用DataFrame的values属性,可以高效获取底层数组数据,适用于需要高性能数值计算的场景。
本文深入解析Python pandas库中数据合并的核心方法。详细讲解merge函数的多对一、多对多连接及索引合并机制,涵盖inner、outer、left、right四种连接方式;同时剖析concat函数的轴向连接、索引处理及重叠数据填补策略,助力高效完成数据清洗与整合任务。
本文系统介绍Pandas中DataFrame的核心操作方法。涵盖loc、iloc等索引机制,详解行与列的增删改查技巧,包括条件筛选、isin、where及sample抽样。通过具体代码示例演示如何高效处理数据框,适用于Python数据分析初学者与进阶用户。
在使用Pandas处理数据时,isnull()生成的布尔矩阵难以直观识别缺失位置。本文介绍通过df.isnull().any()筛选含缺失值的列,并结合df[df.isnull().values==True]直接过滤出包含NaN的行,从而精准定位缺失数据的具体行列位置并辅助统计数量,提升数据清洗效率。
本文深入解析Pandas中DataFrame的行列数据筛选方法。通过对比df[]、df.loc、df.iloc及已弃用的df.ix,详细阐述基于标签与位置的索引逻辑。重点说明列选取时行索引不能为空的操作规范,以及混合索引类型的注意事项,帮助开发者高效处理表格数据。