

Python DataFrame 大规模数据批量映射赋值实战
本文介绍在Python中利用Pandas库的map函数,对DataFrame中百万级大规模数据进行高效批量映射赋值的方法。通过定义状态字典,将原始状态码如HUMAN_REFUSE等映射为中文结果,并创建新列存储,实现数据清洗与转换。
2026-10-13
6

本文介绍在Python中利用Pandas库的map函数,对DataFrame中百万级大规模数据进行高效批量映射赋值的方法。通过定义状态字典,将原始状态码如HUMAN_REFUSE等映射为中文结果,并创建新列存储,实现数据清洗与转换。
本文介绍在Python中处理DataFrame时,如何使用lambda函数替代传统的for循环进行数据分类。通过定义匿名函数并结合apply方法,可以简化代码逻辑,提高数据处理效率,适用于分数等级判定等场景。
本文详细讲解 Python Pandas 库中 DataFrame 的行与列选取方法,涵盖 loc、iloc、ix 等常用索引方式。针对读取 CSV 时产生的未命名列问题,提供重命名删除与直接切片剔除两种解决方案,帮助开发者高效处理数据清洗中的边缘情况。
本文详细介绍 Python 中 DataFrame 的常见操作方法,涵盖如何高效提取指定行与列、进行连续或离散的数据切片,以及计算均值、计数和分位数等统计特征值。通过具体代码示例,帮助开发者快速掌握 Pandas 核心数据处理技巧。
本文详细讲解如何利用pandas库对Series和DataFrame进行排序操作。内容涵盖按索引排序、按值排序、升降序调整及多列排序等核心功能,通过具体代码示例与运行结果展示,帮助开发者掌握数据清洗与预处理中的关键排序技巧。
本文详细介绍在Python pandas中替换某一列特定值的方法。通过示例数据集,演示如何将非指定字符串统一替换为默认值,提供简洁的代码实现步骤,帮助开发者快速掌握数据清洗中的关键技巧,适用于各类表格数据处理场景。
本文介绍如何使用pandas库中的astype方法修改DataFrame列的数据类型。通过示例演示将字符串型列转换为整型的操作,并展示修改前后的数据类型对比,帮助开发者快速掌握pandas列属性修改技巧。
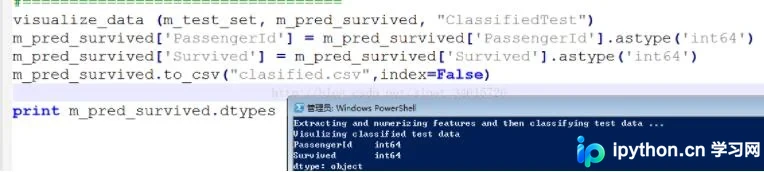
本文介绍如何在Python的DataFrame中更改列表字段或元素的数据类型。通过示例演示如何使用astype属性将特定字段(如PassengerId和Survived)从float64转换为int64,并提供代码实现及结果验证方法,帮助开发者高效处理数据格式问题。
本文介绍如何在Python的DataFrame对象中为行和列添加名称。通过设置index.name和columns.name属性,可以解决因缺少行列名导致的报错问题,并优化数据展示格式。
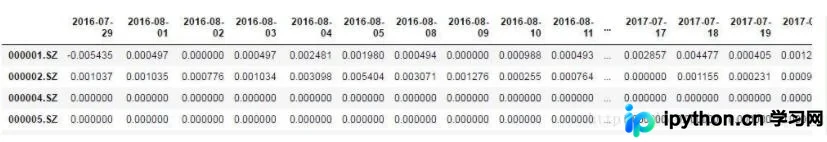
本文通过具体代码实例,演示了如何使用pandas库创建DataFrame并读取其中的行与列数据。重点介绍了利用iloc和loc进行索引定位,以及直接通过列名访问数据的方法,为Python数据分析提供基础参考。
本文介绍如何在Python pandas中处理包含多层索引的DataFrame。通过示例展示使用droplevel()方法逐层移除索引,从而将多重索引转换为单一默认索引,帮助开发者简化数据结构。
本文详细介绍Pandas中合并多个Dataframe的两种核心方法:merge和concat。通过对比left连接、多key合并及行列拼接等场景,解析如何根据数据对齐需求选择合适函数,并附带关键代码示例,帮助开发者高效处理大数据竞赛中的多表关联问题。