pandas离散化详解:pd.cut与pd.qcut参数及用法
本文详解pandas中数据离散化的两个核心函数pd.cut和pd.qcut。pd.cut用于基于固定边界或等宽区间进行分箱,支持自定义标签、精度及左右开闭设置;pd.qcut则基于样本分位数进行非均匀分箱,适用于数据分布不均的场景。文章通过具体代码示例展示了参数如bins、q、labels、retbins、precision和include_lowest的实际应用,帮助开发者掌握数值数据转换为分类数据的方法。
本文详细解析Python中pandas库的cut和qcut函数用法及区别。cut基于固定区间进行等宽分箱,适用于已知边界的数据;qcut基于分位数进行等频分箱,确保各组样本数量大致相等。通过具体代码示例展示两者在年龄分组和随机数据分割中的应用,帮助开发者根据需求选择合适的分箱策略。
本文详细介绍如何利用Python的pandas库对连续数据进行离散化处理。重点解析pd.cut和pd.qcut两个核心函数的用法:pd.cut通过指定分界点进行自定义分箱,支持调整区间开闭及自定义标签;pd.qcut则根据指定箱子数量进行等频分箱,确保各箱数据量一致。文章包含具体代码示例与结果分析,适用于数据预处理场景。
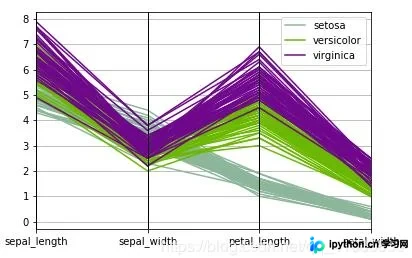
本文详解如何在Python中利用Pandas和Plotly库绘制平行坐标图以解决高维数据可视化难题。通过对比共用Y轴与独立Y轴两种模式,结合Iris鸢尾花数据集示例,展示从基础绘图到交互式高级可视化的完整实现过程,帮助开发者掌握高维变量关系的直观表达技巧。

本文详细解析Python中pandas模块的核心用法,涵盖Series与DataFrame的创建、属性获取及多种索引方式。通过实例演示字典、数组等数据源的转换,深入讲解loc、iloc等高级索引技巧,并指出ix方法的弃用情况,帮助开发者掌握高效的数据处理技能。
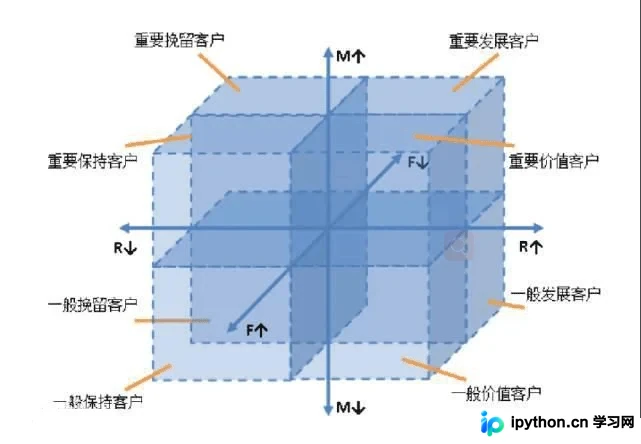
本文详解基于Python pandas构建RFM模型的全过程。涵盖数据预处理、R/F/M指标标准化与分级、K-means聚类划分高价值及挽留客户,以及利用AHP层次分析法进行加权打分。通过实际代码示例,展示如何从原始交易数据中提取客户特征并实现精细化运营策略。

本文详细解析Python中Pandas库读写Excel文件的方法。涵盖安装pandas及依赖包xlrd、openpyxl的步骤,演示如何创建Excel并写入数据,深入讲解read_excel函数的关键参数如io、sheet_name、header等,并提供读取、增删行列及保存文件的完整代码示例,帮助开发者高效处理大型数据集。
在使用pandas展示数据时,若列名包含中文可能导致输出列名无法对齐。通过设置display.unicode.ambiguous_as_wide和display.unicode.east_asian_width参数为True即可解决该问题。
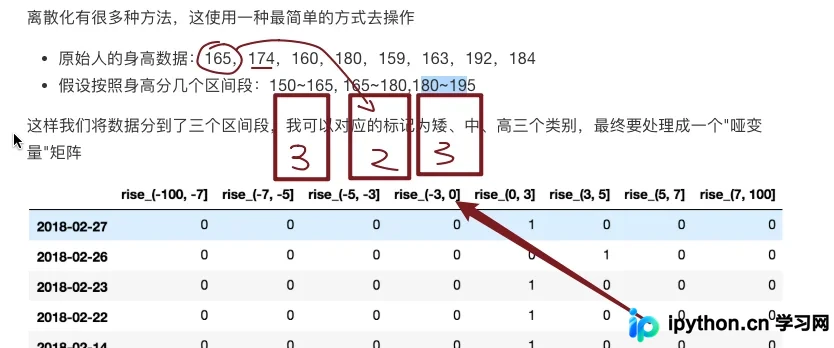
本文详解Pandas中数据离散化的原理与实现,通过股票涨跌幅数据案例,演示如何利用pd.cut进行等宽分箱和pd.qcut进行等深分箱。内容涵盖自定义区间设置、分组统计及代码实现,帮助开发者简化连续数据结构,提升模型泛化能力。

本文详解Pandas中缺失值(NaN)的检测与处理方法。涵盖使用pd.isnull判断空值、dropna删除含缺失值的行、fillna填充指定值(如均值)以及replace转换特定标记为NaN的操作。同时提供解决SSL证书验证失败的实用技巧,帮助开发者高效完成数据清洗工作。
本文详细介绍使用Python Pandas库读写CSV文件的各种方法。涵盖基础导入、两种读取方式、按条件读取、正则分隔符处理、行选择、缺失值处理、逐行读取及写入DataFrame等核心操作,并提供完整代码示例,帮助开发者高效处理结构化数据。
本文介绍在Python中执行Hive SQL的两种主要方法:通过os.system直接运行脚本,以及利用os.popen配合pandas读取结果。重点解析如何设置hive.cli.print.header以显示表头,并探讨结合TensorFlow等框架时可能遇到的显存占用问题及优化思路。