

pandas中ExcelFile与ExcelWriter类的读写操作详解
本文详细介绍pandas库中ExcelFile和ExcelWriter两个核心类的用法。通过ExcelFile读取现有Excel文件的Sheet名称及数据,利用parse方法提取指定Sheet内容;通过ExcelWriter创建写入对象,结合to_excel方法将多个DataFrame写入不同Sheet,最后调用save保存文件。适用于需要批量处理或生成多Sheet Excel文件的场景。
2026-10-13
6

本文详细介绍pandas库中ExcelFile和ExcelWriter两个核心类的用法。通过ExcelFile读取现有Excel文件的Sheet名称及数据,利用parse方法提取指定Sheet内容;通过ExcelWriter创建写入对象,结合to_excel方法将多个DataFrame写入不同Sheet,最后调用save保存文件。适用于需要批量处理或生成多Sheet Excel文件的场景。

本文深入解析Pandas库中resample方法的使用,涵盖降采样与升采样的核心概念。通过具体代码示例,详细演示如何设置频率、处理NaN值(pad/bfill)以及应用自定义聚合函数,帮助开发者高效处理高频与低频时间序列数据转换。
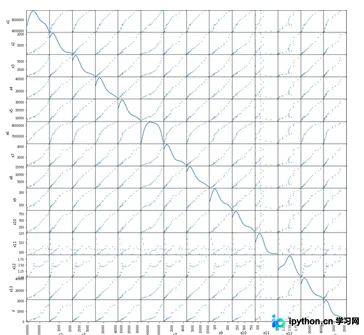
本文详细介绍pandas中scatter_matrix函数的用法,涵盖frame、alpha、figsize、diagonal等关键参数。通过sklearn的iris样本进行实战演示,展示如何配置颜色、标记及直方图选项,生成特征间关系的矩阵散点图,帮助开发者快速掌握多维数据的可视化技巧。
本文介绍如何使用pandas库的to_csv方法向已存在的CSV文件追加数据。通过设置mode='a'参数,可实现无需清空原文件即可追加DataFrame数据,适用于批量处理和多进程合并场景,提升数据处理效率。
GROUP BY 子句用于将数据表中的记录按指定列进行分组,并结合 COUNT、SUM、AVG 等聚合函数计算每组的统计结果。本文通过员工表实例,演示如何使用 GROUP BY 统计每位员工的入职天数及工作页数,帮助理解分组查询的核心逻辑与应用场景。
本文详解Python中Pandas库的数据重采样与频率转换技术。通过resample结合asfreq实现按月、日等自定义频率的下采样,并演示asfreq的pad前向填充用法。同时介绍线性插值interpolate及前后向填充bfill/pad处理缺失值的方法,结合代码示例展示时间序列数据的变频与插值实际操作。
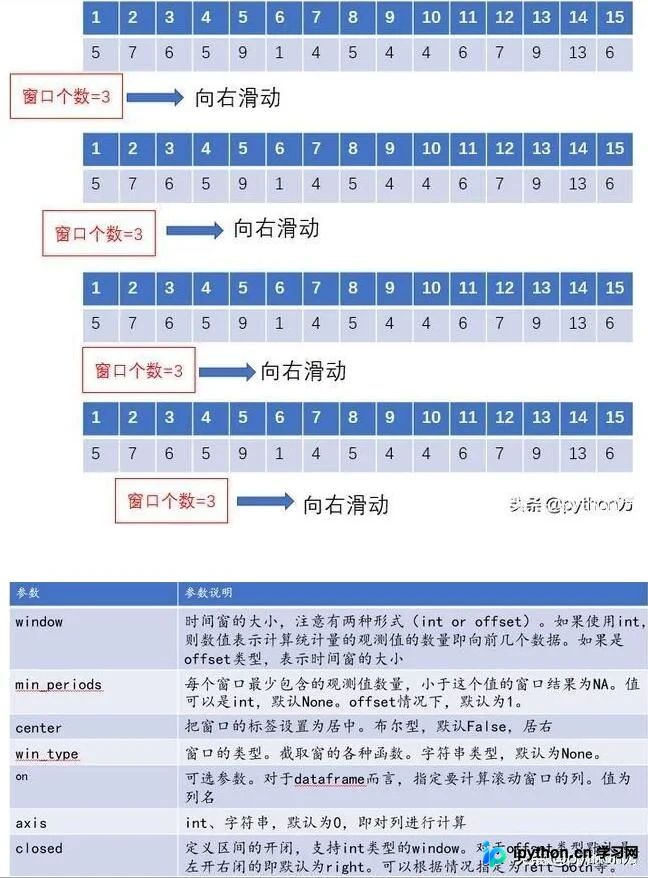
本文详细解析pandas中read_csv、rolling和expanding三个核心函数的用法。涵盖read_csv的header、index_col及usecols参数配置;深入讲解rolling滑动窗口的min_periods参数控制机制;以及expanding扩展窗口处理历史数据的方法。通过具体代码示例,帮助开发者掌握时间序列与数据窗口分析技巧。
本文详解Pandas中read_csv读取CSV文件时常见的两类错误:因字段数不匹配导致的ParserError及KeyError。通过设置error_bad_lines=False跳过异常行,并区分Series与DataFrame赋值差异,提供针对EOF字符串错误及类型比较错误的实用解决方案。
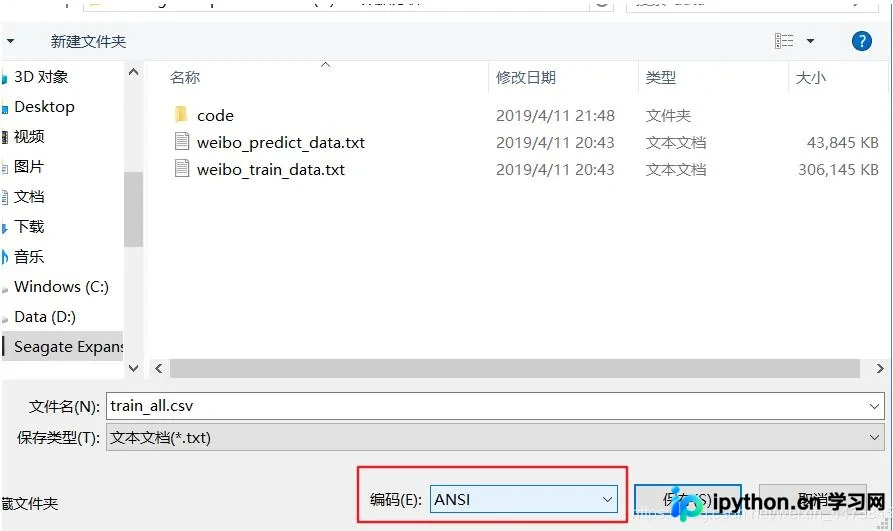
本文介绍在Jupyter Notebook中使用pandas导入CSV文件的方法,重点解决因文件编码非UTF-8导致的UnicodeDecodeError错误。提供两种解决方案:通过记事本将文件另存为UTF-8编码,或在pd.read_csv()中指定encoding参数(如gbk)以正确读取数据。
在Python Spyder环境中使用Pandas查看DataFrame时,常因列数或行数过多导致数据显示省略号。本文介绍利用pd.set_option函数调整display.max_columns和display.max_rows参数,完整展示所有数据列与行,解决Spyder下的显示截断问题。
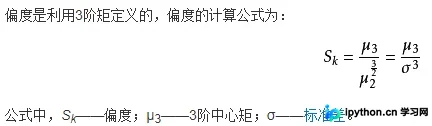
本文详细介绍在Python中使用scipy库进行数据正态性检验的多种方法。涵盖Shapiro-Wilk检验(适用于小样本)、K-S检验、normaltest、Anderson-Darling检验以及偏度和峰度检验。通过具体函数定义、参数说明及代码示例,帮助开发者掌握如何判断数据是否符合正态分布,为T检验等统计分析奠定基础。
本文详细介绍pandas中数据拼接的多种方法,包括使用join()合并无重复列的DataFrame、利用concat()按行或列拼接Series及DataFrame,以及通过combine_first()处理索引重复的情况。此外,还演示了stack()与unstack()在行列转换中的应用,帮助开发者高效处理数据整合任务。