

pandas中loc、iloc与ix索引方法的区别详解
本文详细解析pandas中loc、iloc和ix三种索引方法的区别。loc基于标签索引,包含切片末端;iloc基于整数位置索引,不包含切片末端;ix为混合模式。文章通过代码示例展示单行、多行及切片的具体应用,并指出ix在较新版本中已被弃用,建议优先使用loc和iloc以确保代码兼容性。
2026-10-13
6

本文详细解析pandas中loc、iloc和ix三种索引方法的区别。loc基于标签索引,包含切片末端;iloc基于整数位置索引,不包含切片末端;ix为混合模式。文章通过代码示例展示单行、多行及切片的具体应用,并指出ix在较新版本中已被弃用,建议优先使用loc和iloc以确保代码兼容性。
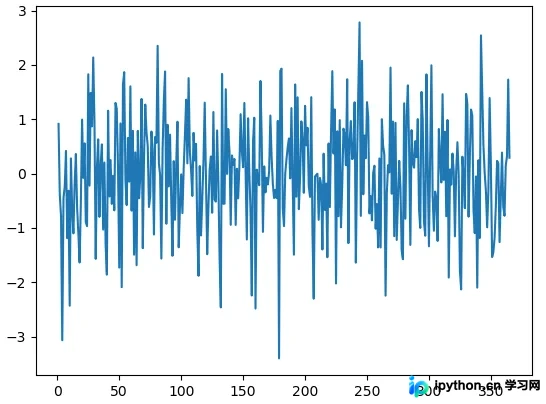
本文详细介绍Python中pandas库的安装方法及核心数据结构。通过pip命令快速安装pandas后,深入解析Series和DataFrame两种主要数据对象的创建方式。内容涵盖从列表、字典生成Series,利用Matplotlib进行可视化,以及DataFrame的行列索引、数据读取与切片操作,帮助初学者掌握数据处理基础。
本文详解Python中数据预处理的规范化技术,旨在消除量纲差异。通过Pandas库实现最小-最大规范化与零-均值规范化两种核心方法,提供完整代码示例及Excel数据源下载,帮助开发者掌握数据缩放技巧,提升模型分析效果。
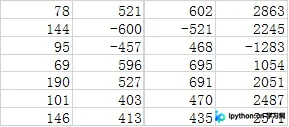
本文介绍使用Python进行拉格朗日插值法的实现,重点展示如何处理销售数据中的异常值。通过自定义插值函数,对销量低于400或高于5000的异常数据进行平滑处理,利用前后k个数据点进行多项式插值,最终输出完整且修正后的数据集。
本文介绍如何使用Python读取通达信股票数据文件(.day)。通过struct模块解析二进制数据,处理日期、价格及成交量字段,最终将结果封装为pandas DataFrame对象,便于后续数据分析与处理。
本文介绍如何利用Python的pandas库读取以竖线'|'作为分隔符的文本文件。通过指定sep参数为'|'并设置dtype为'str',可确保所有列数据均按字符串类型处理,适用于20180201.txt等格式文件的快速解析与预处理。
本文介绍使用Python Pandas库将Excel文件转换为CSV格式,并在转换过程中对指定列进行数据处理的方法。通过示例代码展示了如何读取Excel、过滤数据、修改特定列内容(如添加前缀)并保存为CSV文件,适用于需要批量处理Excel数据并生成标准化CSV文件的场景。
本文介绍在Python中使用Pandas库读取包含中文字符的CSV或文本文件时,如何通过正确设置encoding参数(如'gbk')来避免乱码或解码错误。通过具体代码示例展示读取含中文数据的文件方法,确保数据完整性和兼容性。
在使用pandas保存Excel文件时,直接调用to_excel会覆盖原有文件。本文介绍利用ExcelWriter结合openpyxl引擎,通过load_workbook加载已有工作簿,再写入新Sheet的方法,从而实现在不删除原有Sheet的前提下追加数据。
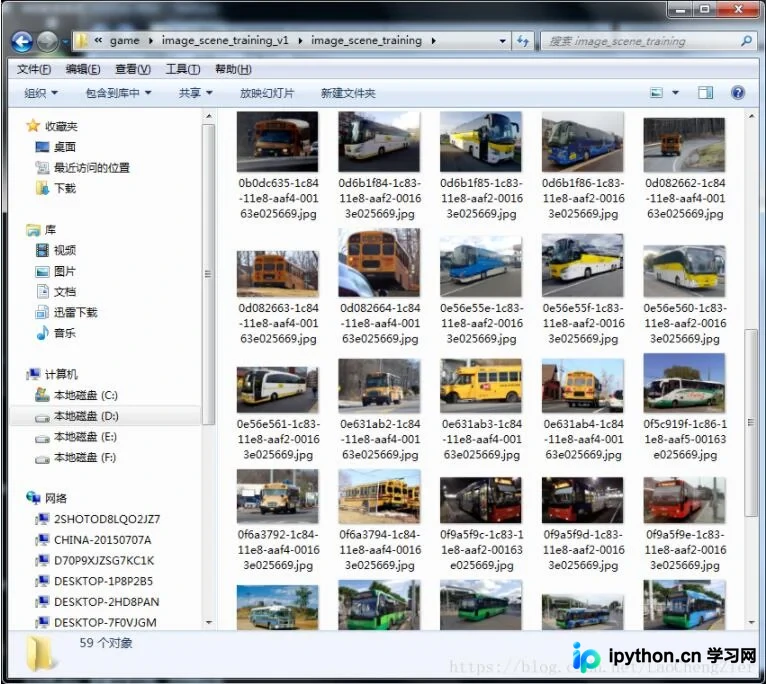
本文介绍如何利用Python脚本,结合pandas读取包含图片类别信息的CSV表格,并通过os和shutil库自动创建文件夹及移动图片。该方法适用于需要将大量图片按预设标签(如0-19类)批量整理至独立目录的场景,代码已优化修正,可直接参考使用。
本文介绍如何使用Pandas库中的apply函数对DataFrame指定列进行批量条件赋值。通过定义自定义函数并结合lambda表达式,实现如数值大于等于阈值赋1、否则赋0的逻辑,帮助开发者高效处理数据清洗与特征工程中的条件转换任务。
本文详解pandas中rolling函数的核心参数与用法。重点解析window类型(int与offset)、min_periods、center及closed等关键配置,并通过物流场景示例,展示如何结合groupby实现基于时间的滚动聚合计算,提供高效的数据处理方案。