

Pandas统计重复列值及NumPy去重方法详解
本文介绍如何在Pandas中利用duplicated方法统计并筛选包含重复值的列,通过keep参数控制保留逻辑。同时提供五种NumPy数组去重方案,包括利用unique、bincount及排序比较等技巧,帮助开发者高效处理数据中的重复项。
2026-10-13
6

本文介绍如何在Pandas中利用duplicated方法统计并筛选包含重复值的列,通过keep参数控制保留逻辑。同时提供五种NumPy数组去重方案,包括利用unique、bincount及排序比较等技巧,帮助开发者高效处理数据中的重复项。
本文介绍如何在 Python 的 DataFrame 中计算差集,即删除指定列中与给定列表元素重复的行。通过 isin 方法生成布尔掩码并取反,实现高效筛选,最后重置索引输出结果。
本文介绍如何在Pandas中利用字典映射方法,将DataFrame某一列的字符串值高效转换为数字。通过定义映射字典并调用map函数,即可实现类型转换,适用于分类变量编码等场景。
本文介绍如何在Python Pandas中向DataFrame指定位置添加列。对比直接赋值和concat()只能在末尾添加的局限,重点讲解利用reindex()方法通过columns参数控制列顺序,并使用fill_value指定新列值,实现灵活插入单列或多列。
本文介绍了一种使用 Python 处理文本文件中数值的方法。通过读取文件内容,判断每个数值是否超过设定的上限(如 0.5),若超出则将值置为零并写入新文件,否则保留原值。该方法适用于需要限制数据范围或进行简单数据清洗的场景。
本文详细解析在Python中对包含字典的列表进行去重的实现方法。通过示例代码展示如何利用reduce函数结合lambda表达式,高效处理字典顺序不同但内容相同的重复项,最终输出去重后的唯一字典列表,为数据清洗提供实用参考。
本文详细介绍如何使用Python的Matplotlib库绘制多种常用数据图表。内容涵盖柱状图(含水平排列)、折线图、饼图(详解pie函数参数)、散点图、箱线图、雷达图及气泡图的实现代码与效果。通过具体案例如水果销量分析,帮助数据分析师掌握图表制作技能,直观展示数据分布与趋势。
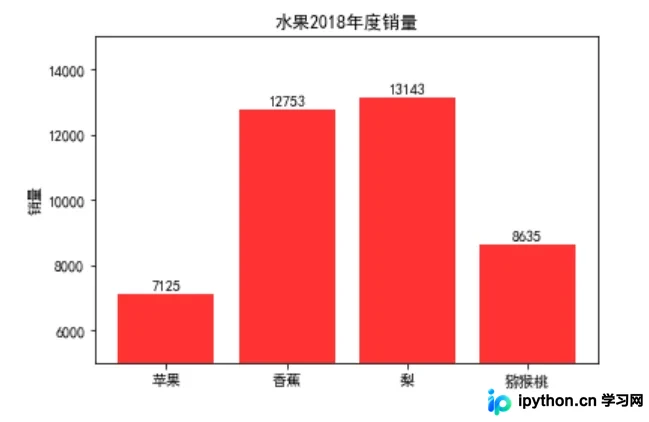
本文介绍在Python数据处理中,如何使用Pandas库的groupby结合shift函数对指定列进行向上或向下平移操作。通过调整shift参数的正负值控制偏移方向,缺失值自动填充为NaN,相比传统循环方式更加高效便捷,适用于基于分组的错位相加减场景。
本文详细解析pandas中loc、iloc和ix三种索引方法的区别。loc基于标签索引,包含切片末端;iloc基于整数位置索引,不包含切片末端;ix为混合模式。文章通过代码示例展示单行、多行及切片的具体应用,并指出ix在较新版本中已被弃用,建议优先使用loc和iloc以确保代码兼容性。
本文详细介绍Python中pandas库的安装方法及核心数据结构。通过pip命令快速安装pandas后,深入解析Series和DataFrame两种主要数据对象的创建方式。内容涵盖从列表、字典生成Series,利用Matplotlib进行可视化,以及DataFrame的行列索引、数据读取与切片操作,帮助初学者掌握数据处理基础。
本文详解Python中数据预处理的规范化技术,旨在消除量纲差异。通过Pandas库实现最小-最大规范化与零-均值规范化两种核心方法,提供完整代码示例及Excel数据源下载,帮助开发者掌握数据缩放技巧,提升模型分析效果。
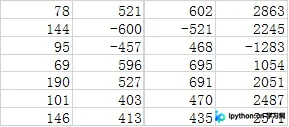
本文介绍使用Python进行拉格朗日插值法的实现,重点展示如何处理销售数据中的异常值。通过自定义插值函数,对销量低于400或高于5000的异常数据进行平滑处理,利用前后k个数据点进行多项式插值,最终输出完整且修正后的数据集。