Python NumPy实现Rolling滚动窗口计算详解
本文介绍如何在Python中使用NumPy实现类似Pandas的rolling滚动窗口功能。通过调整数组形状和步幅,利用NumPy底层C代码执行高效循环。文章详细解析了滚动窗口的参数设置、计算方法及与Pandas rolling函数的区别,并提供具体代码示例,帮助开发者在时间序列数据分析中灵活应用滚动计算。
2026-10-14
6

本文介绍如何在Python中使用NumPy实现类似Pandas的rolling滚动窗口功能。通过调整数组形状和步幅,利用NumPy底层C代码执行高效循环。文章详细解析了滚动窗口的参数设置、计算方法及与Pandas rolling函数的区别,并提供具体代码示例,帮助开发者在时间序列数据分析中灵活应用滚动计算。
本文介绍如何使用Python的pyhdfs模块连接Hadoop集群,实现HDFS文件的读写与本地文件上传。重点解析在通过Pandas处理包含特殊引号格式的CSV数据时,因正则匹配保留引号导致的转义错误,并提供修正后的正则表达式与处理逻辑,确保数据准确转换。
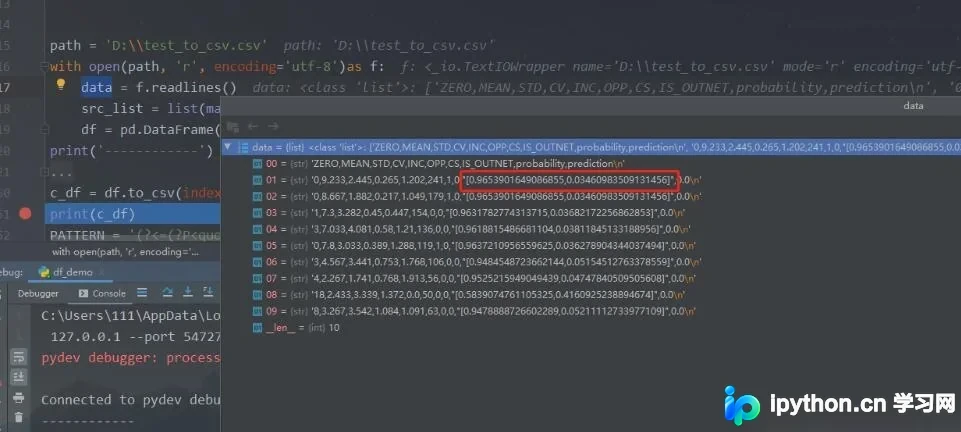
本文详细介绍如何在Python环境中连接HDFS,实现文件的读取与写入。通过安装pyhdfs模块,演示了从HDFS读取二进制数据流并转换为CSV,以及利用Pandas将文本文件处理为Dataframe并导出为CSV的具体代码。涵盖Python 3.6与Hadoop 2.9环境下的实际操作步骤,包括本地文件上传至HDFS的方法,为大数据处理提供基础支持。
本文详解如何在pandas中实现类似SQL的WHERE IN查询。通过演示isin()方法处理列表筛选,对比直接使用时in导致的ValueError错误,并展示多条件组合筛选的正确括号用法,帮助开发者高效进行数据过滤操作。
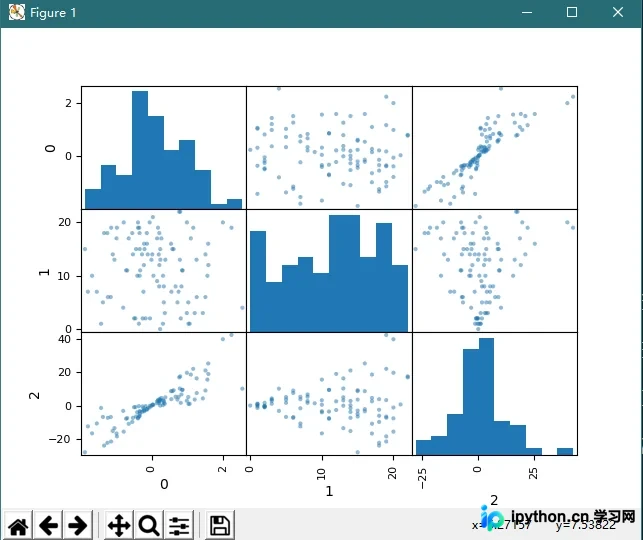
本文介绍如何在Python中利用pandas库的scatter_matrix函数绘制散点图矩阵。通过两个具体代码示例,展示基础用法及添加KDE对角线、指定颜色等高级参数配置,帮助读者快速掌握多变量关系可视化的实现方法。
本文介绍如何使用Python的pdfplumber库提取PDF中的表格数据。通过安装模块、导入库、打开文件并调用extract_table()函数,可将表格转换为Pandas数据框。文章还涵盖了单页提取与多页批量处理的代码示例,并提醒注意表格边框及换行对识别结果的影响。
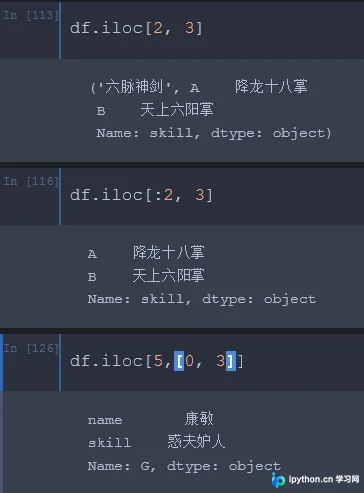
本文详细解析 Python Pandas 库中 DataFrame 的多种索引方式,重点介绍 iloc、loc 及 ix 的区别与用法,并涵盖双中括号、字典形式及属性形式等列访问技巧。通过示例代码与图解,帮助开发者掌握高效的数据筛选与提取方法,适用于各类数据科学场景。
本文详细解析Python Pandas中自定义聚合函数的用法,重点对比merge与transform在处理分组聚合结果时的差异。通过具体代码示例展示如何结合agg使用多个聚合函数,并深入探讨merge与transform在数据对齐和结果返回上的不同机制,帮助开发者选择合适的数据处理方案。
本文介绍如何利用pandas库向现有CSV文件追加新的列和行数据。首先通过Excel准备包含中文编码的CSV文件,接着演示使用df['列名']赋值方式添加整列数据,以及通过df.loc索引定位添加特定行数据。文中包含完整的代码示例及文件路径、编码格式等关键参数说明,适用于Python初学者进行基础数据操作。
本文介绍使用Python pandas库将数据写入Excel文件的两种常用方法。通过to_excel()可直接保存单个DataFrame;若需向现有工作簿添加多个Sheet,则需结合ExcelWriter()打开文件并逐个写入数据,最后调用save()保存。
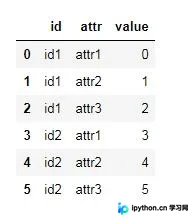
本文介绍如何在Python中使用Pandas库实现数据框的长格式与宽格式相互转换。通过stack和unstack方法,可将键值对形式的堆叠数据重塑为宽表,反之亦然。文章提供完整代码示例,涵盖从CSV读取、PeriodIndex构建到最终pivot和unstack操作的全过程,帮助开发者处理数据库交互中的常见数据结构转换需求。
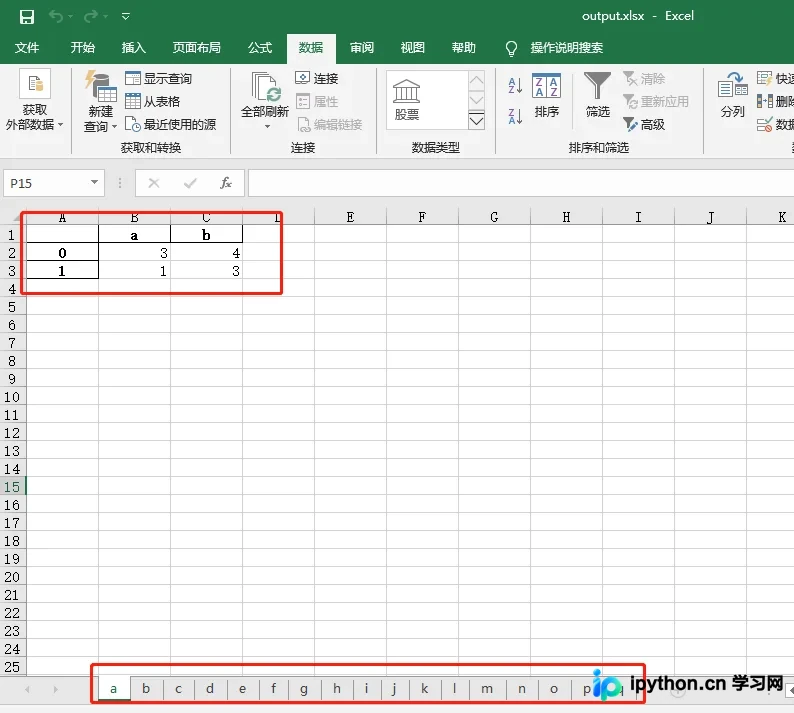
本文介绍如何使用Python的Pandas库将数据写入Excel文件的多个Sheet中。通过示例代码,展示了如何遍历Sheet名称列表,并将DataFrame对象依次写入指定的Sheet,最终保存并关闭文件。