

pandas DataFrame 导出 Excel 添加背景色与高亮显示
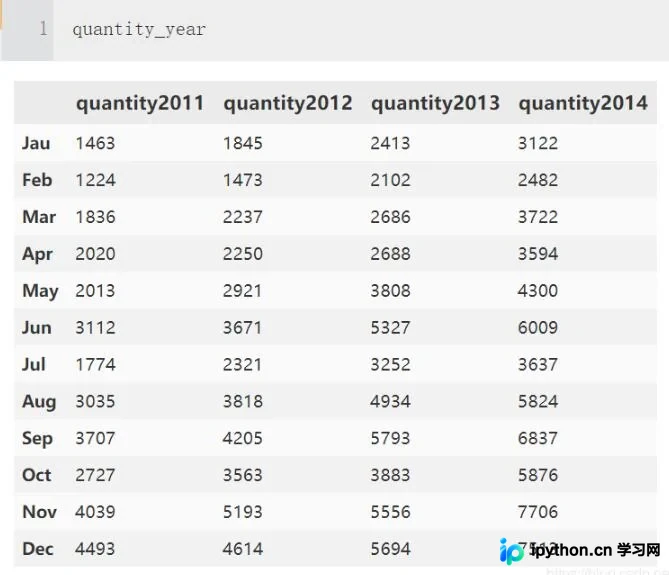
本文介绍如何使用 pandas 将 DataFrame 导出至 Excel 并添加背景颜色,通过 style.apply 方法实现二级标题列的颜色区分。同时补充了利用 background_gradient 进行渐变填充、自定义条件高亮最大值最小值以及隐藏索引等常用样式技巧,提升数据报表的视觉表达效果。
2026-10-14
6

本文介绍如何使用 pandas 将 DataFrame 导出至 Excel 并添加背景颜色,通过 style.apply 方法实现二级标题列的颜色区分。同时补充了利用 background_gradient 进行渐变填充、自定义条件高亮最大值最小值以及隐藏索引等常用样式技巧,提升数据报表的视觉表达效果。
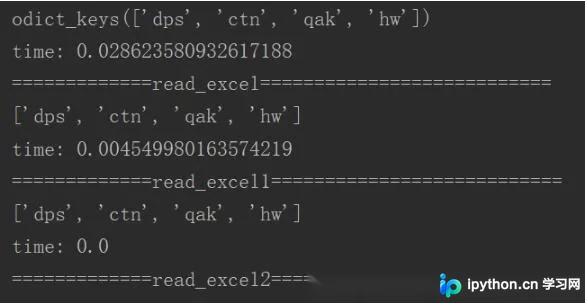
本文对比了三种使用Python Pandas库读取Excel文件中多个Sheet的方法。通过实际运行结果分析,方法1直接读取返回字典,方法2和3通过ExcelFile对象遍历Sheet,结果显示后两种方法在处理多Sheet时效率更高。文章提供了具体代码实现及解析结果,帮助开发者选择更高效的读取策略。
本文介绍如何利用Python的Pandas库高效处理Excel数据,重点演示删除表格中的重复行及空值。通过read_excel读取数据,使用duplicated和drop_duplicates函数识别并去除重复记录,支持按指定列去重及保留策略配置。同时涵盖缺失值检测与删除方法,适用于大数据集的自动化预处理场景。
本文探讨大数据分析中Java与Python的应用场景。Java作为主流大数据软件的基础语言,是开发必学技能,擅长金融与网站数据处理;Python凭借简洁语法和丰富的科学库,在数据爬取、人工智能及算法处理方面优势显著。文章建议大数据开发者应同时掌握两者,以应对不同规模和处理需求的大数据挑战。
本文介绍如何使用Python合并多个NPY文件,通过遍历目录加载数组并使用numpy.append进行拼接保存。同时提供批量合并CSV文件的方案,利用Pandas读取文件并处理编码问题,将多个月度数据整合为单一文件,适用于数据预处理场景。
本文深入解析Python pandas中drop方法的inplace参数。通过代码实例对比inplace为False(默认)和True时的行为差异,重点说明原数组内存地址不变但内容是否直接修改的区别。同时补充del与drop删除单列及多列的操作技巧,帮助开发者正确选择数据修改方式。
本文详细解析Python Pandas库中inplace参数的作用。当inplace设为True时,直接修改原对象且不返回新对象;设为False(默认值)时,创建并返回包含修改结果的新对象。文章通过代码示例对比两种情况,并指出该参数仅接受布尔值,传入整数会引发ValueError。
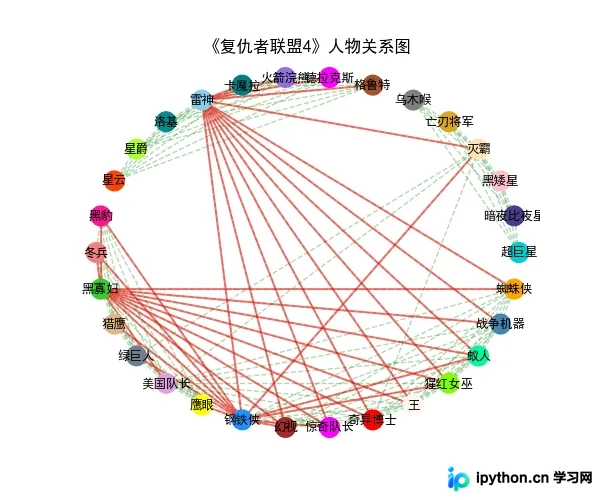
本文介绍如何利用Python的network模块构建《复仇者联盟4》人物关系图。通过pandas读取数据,使用Graph类添加节点与边,并展示两种布局算法:圆环布局与Fruchterman-Reingold力引导算法的效果对比,帮助读者掌握复杂网络可视化的基本方法。
本文探讨Python在数据挖掘领域的适用性及就业前景。数据挖掘旨在从海量数据中提取高价值信息,Python凭借高效开发优势成为主流工具。文章对比了算法模型、数据挖掘及数据分析三类岗位的技能要求,指出Python在快速验证想法和工程落地方面的独特价值,为从业者提供职业选择参考。
本文详细讲解在Python Pandas库中,如何将Dataframe和Series对象转换为List列表格式,包括提取单列、去重及多维转换。同时介绍将Dataframe转换为字典(Dict)的两种常用方法:直接转换与设置索引后转换,并对比其结果差异,适用于词云生成等场景。
本文详细介绍在Python pandas中获取Dataframe元素值的多种方法。包括通过遍历、类字典属性访问Series,以及使用at、iat、loc和iloc等属性根据行索引、列名或索引位置精准获取单个元素、单行或多行数据,涵盖Series与Dataframe的返回类型差异。
本文深入解析Pandas中DataFrame的单列、多列及分组运算方法。通过map实现元素级操作,利用apply处理行或列聚合,结合transform进行组内映射,以及使用agg执行复杂分组统计。涵盖具体代码示例与参数说明,帮助开发者高效处理数据。