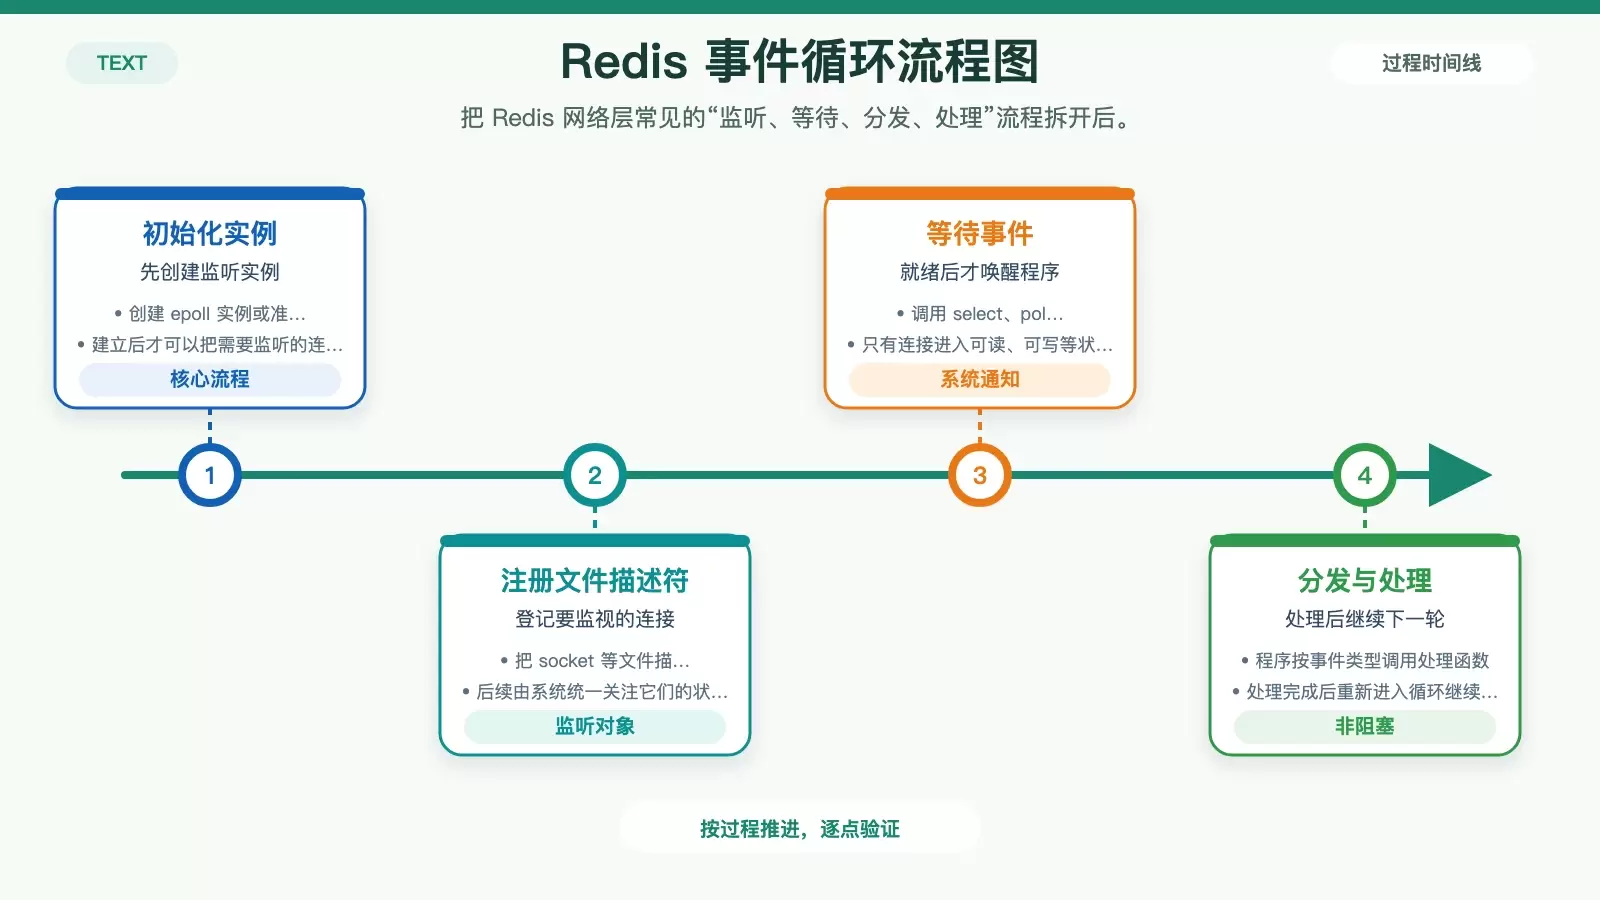
Redis 的 I/O 多路复用是怎么工作的?从事件循环到 Reactor 一次讲清
Redis 的高性能并不只是“单线程快”,关键在于它用 I/O 多路复用把大量连接集中交给一个事件循环处理。本文按工作机制、系统调用差异、Redis 的 Reactor 实现和示例代码四部分拆开讲,帮助你判断 Redis 为什么能高并发,以及性能边界在哪里。
2026-08-24
72

Redis 的高性能并不只是“单线程快”,关键在于它用 I/O 多路复用把大量连接集中交给一个事件循环处理。本文按工作机制、系统调用差异、Redis 的 Reactor 实现和示例代码四部分拆开讲,帮助你判断 Redis 为什么能高并发,以及性能边界在哪里。
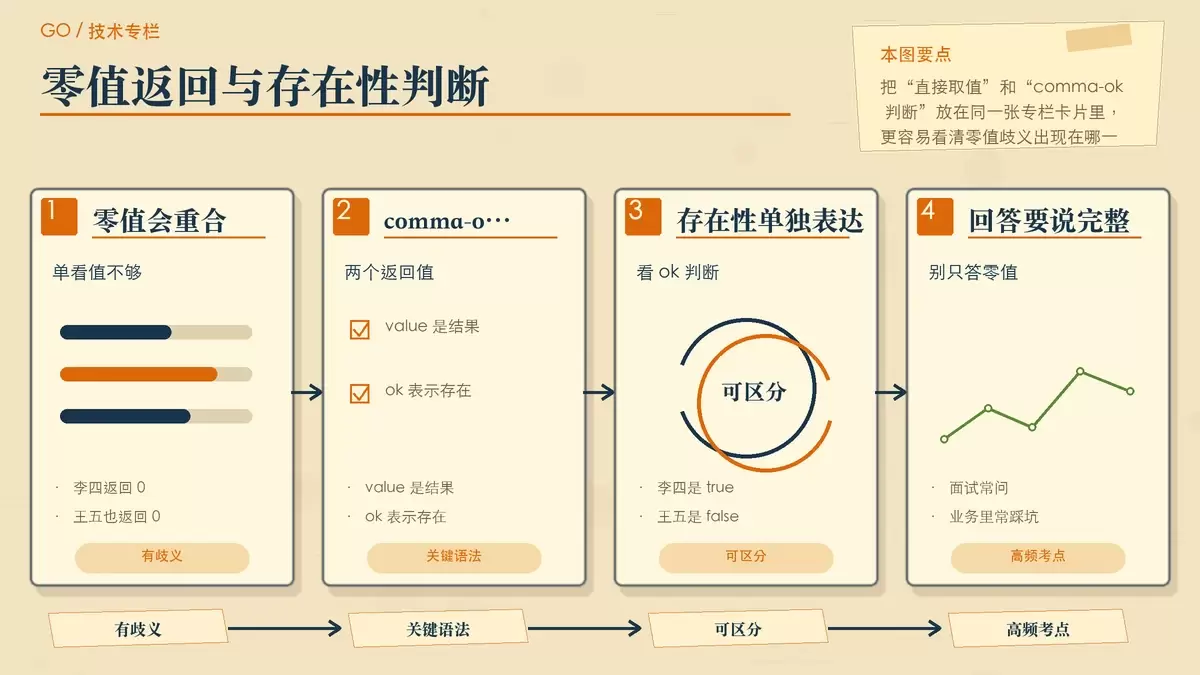
Go 的 map 在读取不存在的 key 时不会报错,而是直接返回 value 类型的零值。这种设计让代码更简洁,但也会带来“key 不存在”和“值本来就是零值”难以区分的问题。本文结合常见示例,讲清零值返回规则、comma-ok 用法,以及初始化、并发和容量预分配等实战注意点。
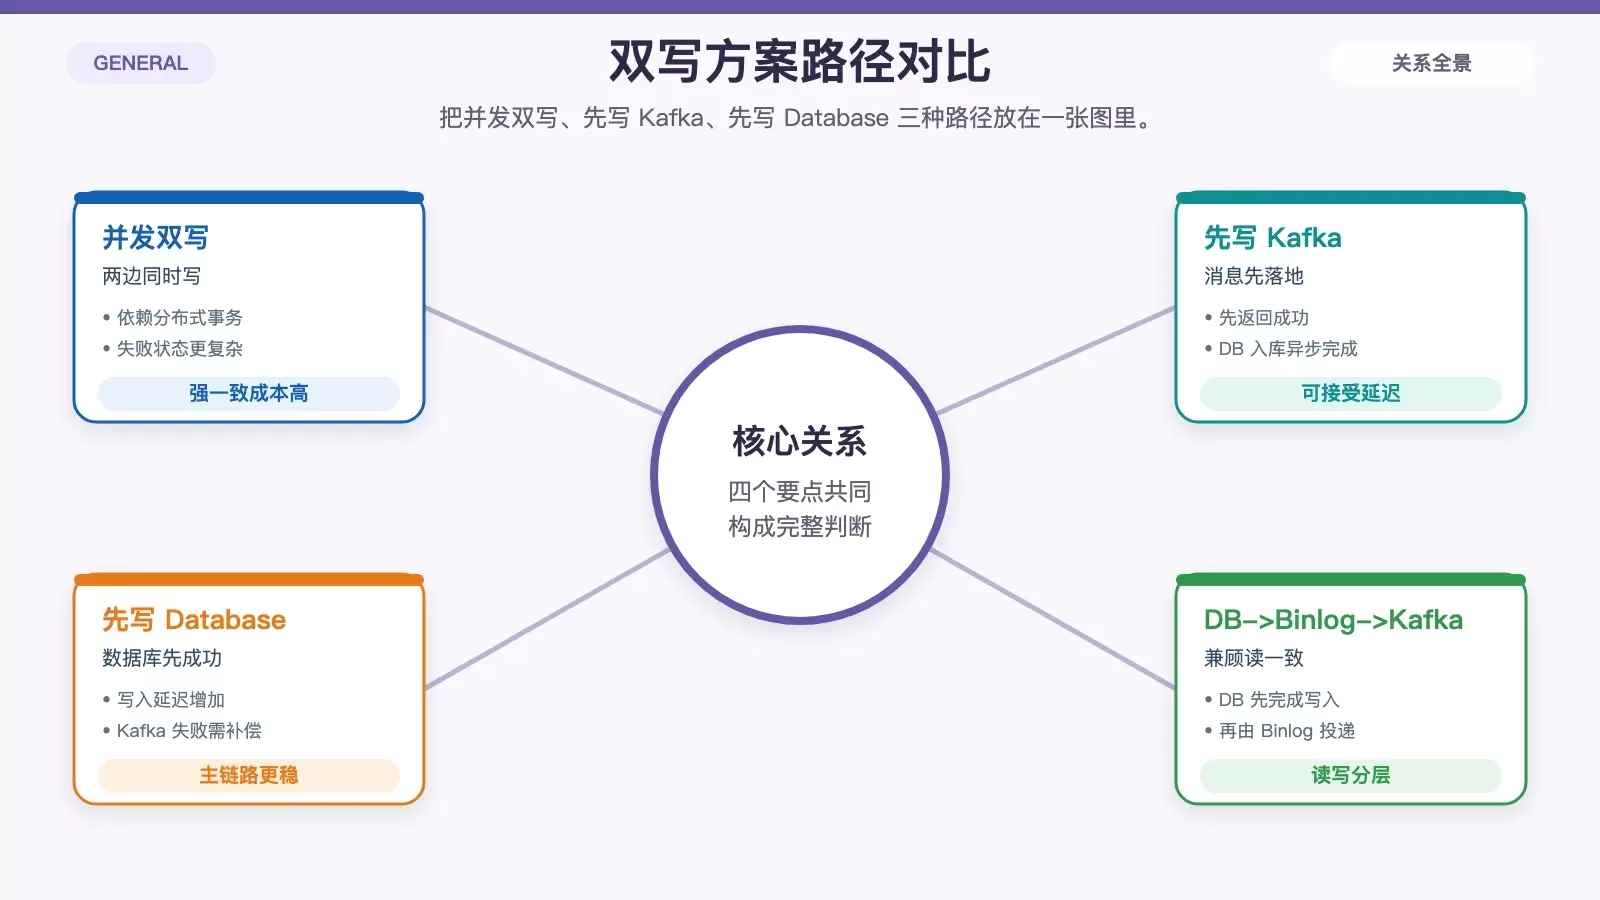
双写问题的核心难点不在“写两次”,而在两个独立系统之间如何拿到可接受的一致性。本文把并发双写、先写消息、先写数据库三种方案拆开说明,再结合 Lindorm 数据订阅,解释为什么在既要数据库强一致读、又要下游异步分发时,DB->Binlog->Kafka 是更实用的选择。
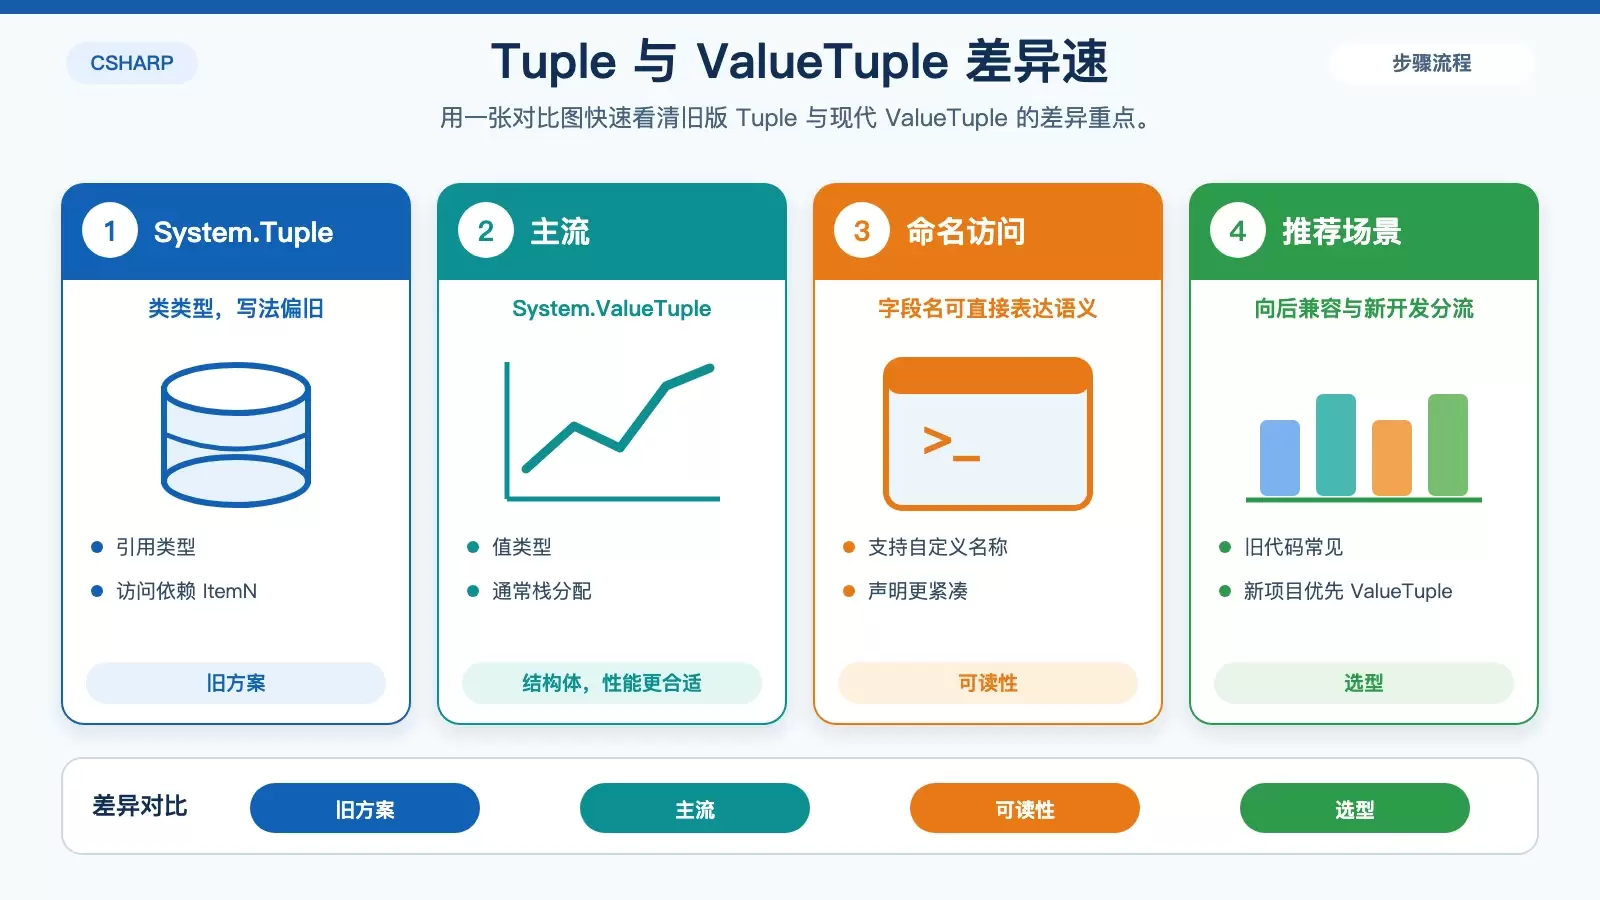
C# 元组的核心价值,在于用更少的样板代码组织少量异构数据。本文从 `Tuple` 与 `ValueTuple` 的差异讲起,梳理声明、解构、返回多个值、模式匹配、LINQ 与异步场景,并补出在 JSON、记录类型和长期维护中的边界,帮助你判断它该用在哪里、又该在哪些地方收手。
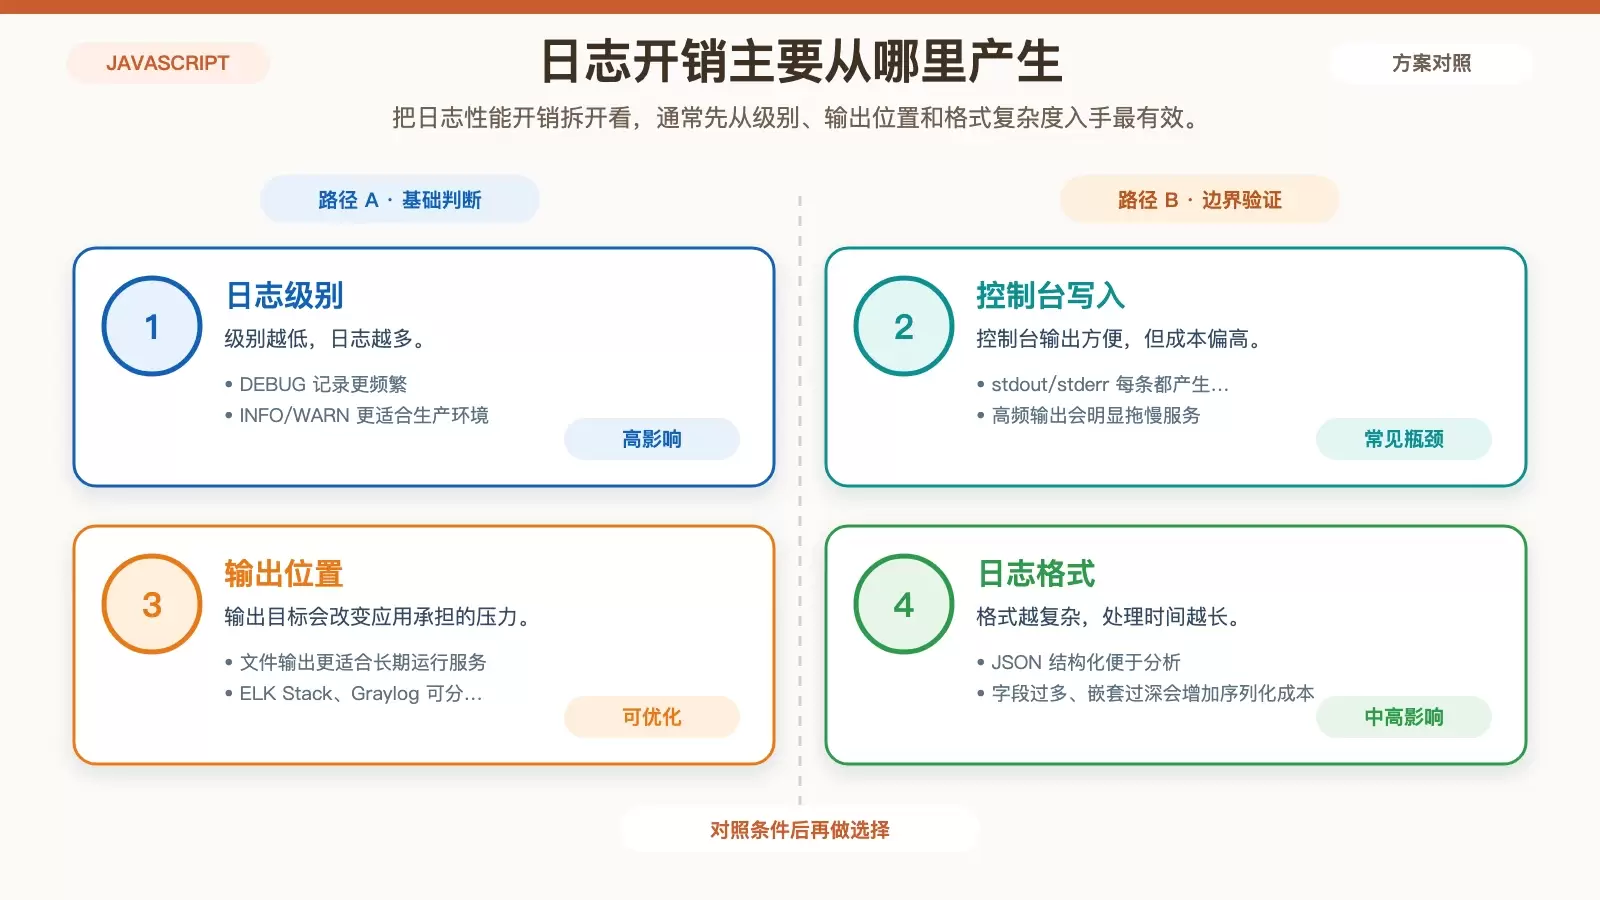
在 Debian 上运行 Node.js 时,日志策略会直接影响 CPU、I/O 和磁盘压力。真正拉开差距的,通常不是“记不记日志”,而是日志级别、输出位置、格式复杂度、轮转方式以及是否采用异步写入。 在 Debian 上部署 Node.js 服务时,日志往往默认就开着,但线上吞吐下降、延迟升高,问题未必出在业务代码,也可能是日志链路本身吃掉了 CPU、I/O 和主线程时间。
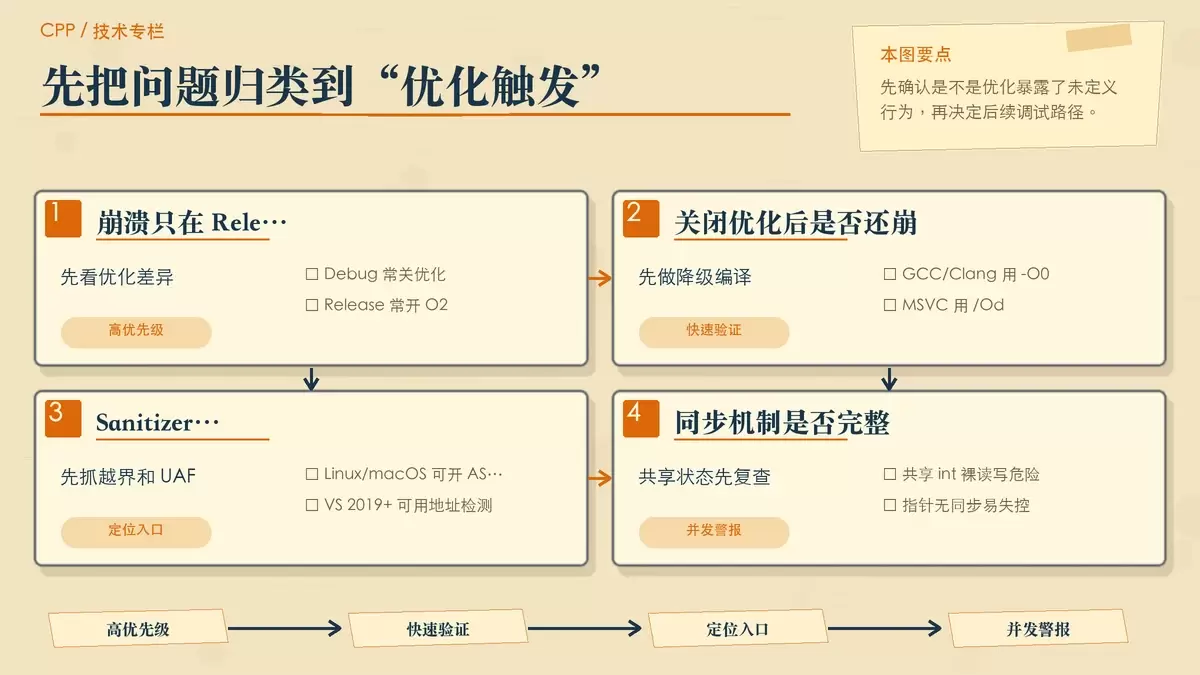
C++ 多线程程序出现“Debug 正常、Release 崩溃”,通常不是编译器出错,而是优化把原本潜伏的未定义行为提前暴露出来。本文按“先确认是否由优化触发,再借助符号、反汇编和 Sanitizer 定位,最后回到生命周期与同步边界修正”这条路径,梳理一套更适合实战排查的思路。
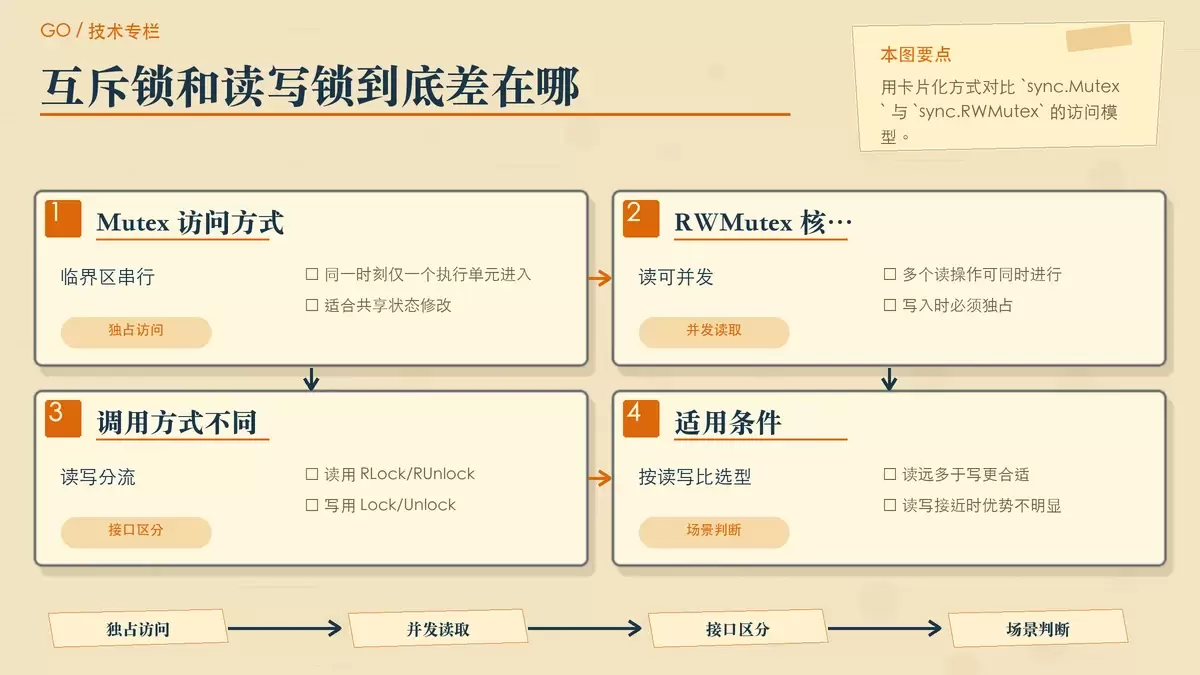
Go 并发里最常见的问题,不是怎么启动 goroutine,而是共享数据一旦被同时读写,结果为什么会变得不可靠。本文围绕 `sync.Mutex`、`sync.RWMutex` 和 `sync.WaitGroup` 的实际用法展开,说明它们分别解决什么问题、适合什么场景,以及选型时该看哪些信号。
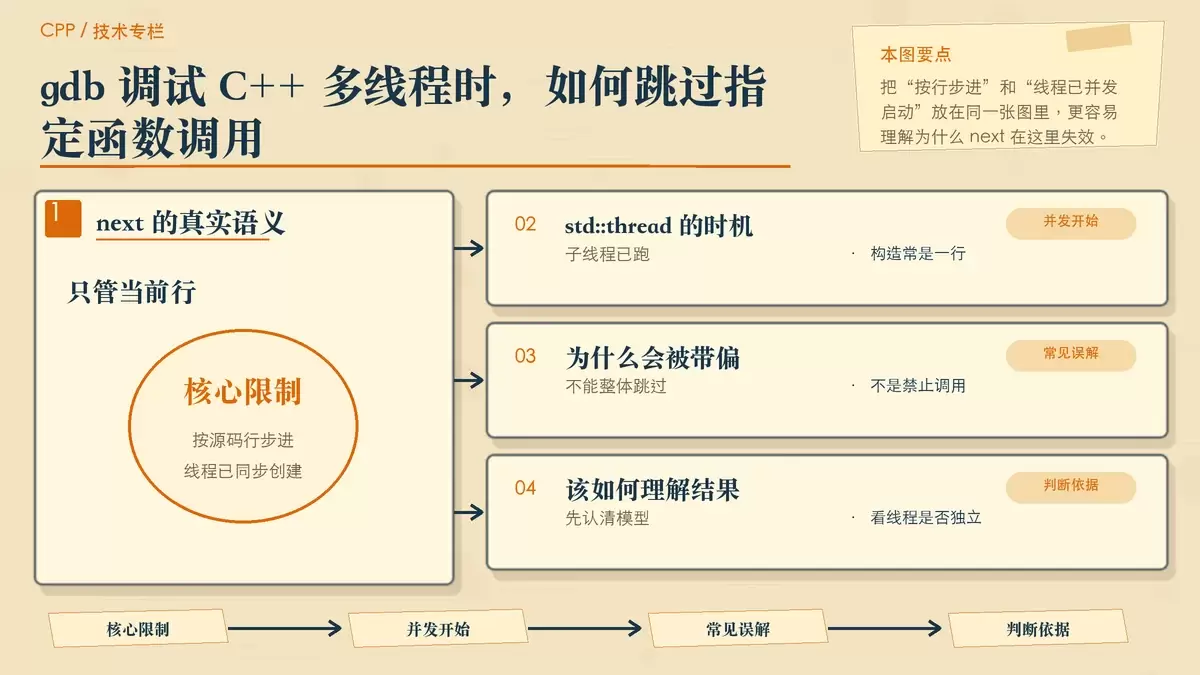
在 GDB 调试 C++ 多线程程序时,很多人会以为 `next` 可以像单线程那样跳过函数调用,但 `std::thread` 启动线程后,子线程会立即并发运行,这条路行不通。本文把“跳过线程函数”拆成断点控制、函数退出和线程调度三件事,说明哪些做法有效,哪些只是表面绕开。
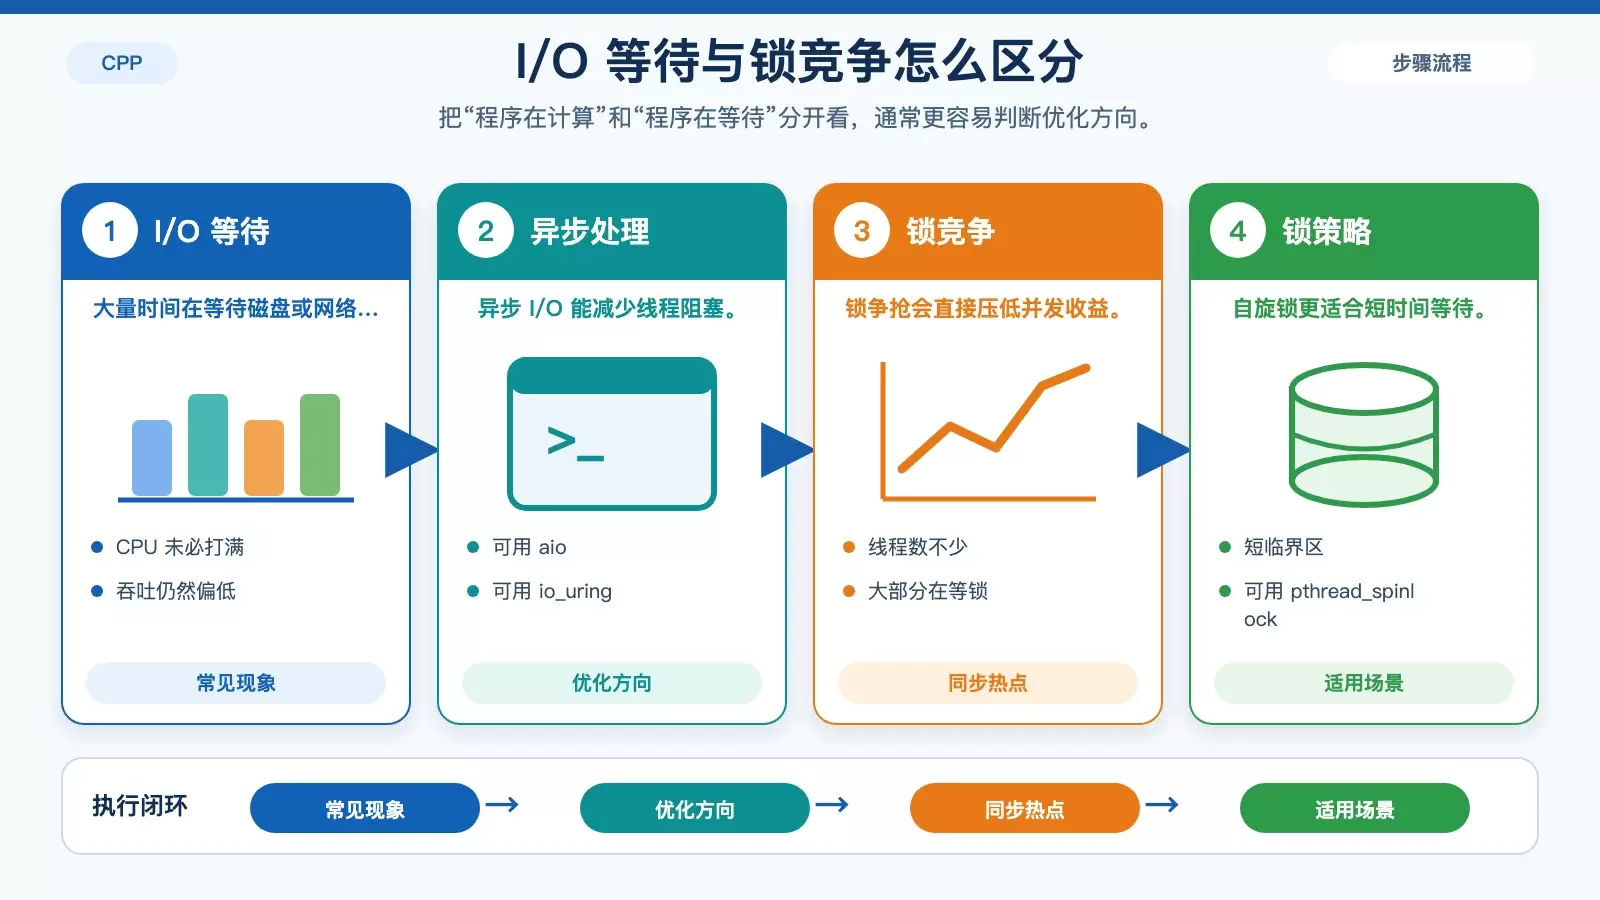
Linux 下的 C++ 程序变慢,通常不是单一原因,而是 CPU、内存、I/O、锁竞争、系统调用以及编译优化共同作用的结果。本文按常见瓶颈拆解现象与处理思路,并补上 perf、valgrind、iostat 等定位工具的使用场景,帮助你先判断问题落在哪一层,再决定该改代码、调参数还是换硬件。
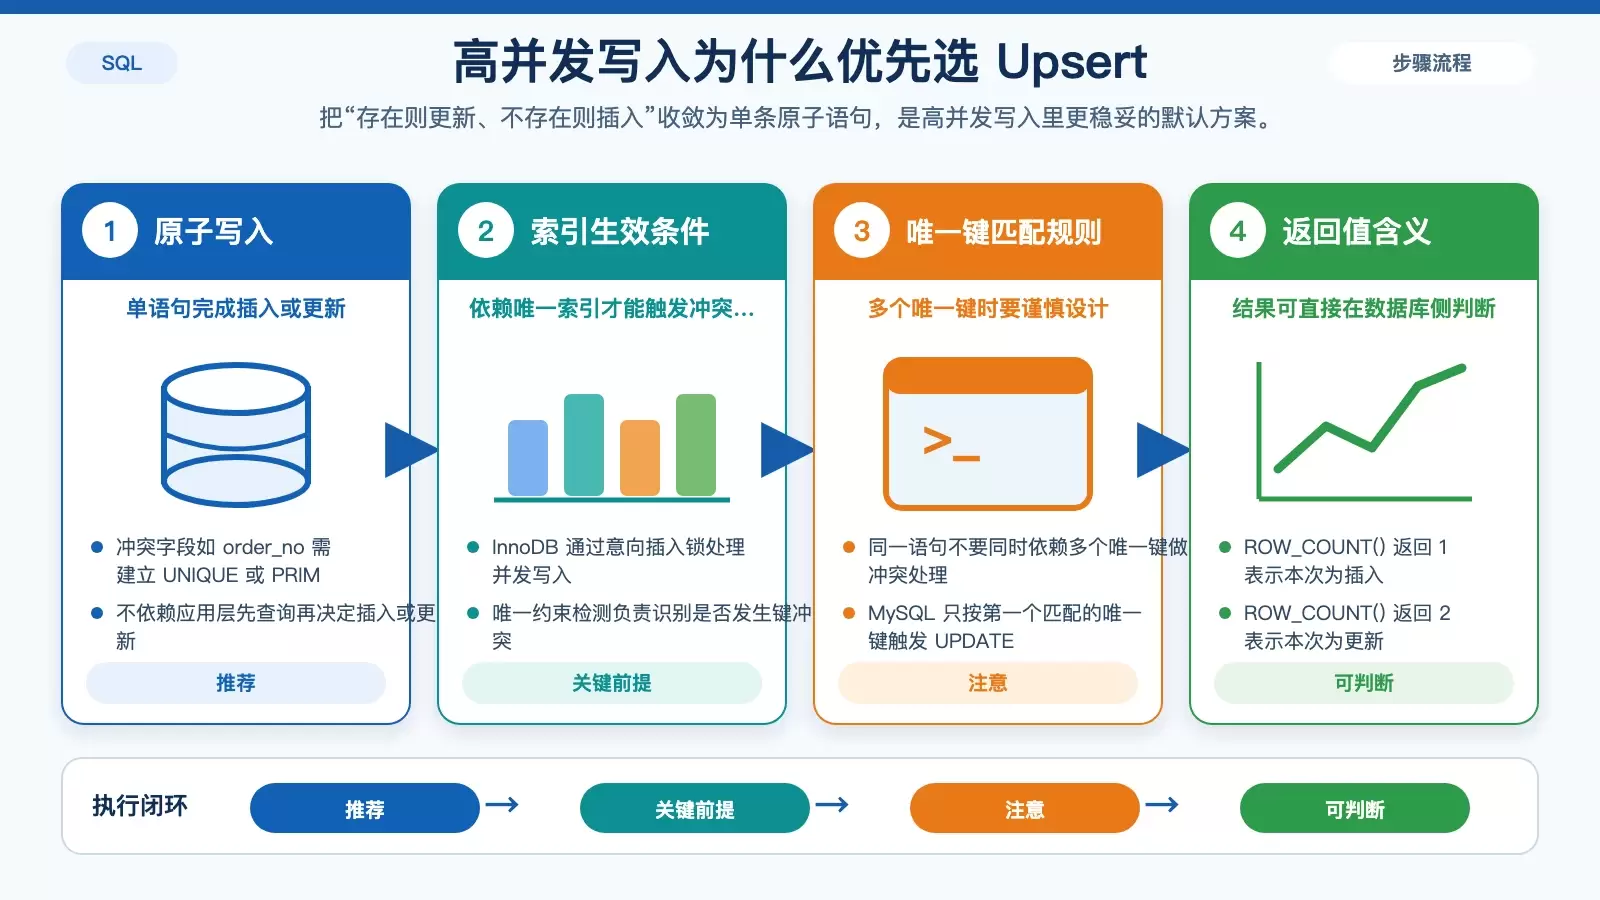
高并发插入真正容易触发死锁的,通常不是单纯的 `INSERT`,而是“先查后插”里混用了 `SELECT ... FOR UPDATE`、无索引条件和跨表事务。本文按可直接落地的判断顺序,说明为什么 `INSERT ... ON DUPLICATE KEY UPDATE` 更稳,以及什么情况下才能谨慎使用行锁方案。
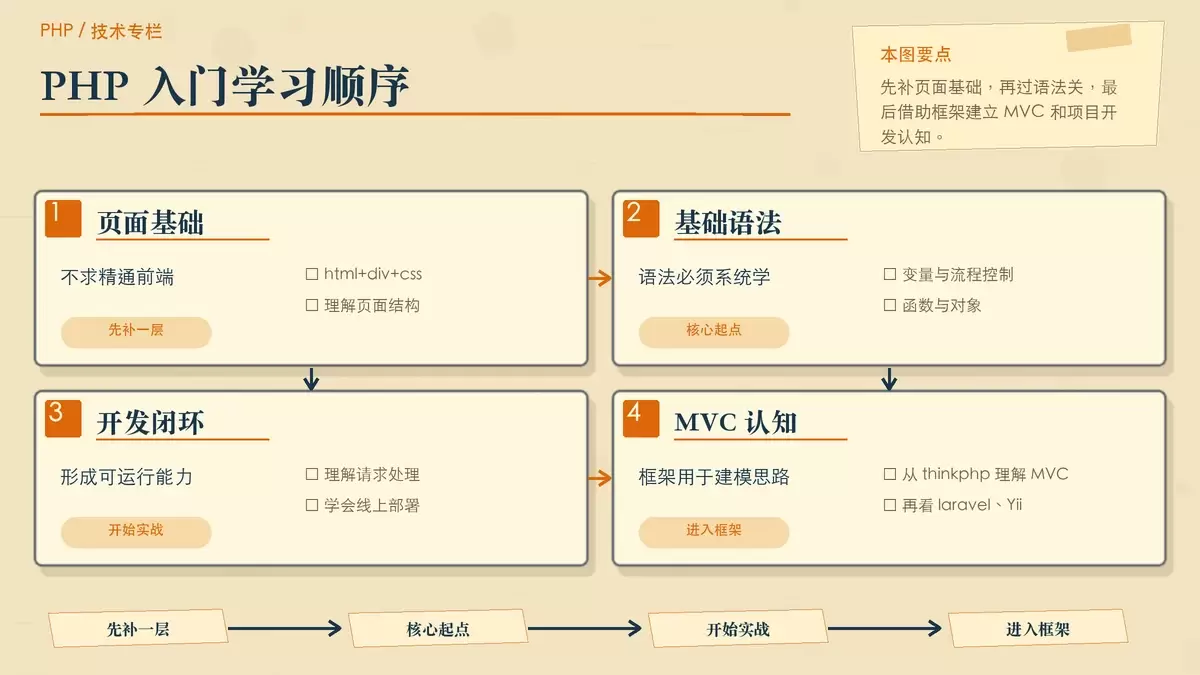
这篇文章把“如何学 PHP”拆成可执行的几步:先判断 PHP 适合解决什么问题,再按基础语法、前端配合、MVC 框架到缓存与高并发技术逐层推进。重点不在照搬别人的路线,而是根据你的背景选择更省时间的学习顺序。
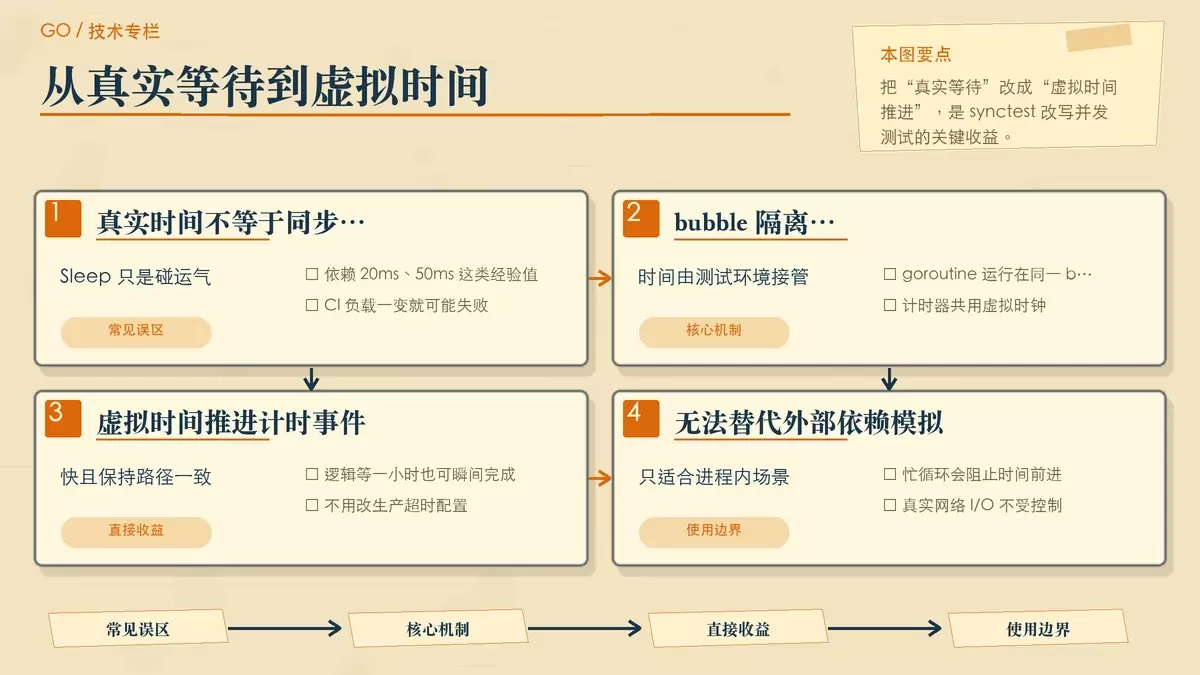
Go 并发测试里常见的 `time.Sleep` 看似简单,实际既拖慢执行,也会把测试结果交给机器负载和调度时机。随着 Go 1.25 将 `testing/synctest` 纳入稳定标准库,开发者可以用虚拟时间和明确同步点重写超时、定时器与异步逻辑测试。