Python连接MySQL中文乱码解决方案:SQLOBJECT与MySQLdb配置详解
本文详细解析Python连接MySQL时出现的UnicodeEncodeError及中文乱码问题。重点介绍如何在SQLOBJECT中使用use_unicode和charset参数,以及在MySQLdb中通过连接参数、sys.setdefaultencoding和MySQL配置文件my.cnf进行全链路UTF-8编码设置,确保数据读写正常。
2026-10-13
6

本文详细解析Python连接MySQL时出现的UnicodeEncodeError及中文乱码问题。重点介绍如何在SQLOBJECT中使用use_unicode和charset参数,以及在MySQLdb中通过连接参数、sys.setdefaultencoding和MySQL配置文件my.cnf进行全链路UTF-8编码设置,确保数据读写正常。
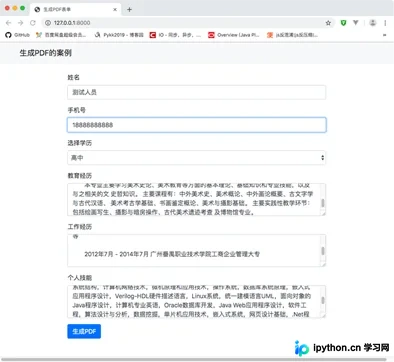
本文介绍如何在Django项目中利用xhtml2pdf库生成PDF文件,重点解决中文显示乱码问题。通过配置中文字体、编写表单验证与类视图,实现用户信息到PDF的转换。文章包含完整的安装步骤、代码示例及字体配置方法,帮助开发者快速实现PDF下载与预览功能。
本文介绍Python3中requests库处理HTTP响应时常见的中文乱码问题。由于requests自动猜测的encoding属性可能导致解码错误,建议直接使用content属性获取字节码,或手动设置正确的encoding(如gbk)以获取正确的unicode文本。
本文介绍在Python使用Matplotlib绘制图表时,解决X/Y轴中文标签显示为乱码的一种实用方法。通过在线工具将中文字符转换为ASCII编码(Unicode转义序列),直接嵌入代码字符串中,无需修改字体库文件即可实现中文正常显示,适用于3维及常规绘图场景。
本文针对Python3环境下使用HTMLTestRunner生成测试报告时出现的中文乱码问题,深入分析其根本原因。通过对比print输出与文件写入的差异,定位到文件打开方式未指定编码导致的编码错误。文章提供了两种有效的解决方案:一是在打开文件时显式设置encoding='utf-8';二是将写入模式改为二进制'wb'并对字符串进行UTF-8编码。
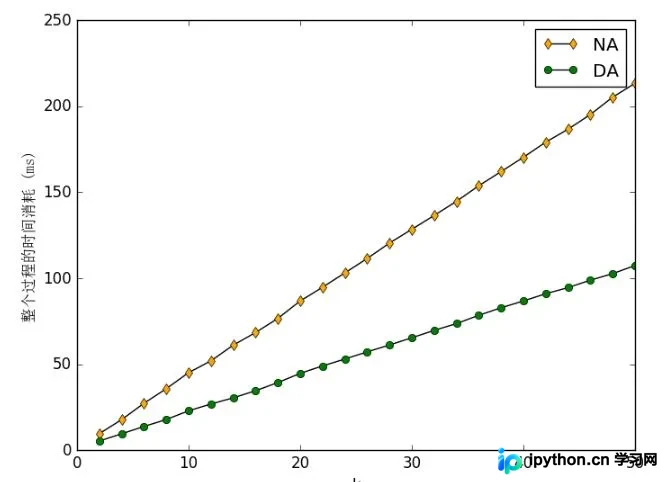
本文详细介绍解决Python Matplotlib库中文显示乱码的三种方法。包括修改全局配置文件matplotlibrc、通过代码重载配置以及自定义指定字体文件。重点讲解如何设置sans-serif字体及处理负号显示问题,帮助开发者快速实现高质量的中文图表输出。
Python3 默认使用 Unicode 编码,不再提供 sys.setdefaultencoding 方法。处理中文乱码时,应在输出序列化阶段通过 str.encode('GBK') 将字符串转换为本地编码字节串,从而实现与外部环境的兼容交互。
本文介绍Python读取包含中文的JSON文件时出现乱码的原因及解决方法。通过指定文件编码格式(如gbk)读取内容,并使用json.loads解析,最后利用json.dumps设置ensure_ascii=False参数输出,可有效避免中文显示异常。
本文解决Python中使用json.dumps将数据写入TXT文件时出现的中文Unicode编码问题。通过指定ensure_ascii=False参数,可强制输出真实中文字符而非ASCII转义序列,确保文件内容可读性。
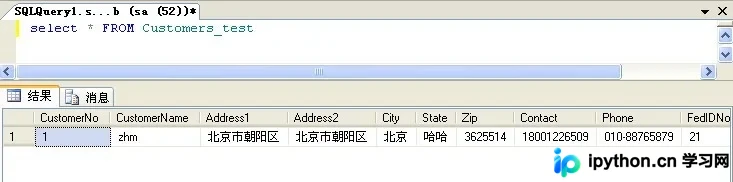
本文详解Python使用pyodbc库连接SQL Server 2008数据库的完整流程,涵盖连接字符串配置、游标操作及事务提交。重点解决中文数据显示为乱码问题,通过指定UTF-8字符集参数实现正确显示,并提供完整代码示例供参考。
本文介绍如何解决Pandas中使用to_json()导出中文数据时出现的\uXXXXXX乱码问题。通过设置force_ascii=False参数,可直接在to_json中保留中文。此外,文章还演示了如何将DataFrame转换为Python原生列表,利用json.dumps的ensure_ascii=False参数生成格式化的JSON数组,并提供了完整的封装类源码供参考。

本文分析Python爬虫中中文显示乱码的根本原因,即默认Unicode解析与系统编码格式不匹配。通过示例代码展示如何利用urllib获取网页,将UTF-8内容解码后重新编码为系统默认格式,从而完美解决中文输出乱码问题,适用于百度等常见网页抓取场景。