Python调用百度翻译API实现自动翻译
本文介绍如何使用Python标准库urllib和json模块调用百度翻译API。通过构造POST请求,设置User-Agent及kw参数,解析返回的JSON数据,实现简单的文本翻译功能。
2026-10-10
28

本文介绍如何使用Python标准库urllib和json模块调用百度翻译API。通过构造POST请求,设置User-Agent及kw参数,解析返回的JSON数据,实现简单的文本翻译功能。
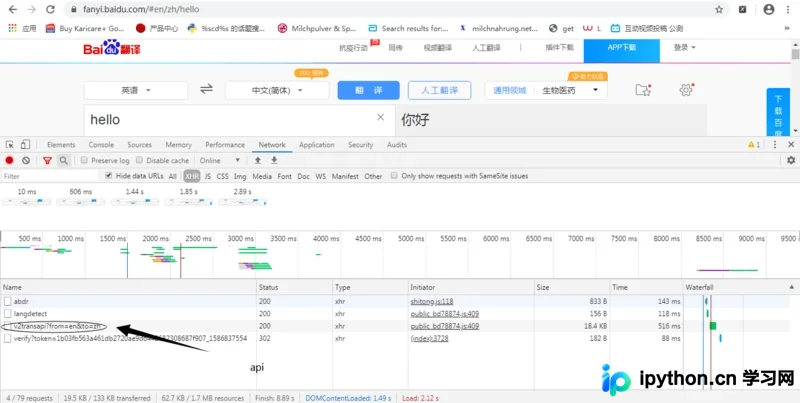
本文详解如何使用 Python 爬虫调用百度翻译接口。通过浏览器开发者工具定位 v2transapi 接口,获取 Cookie 和 Token 以通过基础验证。重点解析由 JS 算法生成的 Sign 参数,利用 Python 的 execjs 库执行 JS 代码动态生成签名,从而绕过百度翻译的反爬限制,实现稳定的文本翻译功能。
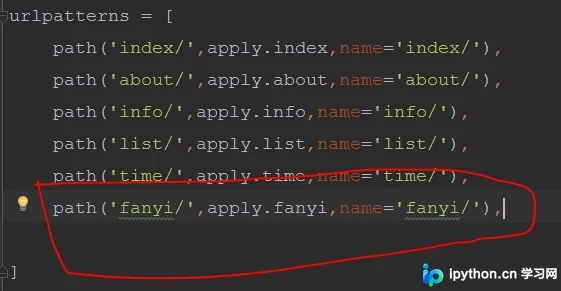
本文详细介绍如何在Django项目中集成百度翻译接口。内容涵盖路由配置、后端视图函数的编写、前端表单设计以及基于jQuery的异步提交处理。通过具体代码示例,展示如何获取用户输入、调用API并返回翻译结果,帮助开发者快速实现简单的英汉互译功能。
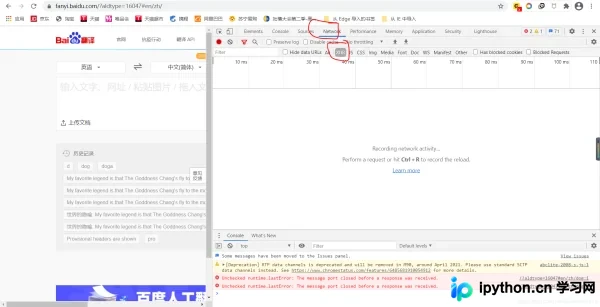
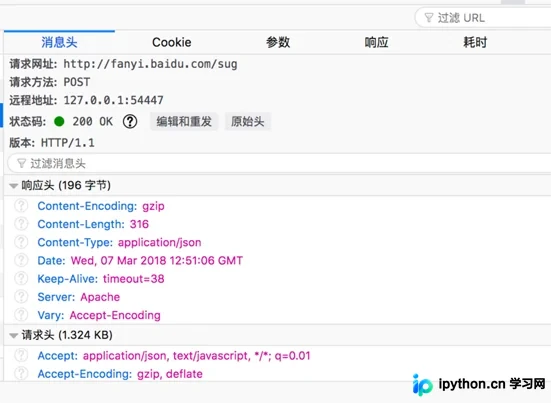
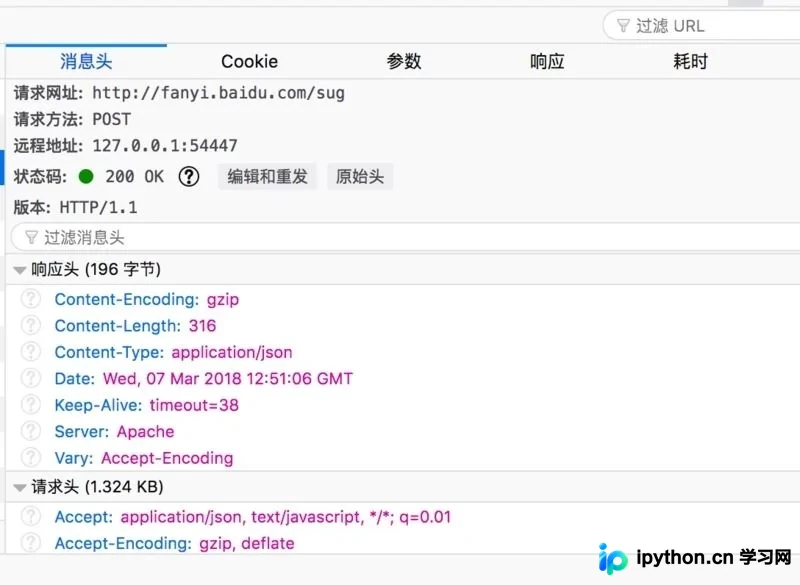
本文详解如何使用Python编写爬虫程序调用百度翻译接口。通过F12开发者工具分析网络请求,获取fanyi.baidu.com/sug接口及POST参数kw。结合urllib库构造请求头与数据,实现输入内容并输出翻译结果的核心功能,适合初学者快速上手网络爬虫开发。
本文介绍如何使用 Python 3 调用百度翻译 API 实现实时翻译功能。通过对比官方 Python 2 版本,详细说明了库名称的变更及代码实现,包括申请 AppID 和 SecretKey、构建请求参数、生成签名及处理 JSON 响应等步骤,帮助开发者快速搭建翻译工具。
本文详细讲解如何利用Python和requests库爬取百度翻译结果。通过浏览器开发者工具分析AJAX请求,定位fanyi.baidu.com/sug接口,构造包含kw参数的POST请求,并解析返回的JSON数据获取翻译内容。文章提供完整代码示例及注意事项,适合初学者学习动态网页数据抓取。