

Python读取CSV文件的5种实用方法详解
本文详细介绍Python中读取CSV文件的5种核心方法,涵盖基础迭代、namedtuple结构化访问、类型转换、内置DictReader以及自定义字典清洗。通过具体代码示例,帮助开发者根据数据清洗需求选择最优方案,提升数据处理效率与代码可读性。
2026-10-14
15

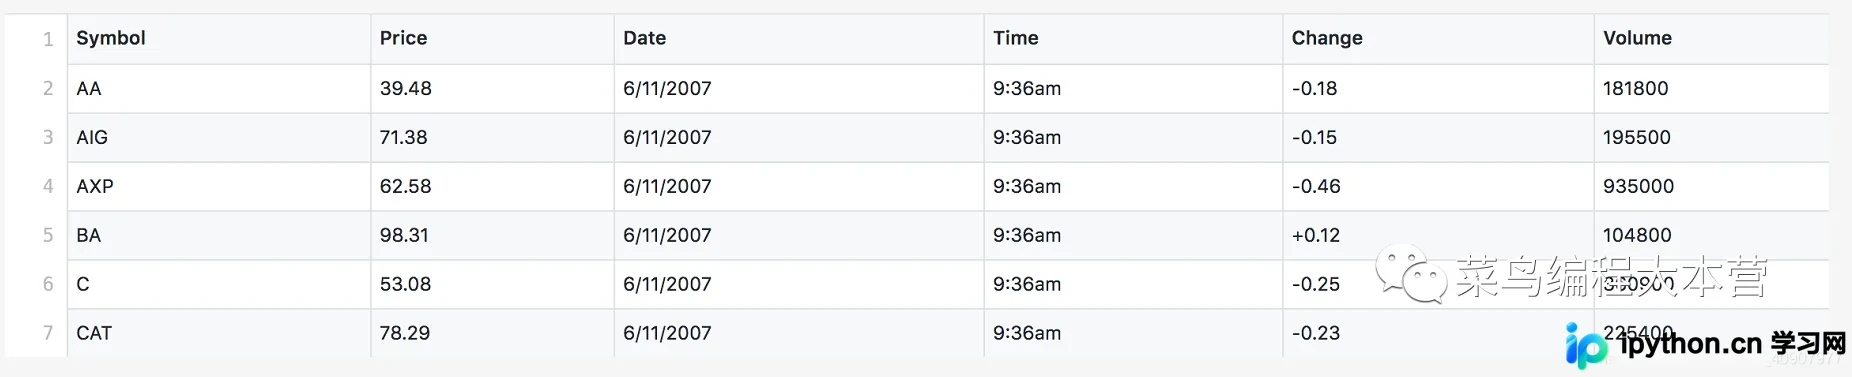
本文详细介绍Python中读取CSV文件的5种核心方法,涵盖基础迭代、namedtuple结构化访问、类型转换、内置DictReader以及自定义字典清洗。通过具体代码示例,帮助开发者根据数据清洗需求选择最优方案,提升数据处理效率与代码可读性。
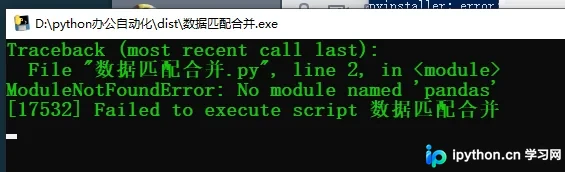
本文详细解析Python使用PyInstaller打包EXE后双击闪退的常见原因,重点指出PyCharm与IDLE环境模块路径不一致导致的模块缺失问题。通过截图CMD窗口错误信息定位“No module named”报错,并提供在IDLE环境下正确安装依赖及指定路径安装模块的解决方案,帮助开发者快速修复打包后的执行错误。
浏览器同源策略限制了不同源之间的资源访问。本文总结了四种经典的JavaScript跨域解决方法,包括利用iframe的window.name属性、通过script标签实现JSONP请求、jQuery封装的getJSON方法以及Flash的crossdomain.xml策略。了解这些方案有助于在实际开发中根据兼容性需求选择最合适的跨域手段。
本文澄清了SQL Server锁升级的常见误区,指出早期版本中页锁可直接升级为表锁。详细解析了SQL Server 2005/2008中通过跟踪标志1211和1224控制内存与锁行为的方法,并介绍ALTER TABLE命令中LOCK_ESCALATION参数(TABLE、AUTO、DISABLE)的具体作用及适用场景,帮助DBA优化资源管理并避免死锁风险。
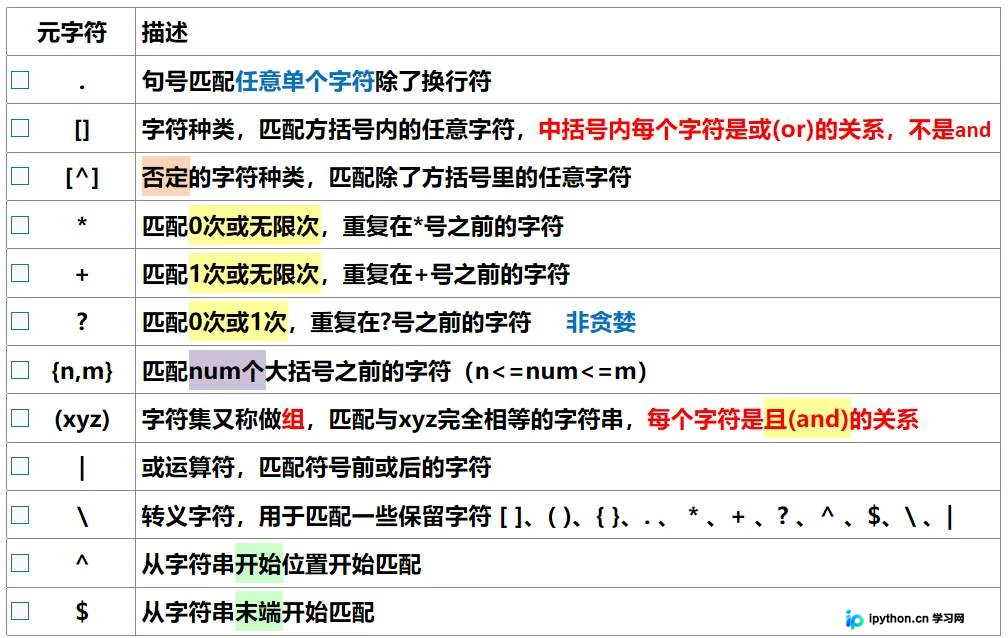
本文详细解析Python中re模块的正则表达式功能,涵盖数量词、字符匹配、边界匹配及分组等核心元字符。深入讲解findall、match、search和compile等关键方法的差异与使用场景,并通过包含大小写处理、贪婪与非贪婪模式、分组提取及字符串替换的完整代码示例,帮助开发者掌握高效的文本处理技巧。
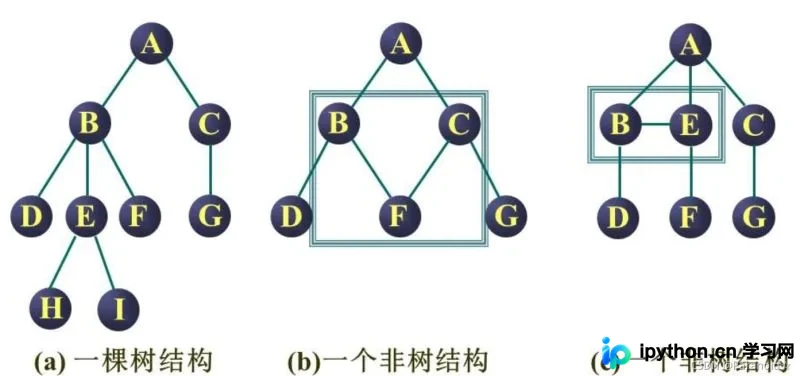
本文全面解读Python中的树数据结构,涵盖树的定义、基本术语如度、节点关系及深度,详细解析前序、后序和层序三种遍历算法,并深入探讨双亲、孩子链表、双亲孩子及孩子兄弟四种存储实现方式,帮助开发者掌握树的核心逻辑与代码实现。
当出现Slave_SQL_Running: No导致MySQL主从不同步时,可根据数据要求选择两种方案。数据要求不严可直接执行set global sql_slave_skip_counter跳过错误;若需数据完全一致,则需锁表备份后,在从库通过source恢复并reconfigure主从连接点实现重新同步。
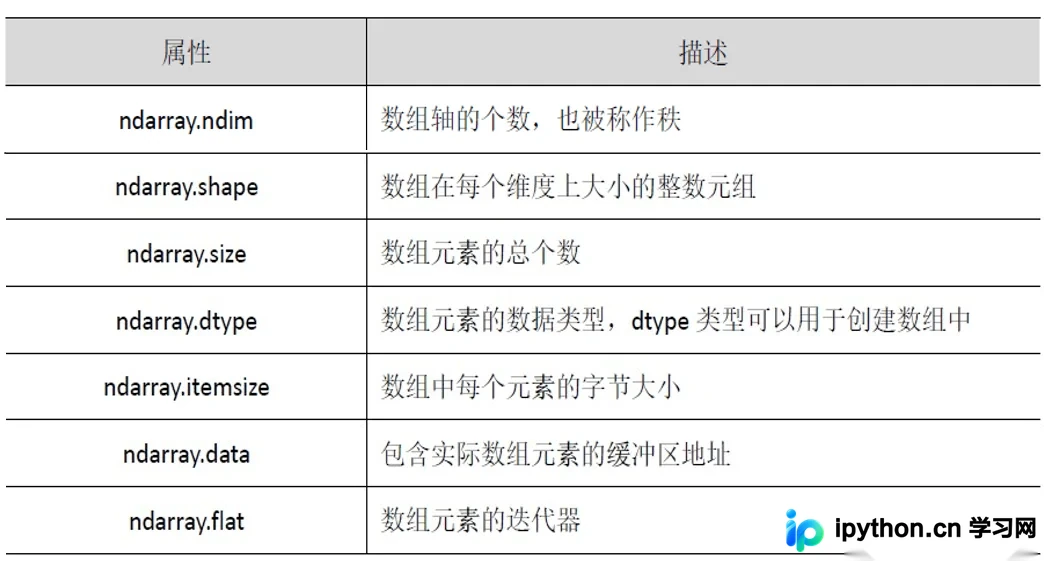
本文详解Python中Numpy库的基础应用,涵盖ndarray多维数组的创建、核心属性(ndim、shape、dtype等)解析,以及array、arange、zeros等常用创建函数的用法。同时介绍数组的索引与切片技巧,帮助读者快速掌握Numpy在数据分析中的关键操作。
本文介绍使用TensorFlow构建卷积神经网络(CNN)处理MNIST手写数字数据集的完整流程。网络包含两层卷积与池化及全连接层,通过1000至2000次迭代训练,测试集准确率分别达到98.6%与99.1%。相比传统神经网络,CNN凭借卷积核权值共享机制,在降低参数量与计算量的同时有效缓解过拟合,显著提升了模型性能。
本文详细解析Python调用C/C++动态链接库的六种主流方式。涵盖通过ctypes直接加载so文件、使用Python C API进行原生模块导出、利用Boost.Python简化绑定、以及通过Boost导出类、变参函数和Python内置对象接口。文中提供完整的C/C++源码、编译命令及测试示例,帮助开发者掌握不同场景下的混合编程技巧。
在C++开发中,将整数(int)转换为字符串(string)是常见操作。本文介绍了两种主流方法:基于C标准库的sprintf函数和C++11引入的std::to_string函数。通过代码示例展示具体用法、参数设置及注意事项,帮助开发者选择最合适且安全的转换方式。
本文介绍如何使用TensorFlow构建包含一个隐层的多层感知机(MLP)模型,以解决MNIST手写数字识别问题。相比基础的Softmax回归,引入隐层后模型准确率从92%提升至97%,误差率由8%降至3%。文章详细解析了网络结构、参数设置及训练效果,并探讨了全连接网络在MNIST上的性能瓶颈。