

Python数据结构之树的全面解读
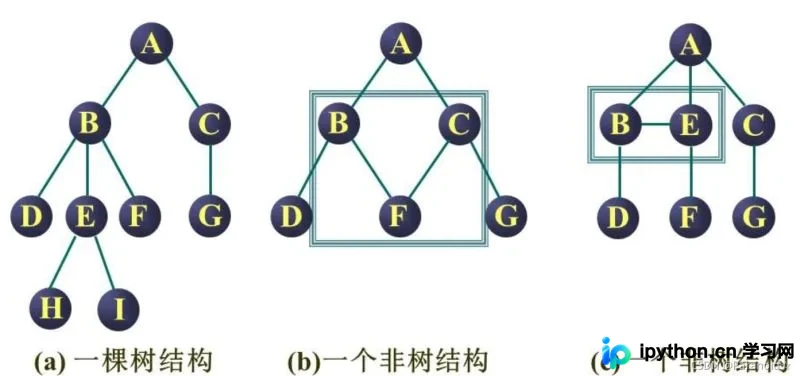
本文全面解读Python中的树数据结构,涵盖树的定义、基本术语如度、节点关系及深度,详细解析前序、后序和层序三种遍历算法,并深入探讨双亲、孩子链表、双亲孩子及孩子兄弟四种存储实现方式,帮助开发者掌握树的核心逻辑与代码实现。
2026-10-14
12

本文全面解读Python中的树数据结构,涵盖树的定义、基本术语如度、节点关系及深度,详细解析前序、后序和层序三种遍历算法,并深入探讨双亲、孩子链表、双亲孩子及孩子兄弟四种存储实现方式,帮助开发者掌握树的核心逻辑与代码实现。
当出现Slave_SQL_Running: No导致MySQL主从不同步时,可根据数据要求选择两种方案。数据要求不严可直接执行set global sql_slave_skip_counter跳过错误;若需数据完全一致,则需锁表备份后,在从库通过source恢复并reconfigure主从连接点实现重新同步。
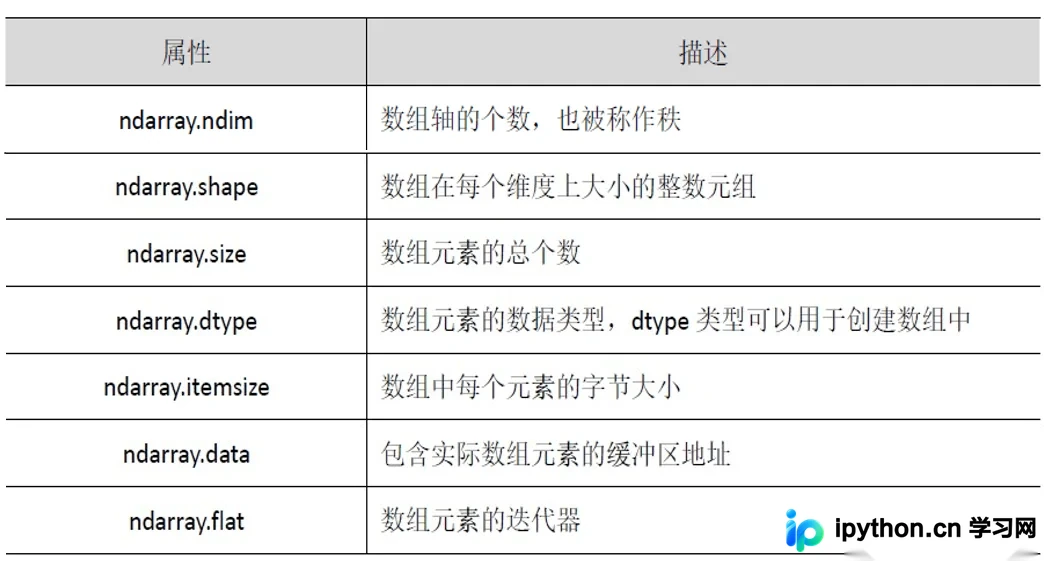
本文详解Python中Numpy库的基础应用,涵盖ndarray多维数组的创建、核心属性(ndim、shape、dtype等)解析,以及array、arange、zeros等常用创建函数的用法。同时介绍数组的索引与切片技巧,帮助读者快速掌握Numpy在数据分析中的关键操作。
本文介绍使用TensorFlow构建卷积神经网络(CNN)处理MNIST手写数字数据集的完整流程。网络包含两层卷积与池化及全连接层,通过1000至2000次迭代训练,测试集准确率分别达到98.6%与99.1%。相比传统神经网络,CNN凭借卷积核权值共享机制,在降低参数量与计算量的同时有效缓解过拟合,显著提升了模型性能。
本文详细解析Python调用C/C++动态链接库的六种主流方式。涵盖通过ctypes直接加载so文件、使用Python C API进行原生模块导出、利用Boost.Python简化绑定、以及通过Boost导出类、变参函数和Python内置对象接口。文中提供完整的C/C++源码、编译命令及测试示例,帮助开发者掌握不同场景下的混合编程技巧。
在C++开发中,将整数(int)转换为字符串(string)是常见操作。本文介绍了两种主流方法:基于C标准库的sprintf函数和C++11引入的std::to_string函数。通过代码示例展示具体用法、参数设置及注意事项,帮助开发者选择最合适且安全的转换方式。
本文介绍如何使用TensorFlow构建包含一个隐层的多层感知机(MLP)模型,以解决MNIST手写数字识别问题。相比基础的Softmax回归,引入隐层后模型准确率从92%提升至97%,误差率由8%降至3%。文章详细解析了网络结构、参数设置及训练效果,并探讨了全连接网络在MNIST上的性能瓶颈。
本文解析如何在 C# 中通过定义委托类型并创建通用的模板遍历方法,结合匿名方法与 Lambda 表达式来处理数组或集合的迭代逻辑。这种方式有效消除了传统模板方法模式中需要大量子类的冗余,提升了代码的可复用性和简洁性,是 .NET 2.0 至 3.0 引入的新特性在算法封装中的实际应用。
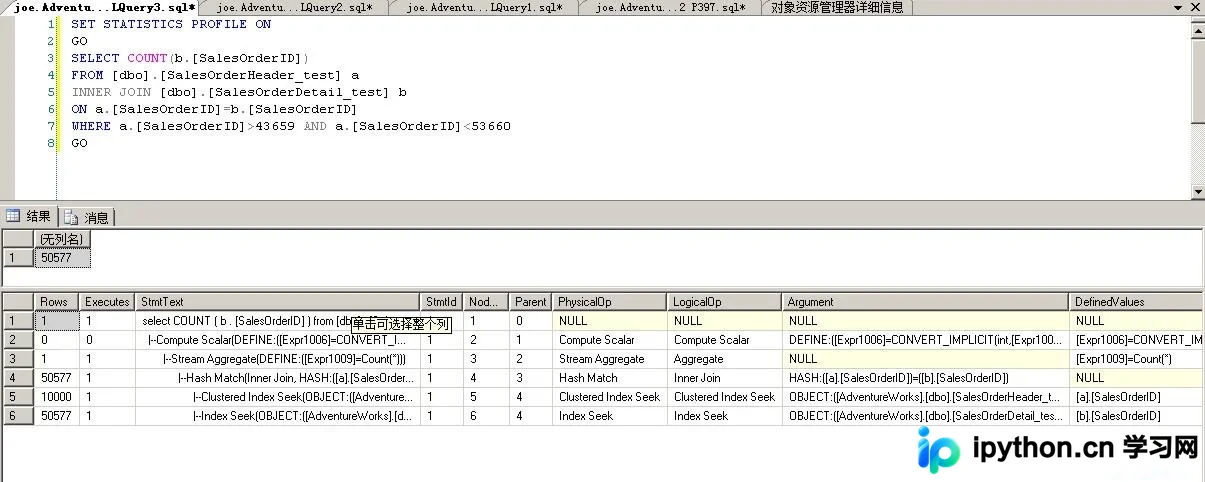
本文深入解析 SQL Server 中三个关键的性能收集开关:SET STATISTICS TIME ON、ON 和 OFF,以及 SET STATISTICS IO ON/OFF。通过对比清除缓存与命中缓存场景下的 CPU 时间、占用时间、逻辑/物理读取数,揭示 I/O 等待对性能的影响及缓存机制的价值。同时详细介绍如何运用 SET STATISTICS PROFILE ON 查看执行计划的实际行数(Rows)与预估行数(EstimateRows),以验证统计信息准确性并定位瓶颈步骤。
本文介绍使用TensorFlow构建Softmax逻辑回归模型识别MNIST手写数字数据集的方法。通过加载数据、定义模型并进行100次迭代训练,测试集准确率达到92.2%。文章还解析了相关TensorFlow函数的用法,适合深度学习初学者参考。
本文介绍Python数据分析的核心工具链。首先讲解Jupyter Notebook的基本操作与帮助获取方法;随后深入NumPy数组的创建、索引及形状变换;接着详解SciPy稀疏矩阵(CSR/LIL)在机器学习中的高效存储与格式转换;最后演示Matplotlib在Jupyter中的内联绘图及多种图表类型,为机器学习预处理提供基础支持。
解决SQL Server中TempDB文件数需与CPU核心数保持1:1的传统误区。通过监测sys.dm_os_wait_stats识别PAGELATCH等待类型,判断是否真正需要增加文件。现代SQL Server版本建议按1:2至1:4比例配置,或遵循小于8核使用1个、大于8核先设为8个文件的策略,以避免循环分配带来的额外开销和IO热点。