

SQL Server 统计信息调优:STATISTICS TIME/IO/PROFILE 实战解析

在数据库性能分析与调优过程中,除了关注执行计划本身的结构外,量化指标如编译耗时、执行耗时、磁盘 I/O 次数等也是诊断问题的关键依据。SQL Server 提供了 SET STATISTICS 系列指令,允许 DBA 和开发人员精确捕获单条语句的运行细节。
结果目标与准备条件
为了获取准确的性能基线数据,消除前序操作或缓存对测试结果的干扰,通常在正式测试前需要清空当前的内存状态。
- 清空数据缓存:使用
DBCC DROPCLEANBUFFERS清除 Buffer Pool 中的数据页,强制后续查询从磁盘读取,模拟冷启动环境。 - 清空执行计划缓存:使用
DBCC FREEPROCCACHE清除计划缓存,迫使 SQL Server 重新进行分析和编译,模拟首次运行环境。
第 1 步:收集时间与 CPU 资源消耗
该指标主要反映语句在编译和执行两个阶段所消耗的时间资源,有助于区分是计算密集型的 CPU 瓶颈,还是受限于 I/O 等待或阻塞。
开启统计与信息解读
执行以下命令开启时间统计:
SET STATISTICS TIME ON;随后执行具体的业务查询。例如:
SELECT DISTINCT([ProductID]),[UnitPrice] FROM [dbo].[SalesOrderDetail_test] WHERE [ProductID]=777;
完成后关闭设置:
SET STATISTICS TIME OFF;
核心指标说明
输出结果通常分为“分析与编译”、“执行”两部分,包含两个关键字段:
- CPU 时间:处理器用于处理该步骤的纯运算时间总和(多核环境下为各核时间之和)。
- 占用时间(Elapsed Time):从开始到结束的实际流逝时间。若此数值远大于 CPU 时间,通常意味着发生了 I/O 等待、死锁阻塞或网络延迟等非 CPU 计算开销。
典型表现对比:
- 冷启动(清缓存后):I/O 负载高,占用时间显著长于 CPU 时间(例如占用 1900ms vs CPU 170ms)。
- 热启动(命中缓存):无需磁盘 I/O,占用时间与 CPU 时间接近(例如 169ms vs 156ms)。
这直观地展示了内存缓冲机制对查询性能的增益作用。
第 2 步:监控物理与逻辑 I/O 操作
I/O 是数据库性能的最常见瓶颈之一。SET STATISTICS IO ON 能够揭示查询涉及的具体 I/O 成本。
开启统计
SET STATISTICS IO ON;
-- 在此处执行测试查询
SET STATISTICS IO OFF;
输出字段深度解析
输出信息针对涉及的每一张表列出以下统计值:
| 指标名称 | 含义与意义 |
|---|---|
| 扫描计数 (Scan Count) | 访问表的次数。大表频繁全表扫描会导致性能低下(并发线程除外)。 |
| 逻辑读取 (Logical Reads) | 从内存缓存中读取的数据页数。**这是衡量查询复杂度最核心的指标**,值越高说明查询越昂贵。 |
| 物理读取 (Physical Reads) | 从磁盘文件系统中实际读取的页数。不为 0 表示存在 Cache Miss,需优化索引或增加内存。 |
| 预读 (Pre_reads) | 为提高顺序读取效率而提前装入缓存的页数。 |
| LOB ... 类字段 | 专门针对大文本/二进制类型(varchar(max) 等)的 I/O 统计。 |
第 3 步:分析执行计划与实际偏差
仅仅知道“慢”是不够的,需要理解“为什么慢”。SET STATISTICS PROFILE ON 将执行计划转化为表格文本,展示每一步骤的详细执行情况。
操作步骤
执行联合查询测试:
SET STATISTICS PROFILE ON;
SELECT COUNT(b.[SalesOrderID])
FROM [dbo].[SalesOrderHeader_test] a
INNER JOIN [dbo].[SalesOrderDetail_test] b
ON a.[SalesOrderID]=b.[SalesOrderID]
WHERE a.[SalesOrderID]>43659 AND a.[SalesOrderID]<53660;
SET STATISTICS PROFILE OFF;
执行树解读
输出的结果集是一棵倒置的执行树结构,阅读顺序应从下往上:
- 执行顺序:位于底部的操作最先执行。随着层级向上,中间结果被传递和处理,直到最终返回结果集。
- Rows 与 EstimateRows:
EstimateRows:基于历史统计信息的预估行数。Rows:实际返回的行数。
两者差异越大,表明优化器对该步骤的数据分布预估越不准确,可能导致产生错误的连接方式(如哈希匹配代替了嵌套循环)或索引选择错误。
- Cost 权重 (TotalSubtreeCost):
- 代表当前节点及其子树的累计估算成本(包含 CPU 成本和 I/O 成本)。
- 可通过计算差值得知单个独立步骤的净成本。
- Warnings:显示是否存在诸如“没有可用的统计信息”等警告,提示可能存在优化盲区。
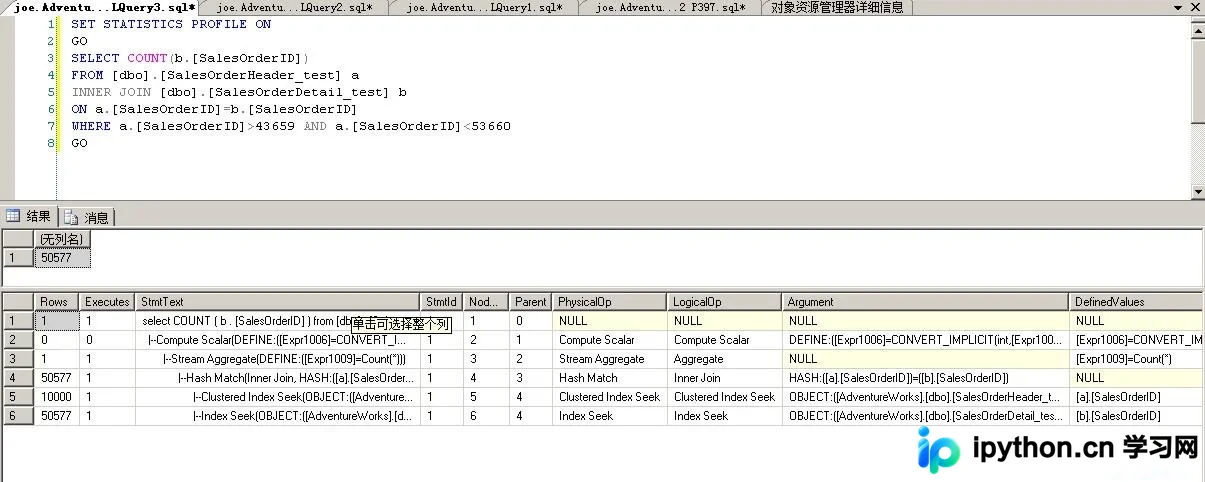
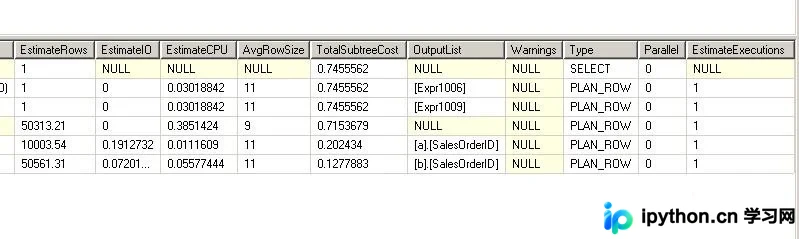
实例分析示例
在上述 Join 查询中:
- 步骤 A (底部):对两表分别进行 Seek 操作过滤主键范围。由于利用了聚集/非聚集索引,且预估行数与实际行数高度吻合(如预估 10000 行,实际 10000 行),说明统计信息准确,此处无隐患。
- 步骤 B (中部):Hash Match Join。由于输入基数较大,优化器选择了 Hash Join,预估与实际行数依然接近。
- 步骤 C (顶部):聚合计数(COUNT)。该步骤成本极低,几乎可以忽略。
通过分析这些步骤的 Cost 分布,可以快速定位导致整体查询昂贵的“重头戏”,进而针对性地进行索引调整或 SQL 改写。
简要总结
熟练掌握 SET STATISTICS TIME、IO 和 PROFILE 是数据库故障排查的基础技能。TIME 帮助我们识别资源类型瓶颈(CPU vs I/O),IO 量化了查询的数据抓取代价,而 PROFILE 则揭示了优化器决策过程中的准确度问题。将这些工具结合使用,能够全面剖析 SQL 语句的健康状况。
以上就是 SQL Server 收集和分析语句运行统计信息的详细内容,更多关于 SQL Server 性能调优的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









