Python Pandas实现两个表格内容模糊匹配:全连接与字典遍历两种方案
本文介绍在Python中使用Pandas库对两个表格进行内容模糊匹配的方法。方法一通过全连接后筛选,逻辑简单但内存消耗大;方法二利用字典遍历,适合大数据集。文章提供了具体的代码实现、步骤解析及结果展示,帮助开发者高效处理文本匹配任务。
2026-10-14
20

本文介绍在Python中使用Pandas库对两个表格进行内容模糊匹配的方法。方法一通过全连接后筛选,逻辑简单但内存消耗大;方法二利用字典遍历,适合大数据集。文章提供了具体的代码实现、步骤解析及结果展示,帮助开发者高效处理文本匹配任务。
本文详解MySQL中通过ALTER TABLE语句为表字段添加索引的完整方法。涵盖主键(Primary)、唯一(Uniqe)、普通(Index)及全文(Fulltext)索引的创建语法,并通过具体实例演示多列索引的添加及验证方式,帮助快速提升数据库查询效率。
本文介绍如何使用 Python 的 collections.Counter 模块查找列表中的奇偶异常项。通过列表推导式结合取余操作提取各项奇偶性,并利用 Counter 的 most_common() 方法确定多数奇偶性,从而筛选出与大多数项奇偶性质不同的元素。该方法简洁高效,适用于数据清洗和异常检测场景。
本文解析如何利用 Python 的 functools.reduce 函数计算列表的最小公倍数。通过结合 math.gcd 与 lambda 表达式,实现多数值的最小公倍数迭代计算。文章同时指出该示例代码未包含异常处理及负数边界情况,适用于学习思路而非直接生产环境。
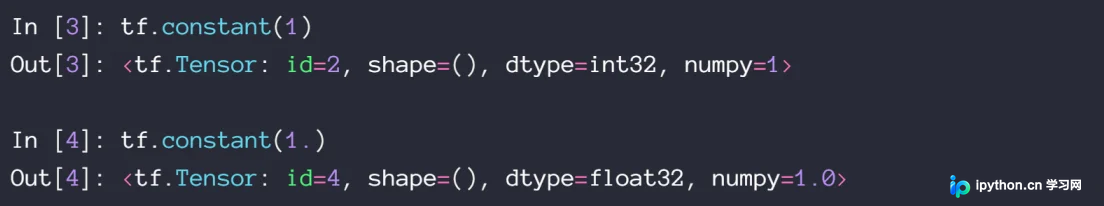
本文详细介绍TensorFlow中的核心数据类型,包括整型、浮点型、布尔型及字符串。重点解析如何查看Tensor的设备位置、形状、维度及类型信息,并深入讲解tf.convert_to_tensor与tf.cast两种转换方法的区别。特别强调在模型训练中,使用tf.Variable包装参数以启用梯度计算的重要性,帮助开发者正确处理数据格式与训练流程。
本文深入剖析JavaScript单线程模型下的调用堆栈(Call Stack)机制,解释setTimeout在设置零延迟时为何仍具延时效果。通过代码示例展示其如何脱离当前执行上下文进入任务队列,并介绍该特性在DOM更新和事件处理中的实际应用场景。
本文介绍C#中使用XmlSerializer将对象序列化为XML文件时的关键限制:仅支持公共属性、需无参构造函数且部分类型不可直接序列化。通过添加[XmlIgnore]特性忽略复杂字段,并展示完整的代码实现流程。
本文详细介绍 MySQL 的七种存储引擎(Storage Engines),重点解析事务型与非事务型的特性差异。内容涵盖 InnoDB、MyISAM、HEAP、MERGE、ISAM、BDB 及 Falcon (原 Gemini) 的技术原理与适用场景,帮助开发者根据数据并发、事务安全及查询性能需求选择合适的表类型。
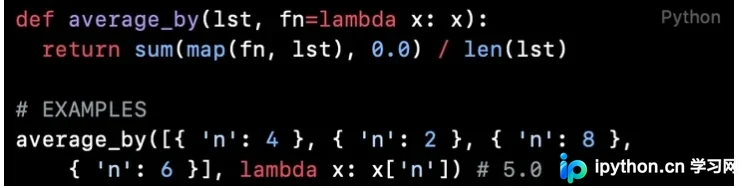
本文解析30-seconds-of-python库中的average_by函数,详解如何利用lambda匿名函数与map高阶函数提取列表数据并计算平均值。同时介绍max_by、min_by和sum_by等类似函数的用法,帮助开发者高效处理列表映射计算。
本文总结MySQL从MyISAM迁移至InnoDB引擎并搭建DRBD+Heartbeat双主多从架构的实战经验。重点解析主从异步延迟监控、Server-ID配置禁忌、中继日志工作原理及授权安全规范。针对同步中常见的1062重复键错误,对比了--single-transaction与--master-data=1备份策略的差异,确保数据一致性。
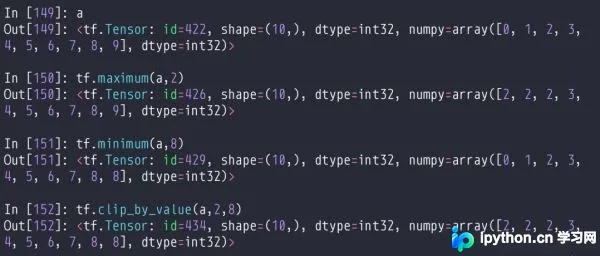
本文详细介绍TensorFlow中张量的核心高阶操作。涵盖按数值和范数进行张量裁剪以解决梯度爆炸问题,利用sort、argsort及topk进行数据排序与Top-K准确率计算。此外,解析tf.where条件筛选、tf.scatter_nd索引更新及tf.meshgrid网格生成等常用函数的具体用法与参数细节。
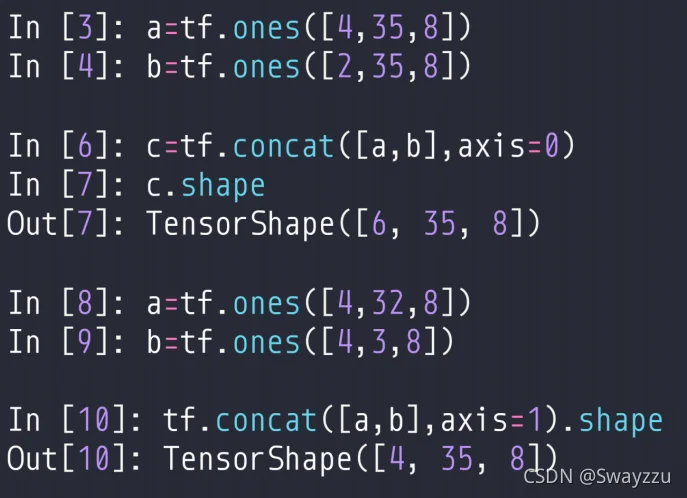
本文详解TensorFlow中数据合并与分割的核心函数,包括tf.concat、tf.split和tf.stack的维度处理规则。同时介绍数据统计操作,如tf.norm求范数、reduce系列求极值与均值,以及tf.argmax和tf.unique的使用方法与注意事项,帮助开发者掌握张量操作基础。