


很多团队一开始把触发器当成“顺手补逻辑”的位置,等到写入延迟突然飙升、批量导入变慢、主从延迟拉高,才发现问题出在一段平时几乎看不见的 SQL。判断标准其实很明确:只要触发器里开始出现 JOIN、聚合、子查询,或者无法稳定命中索引的查询,就不该再继续优化,而该把这类逻辑迁出触发器。
为什么复杂查询会拖垮触发器
触发器最大的限制,不在于语法,而在于执行位置。它是行级、同步、事务内执行的,这意味着主语句每影响一行,触发器里的逻辑就会跟着跑一次,而且这段开销直接计入当前 INSERT 或 UPDATE 的响应时间。
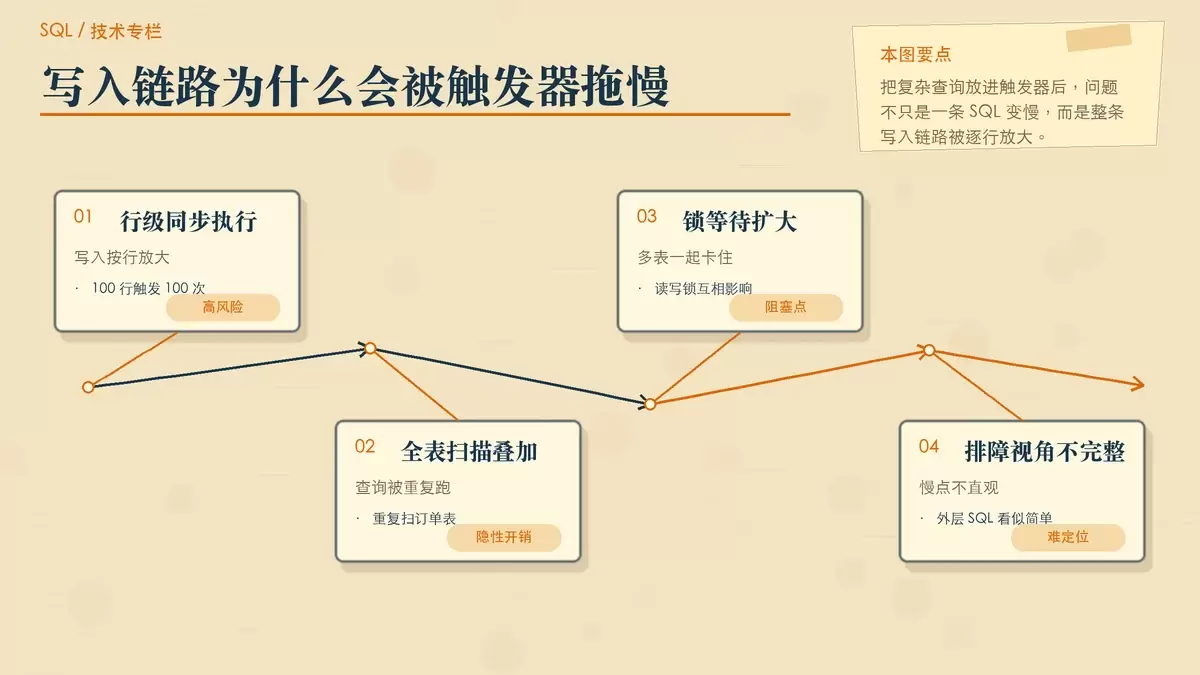
例如你一次插入 100 行,AFTER INSERT 就会执行 100 次;如果每次都跑一条:
SELECT SUM(amount) FROM orders WHERE user_id = NEW.user_id本质上就是把用户订单表重复扫描 100 次。即便表上有索引,问题也不会自动消失,因为触发器中的 SQL 仍然处在事务链路里,锁等待、CPU 消耗和 IO 压力都会直接叠加到写入操作上。
这也是为什么它容易从“单条 SQL 看起来还行”演变成“整条写入链路被拖慢”:一旦并发升高,多张表上的读写锁互相影响,原本毫秒级的写操作可能就会变成同步阻塞点。
- 触发器内部 SQL 不容易直接暴露在日常观察视角里,主语句看着简单,实际耗时却可能卡在隐藏查询上
- 批量写入时,逐行触发的成本会线性放大,尤其在
LOAD DATA INFILE这类场景下更明显 - 排查时常见线程卡在
Sending data或Updating,但慢日志记录的往往还是主语句本身
哪些写法一看就属于高危
在触发器里,所谓“复杂查询”并不需要复杂到多层嵌套。只要它会扩大扫描范围、引入跨表依赖,或让执行计划变得不稳定,就已经足够危险。下面这些写法,基本都应该视为应立即移除的对象:
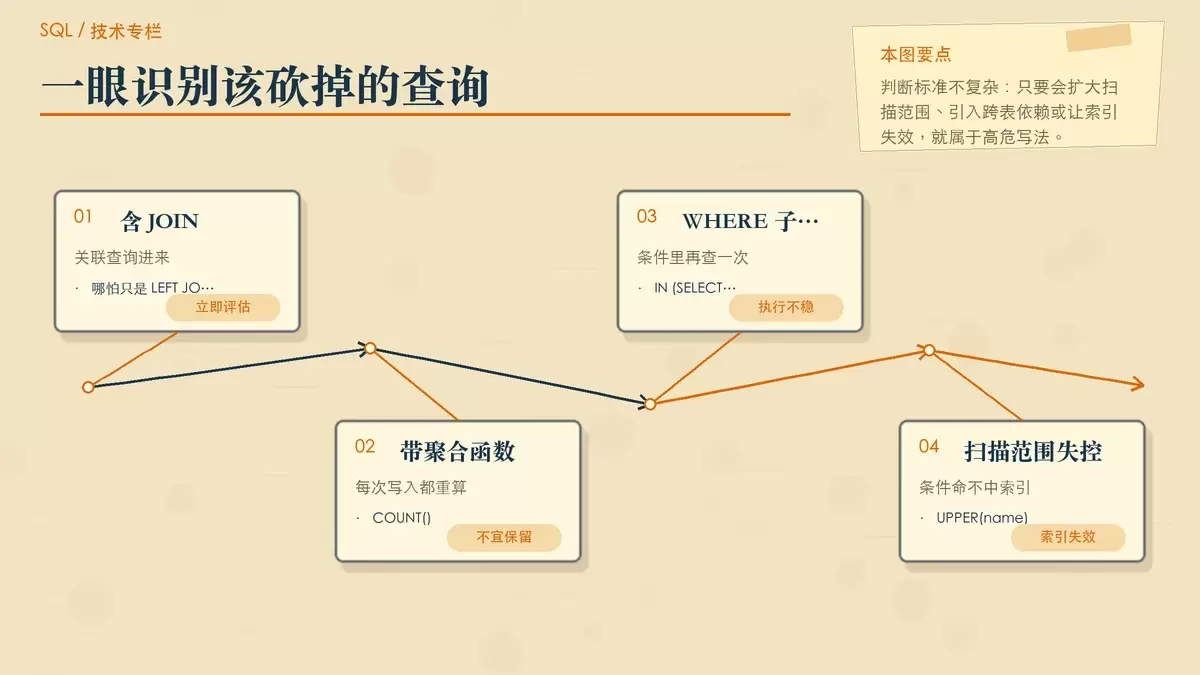
- 包含
JOIN,哪怕只是类似LEFT JOIN config这样的轻量关联 - 使用聚合函数,如
COUNT()、SUM()、MAX() - 在
WHERE中使用子查询,例如WHERE id IN (SELECT ...)或相关子查询 - 使用
SELECT *,或本应只取单行却没有加LIMIT 1 - 目标表缺少主键、索引,或者
WHERE条件本身无法命中索引
比如下面这种查询,即使看起来只是在按产品 ID 读一条状态,也不适合直接放进触发器:
SELECT status FROM product WHERE id = NEW.product_id如果没有配套索引、没有明确单行约束,或者后续又演变成附带判断逻辑的查询,它就很容易从“看上去没问题”滑向慢查询。类似地,下面这些条件也会让索引失效或利用率大幅下降:
UPPER(name)
LIKE '%xxx'
在普通查询里,这类问题已经值得警惕;放进触发器后,由于它会跟随每一行写入重复执行,风险会被成倍放大。
为什么这类问题尤其难排查
触发器的麻烦,不只是它慢,还在于它的慢经常是“藏起来的”。开发和运维看到的往往只是外层的 INSERT 或 UPDATE 变慢,但真正吃掉时间的,是触发器内部那条不显眼的查询。
一些典型现象包括:
- MySQL 的
EXPLAIN不会直接把触发器内 SQL 清晰地摊开给你看,外层语句可能看起来很快 SHOW PROCESSLIST只能看到线程状态异常堆积,却不一定能直接定位到触发器名- 问题往往不是在低并发开发环境暴露,而是在压测、高并发、批量导入或主从复制延迟升高时才出现
这会带来一个很现实的后果:真正危险的不是“这段触发器查询有点慢”,而是上线前你往往没有足够清晰的观测手段去证明它不会拖慢核心写入链路。等到现网出现延迟抖动,再回头拆触发器,回滚和迁移成本都已经明显升高。
替代思路:不要在触发器里跑这些查询
因此,处理方式通常不该是继续琢磨“怎么把触发器里的 JOIN 优化得更快”,而应转向更稳定的设计:让这类查询离开触发器。
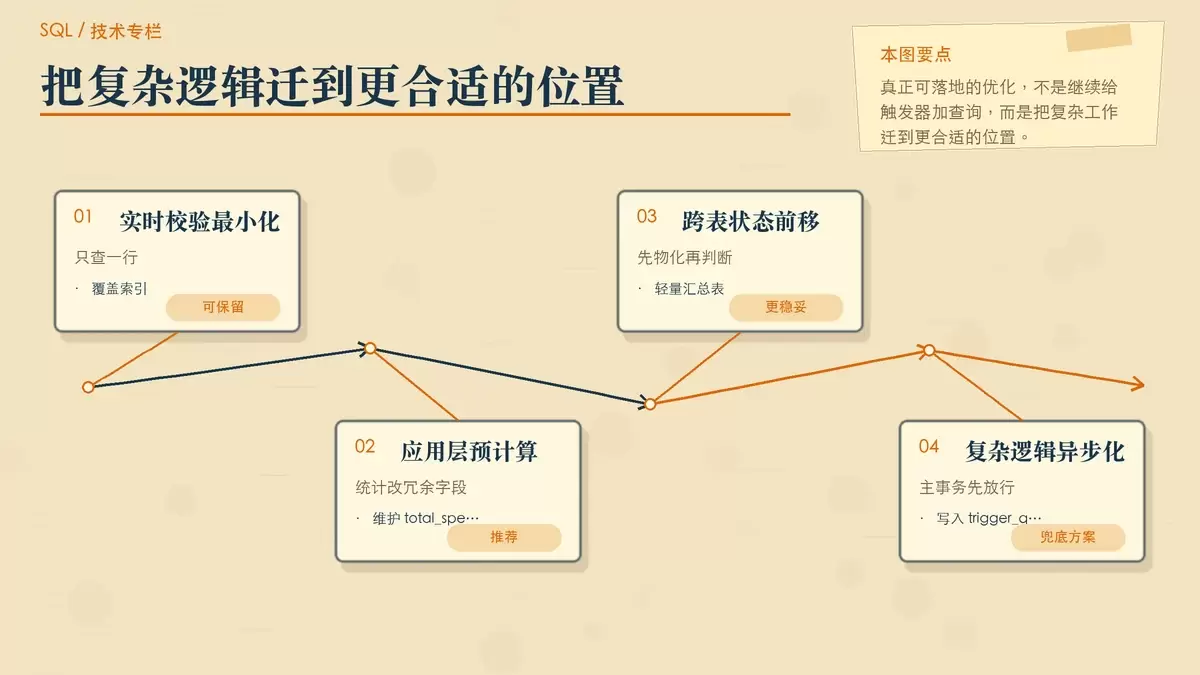
实时校验只保留单行、可锁定的查询
如果业务上确实要求实时校验,那就把范围收缩到最小,只保留可以稳定命中索引、且只读取一行的逻辑。例如:
SELECT ... FOR UPDATE LIMIT 1前提是有覆盖索引,并且目标明确是“查这一行”,而不是顺手带上额外关联和统计。
聚合统计改到应用层或冗余字段
如果需求本质上是累计值、汇总值或统计值,就不该每次写入都现场重算。更合适的做法,是由应用层维护冗余字段,或者在写入路径上同步更新轻量结果。例如用户总消费额,可以直接维护在用户表中的 total_spent 字段,而不是每次都重新聚合订单表。
NEW.total_spent := OLD.total_spent + NEW.amount跨表判断提前物化
如果触发器里要做的是跨表状态检查,可以把依赖数据提前整理到一张轻量汇总表中,例如 user_daily_summary。这样触发器读取的对象就从“大表+复杂条件”变成“面向当前判断的小表+确定索引”,代价更可控。
完全绕不开时,改成异步队列
如果逻辑既复杂又无法省略,最后的兜底方案也不应该是让触发器直接完成全部工作,而是把触发器简化成事件投递器:写入一条队列记录,然后交给后台进程异步消费。
INSERT INTO trigger_queue (table_name, row_id, event_type)这种“落库即走”的方式,至少能把复杂计算从主事务中拆出去,避免把在线写入链路变成所有后续逻辑的承载点。
实际判断标准:该删的尽早删
对触发器来说,最重要的原则不是“能不能写查询”,而是“这段逻辑会不会让每一行写入都多出不可控成本”。只要答案里包含跨表读取、聚合、子查询、索引不稳定,或者排障难度明显升高,就应默认它不适合继续留在触发器里。
换句话说,触发器适合做的是轻量、确定、单行级的动作;不适合承担统计、关联判断和复杂业务编排。把这些查询迁到应用层、汇总表或异步任务里,通常不是“架构更复杂”,而是在为写入性能、可观测性和后续维护成本止损。









