C++ 精度操纵器怎么用:从 setprecision 到高级格式化控制
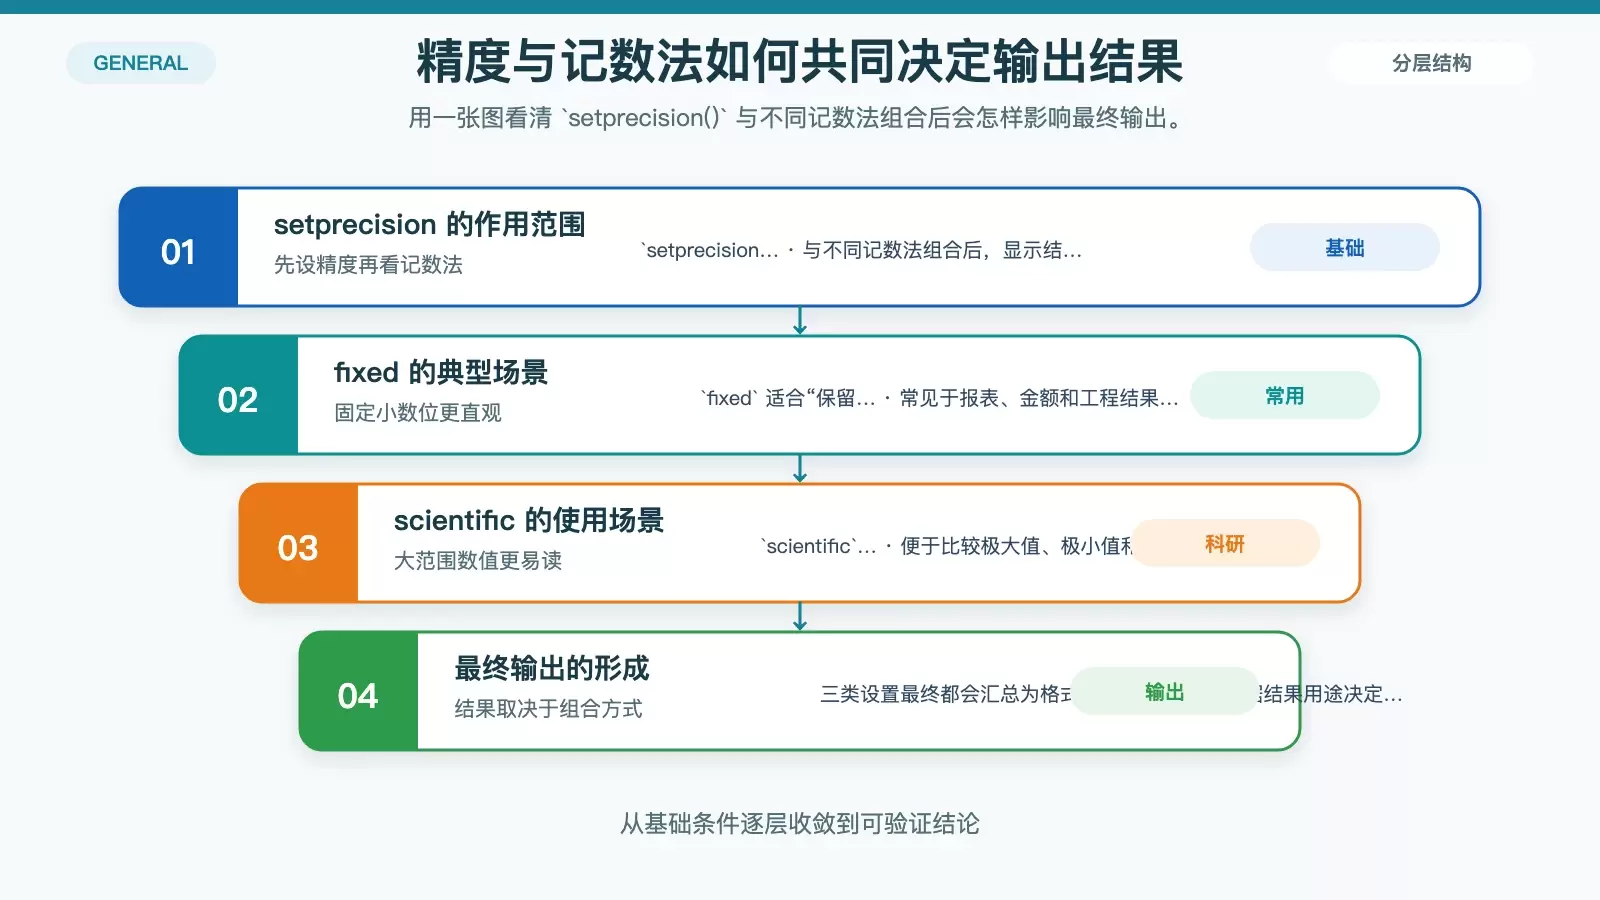
本文围绕 C++ 精度操纵器的实际用法展开,梳理 `setprecision()`、`fixed`、`scientific`、`setw()`、`setfill()` 等常见工具的作用与组合方式,并补充流状态管理、错误处理和性能取舍,帮助你判断不同输出场景该怎么选。 在 C++ 里,数字输出看似只是 `cout
2026-08-23
50

本文围绕 C++ 精度操纵器的实际用法展开,梳理 `setprecision()`、`fixed`、`scientific`、`setw()`、`setfill()` 等常见工具的作用与组合方式,并补充流状态管理、错误处理和性能取舍,帮助你判断不同输出场景该怎么选。 在 C++ 里,数字输出看似只是 `cout
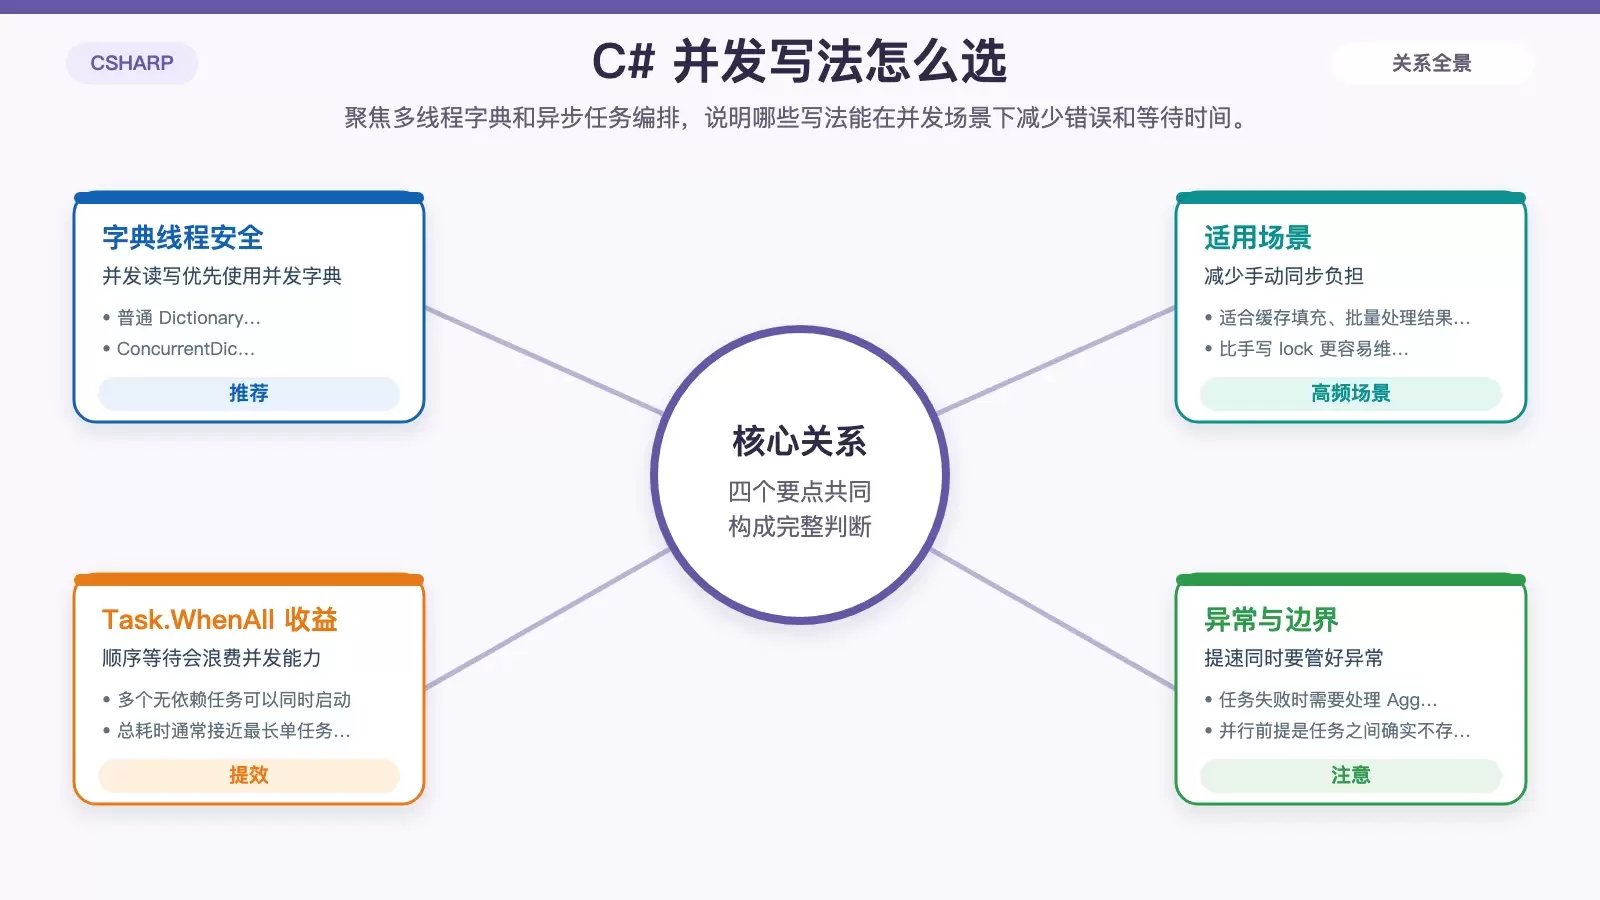
C# 凭 2.94% 的年度涨幅拿下 2025 年度编程语言,背后既有生态转型,也有语法和运行时层面的持续进化。本文结合 7 个常见开发细节,拆解并发、内存、日志、异步和新语法中的高频优化点,帮助你判断哪些写法更适合直接用于生产项目。
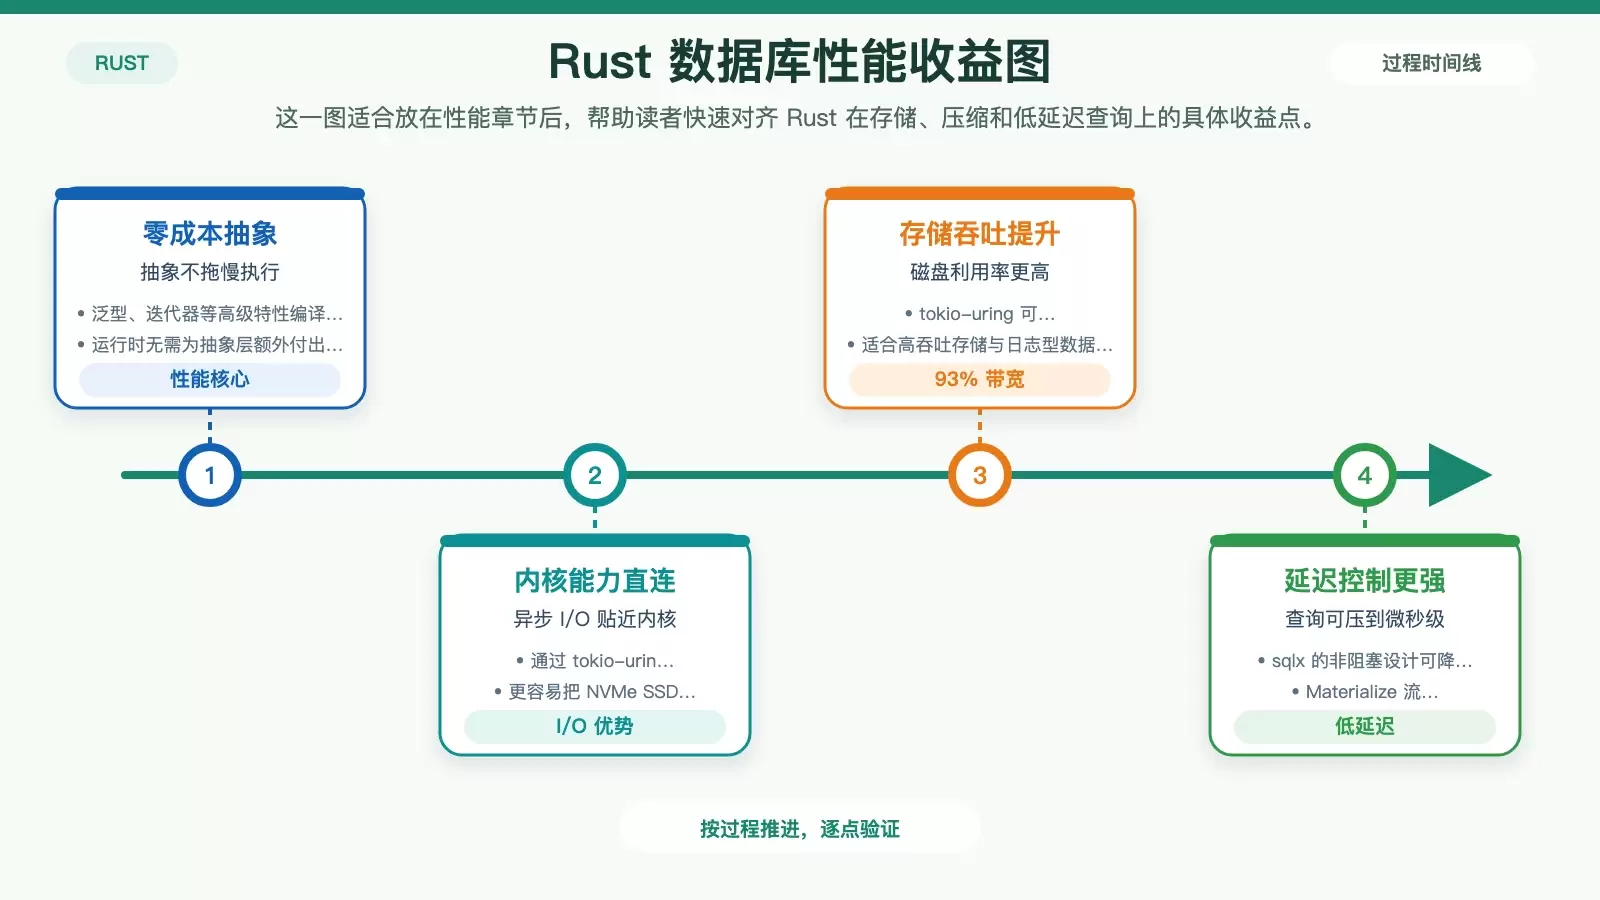
Rust 在 Linux 下做数据库操作的优势,不只体现在跑得快,更关键的是把稳定性、安全性和并发能力一起拉高。本文从内存安全、性能模型、类型系统、生态工具链和系统级安全配合几个方面拆开讲清,帮助你判断 Rust 是否适合数据库驱动、存储引擎或高并发数据服务场景。
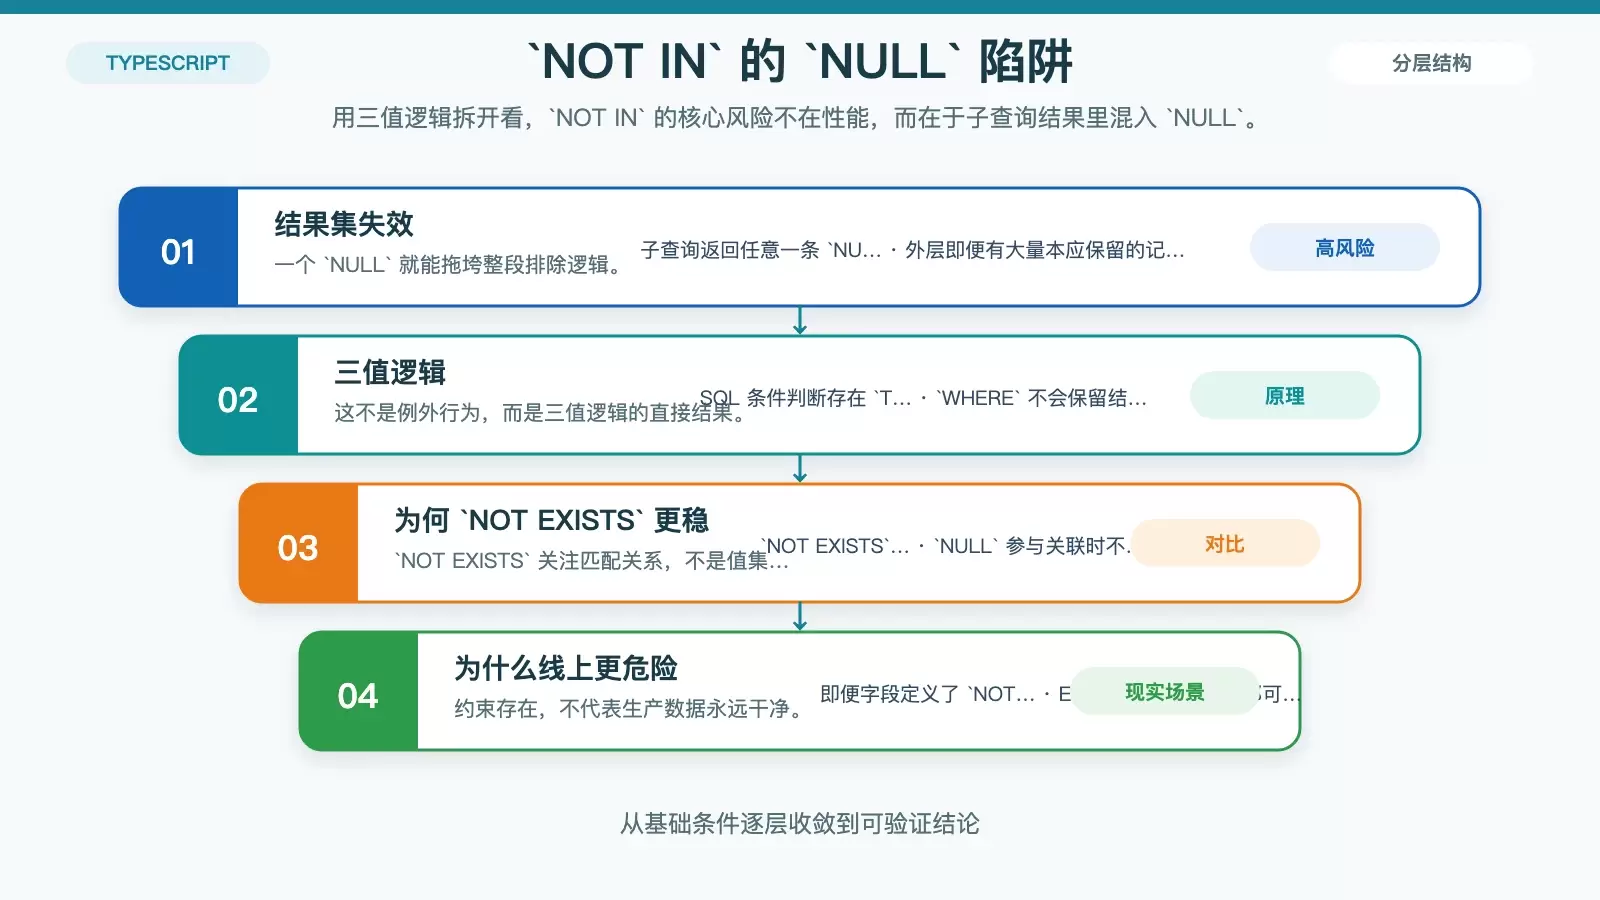
`NOT IN` 最大的问题不是慢,而是遇到 `NULL` 后可能直接把结果变成空集,造成业务逻辑误判。相比之下,`NOT EXISTS` 在空值安全、索引利用、关联表达和并发一致性上都更稳,更适合作为默认写法。 很多开发者会把 NOT IN 和 NOT EXISTS 当成语义接近、只差一点性能的两种写法,但真正容易把线上逻辑做错的,往往是 NULL 、隐式类型转换和并发下的。
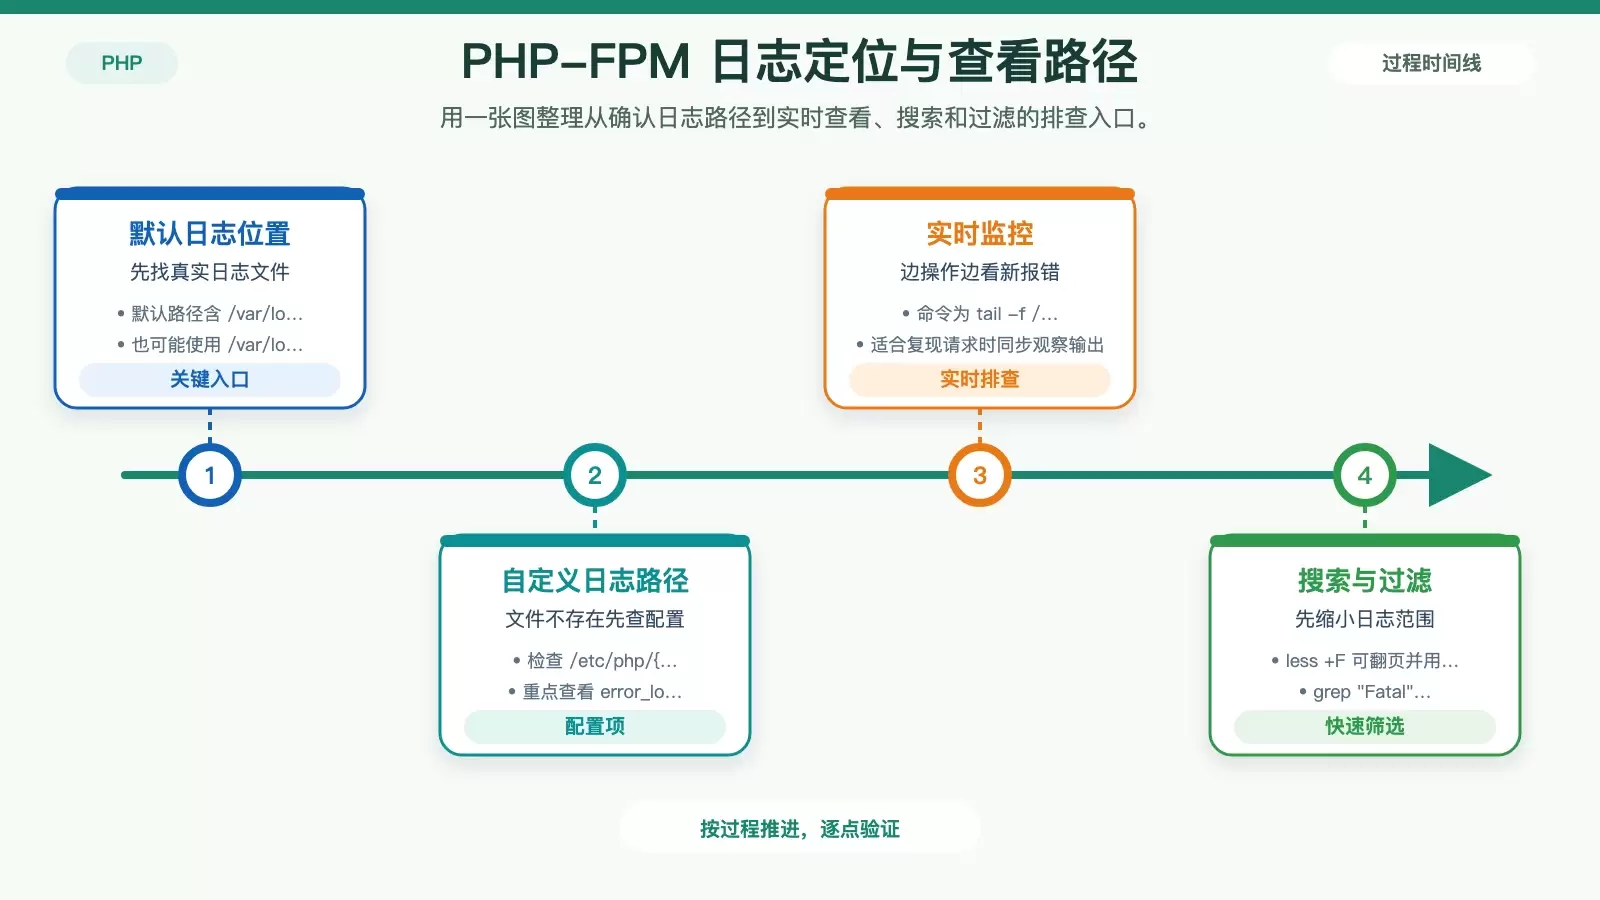
PHP-FPM 报错并不难读,关键是先找到正确日志,再按时间、级别、错误消息和请求上下文拆开看。本文结合 Ubuntu 环境中常见的日志路径、查看命令和典型报错,整理出一套更适合实际排障的阅读顺序。
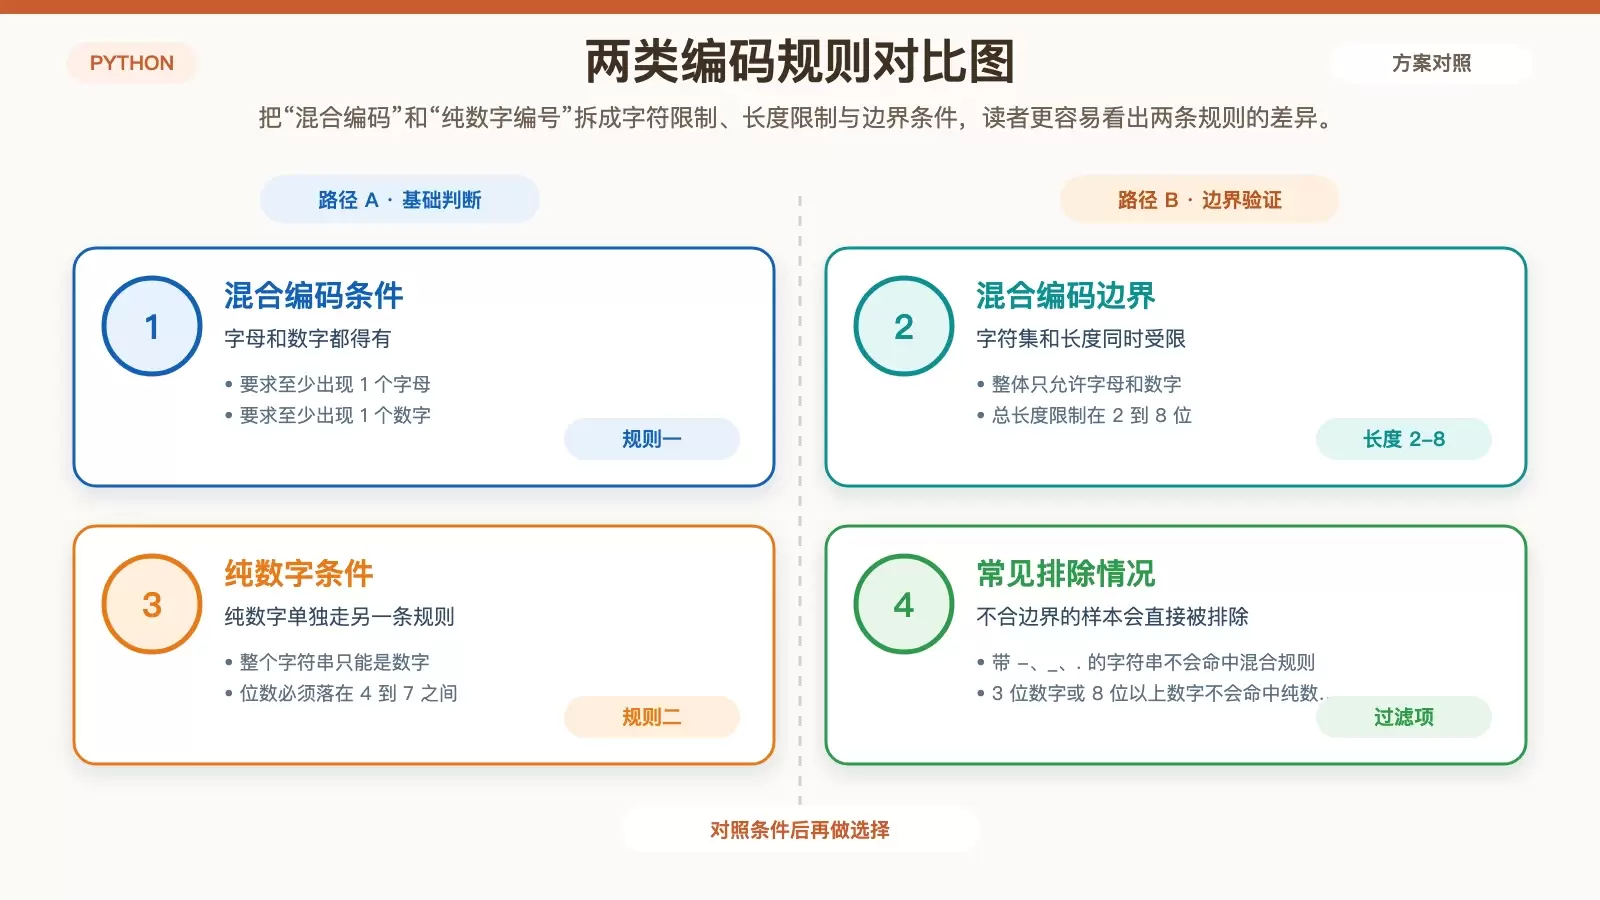
这篇文章用一个可直接运行的 Python 示例,讲清楚如何从文本里提取两类编号:2 到 8 位的字母数字混合串,以及 4 到 7 位的纯数字串。文中保留完整代码、逐段拆解正则规则,并结合测试样本说明为什么能匹配、为什么会被过滤。
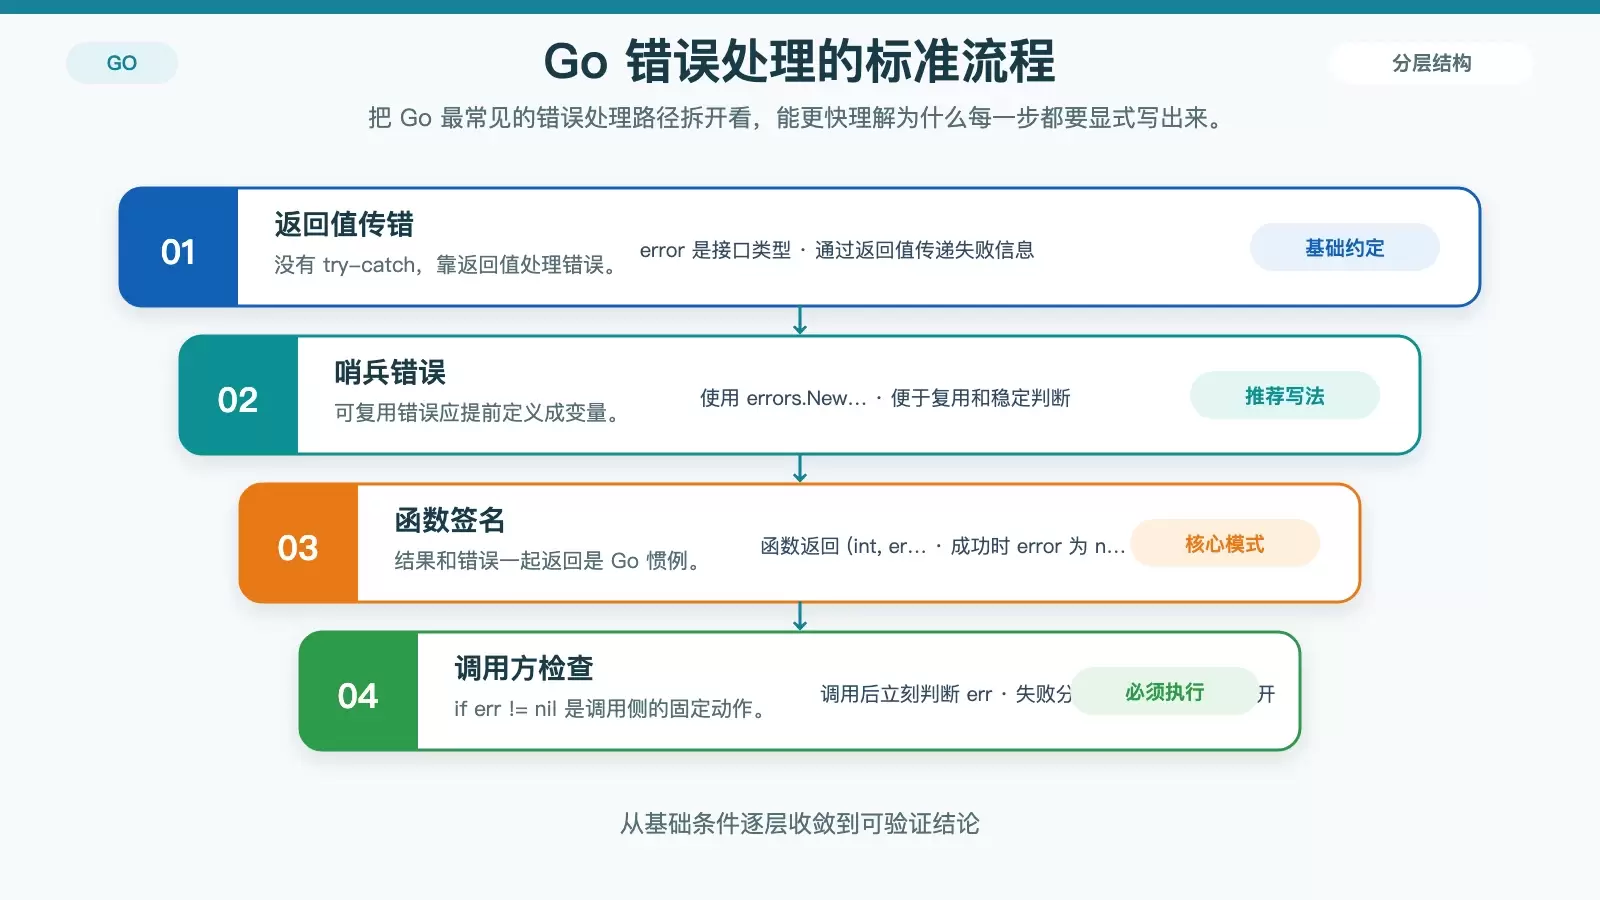
Go 在 Debian 下的错误处理方式与其他平台一致,核心都是“函数返回 error、调用方立即检查”。这篇文章按实际编码顺序梳理哨兵错误、返回值约定、errors.Is/errors.As 与 fmt.Errorf 的用法,帮助你判断不同场景该写哪一种。
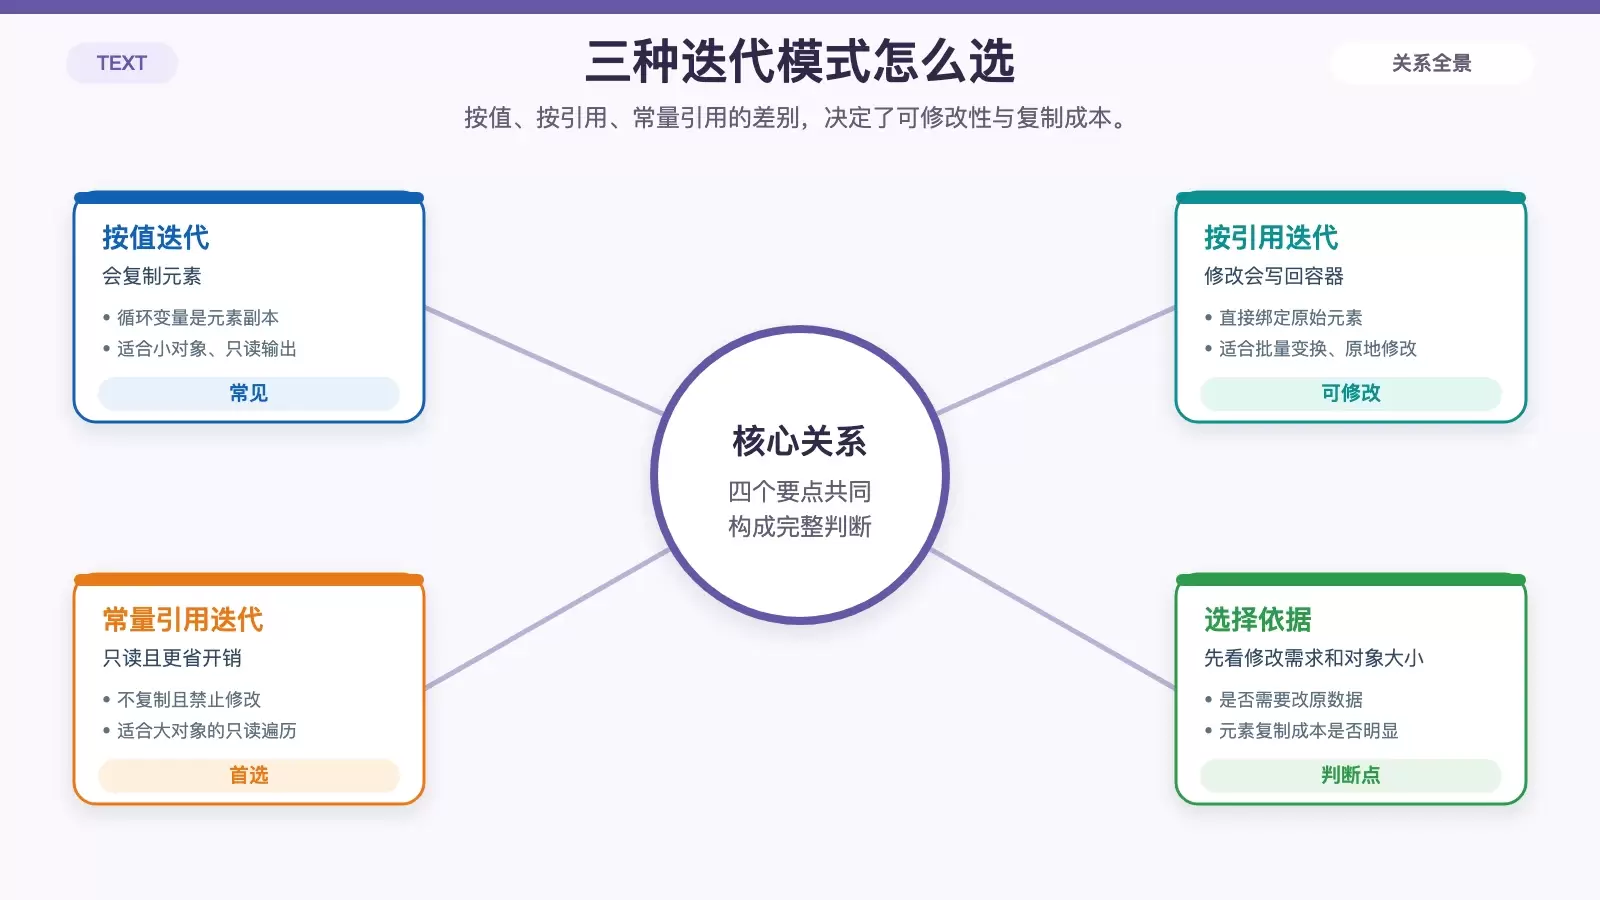
本文围绕 C++11 引入的基于范围的 for 循环展开,梳理它的基本语法、按值与按引用的差异、适用容器范围,以及实际开发中常见的过滤、转换和嵌套遍历写法。文中也会重点说明性能取舍与几个容易踩坑的细节,帮助你判断什么时候该用、什么时候该回到传统迭代方式。
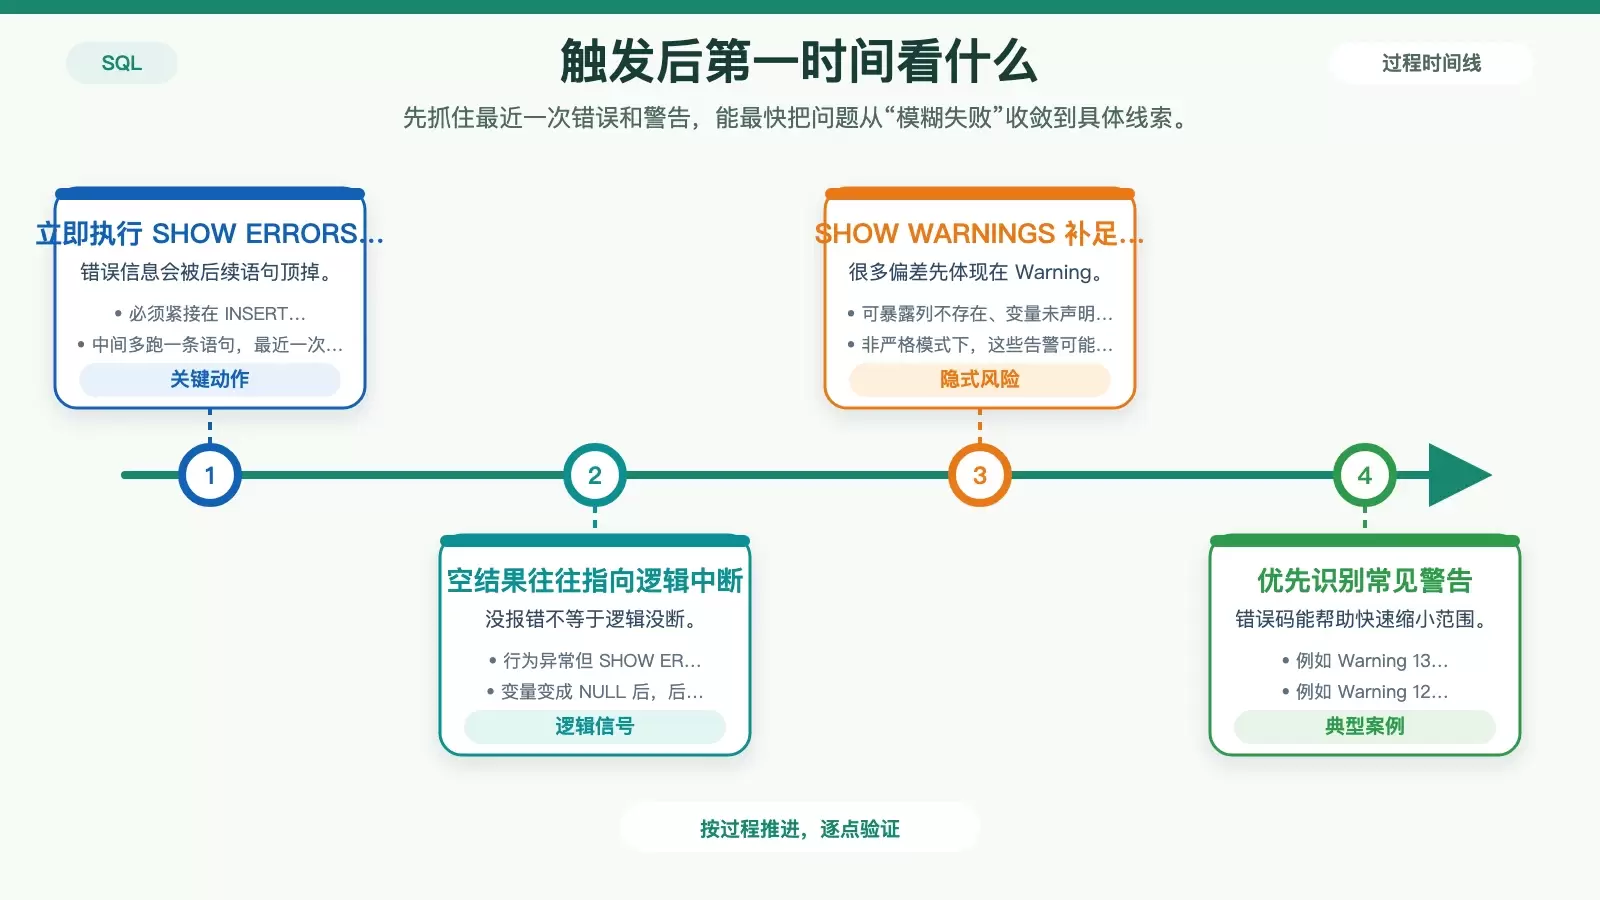
SQL 触发器排错最难的不是语法报错,而是那些客户端只给出模糊提示、甚至完全不报错的“静默失败”。这篇文章把高效排查路径拆成四步:先抓最近一次错误与警告,再确认触发器是否真的触发,随后回看错误日志,最后用手动模拟把逻辑断点揪出来。
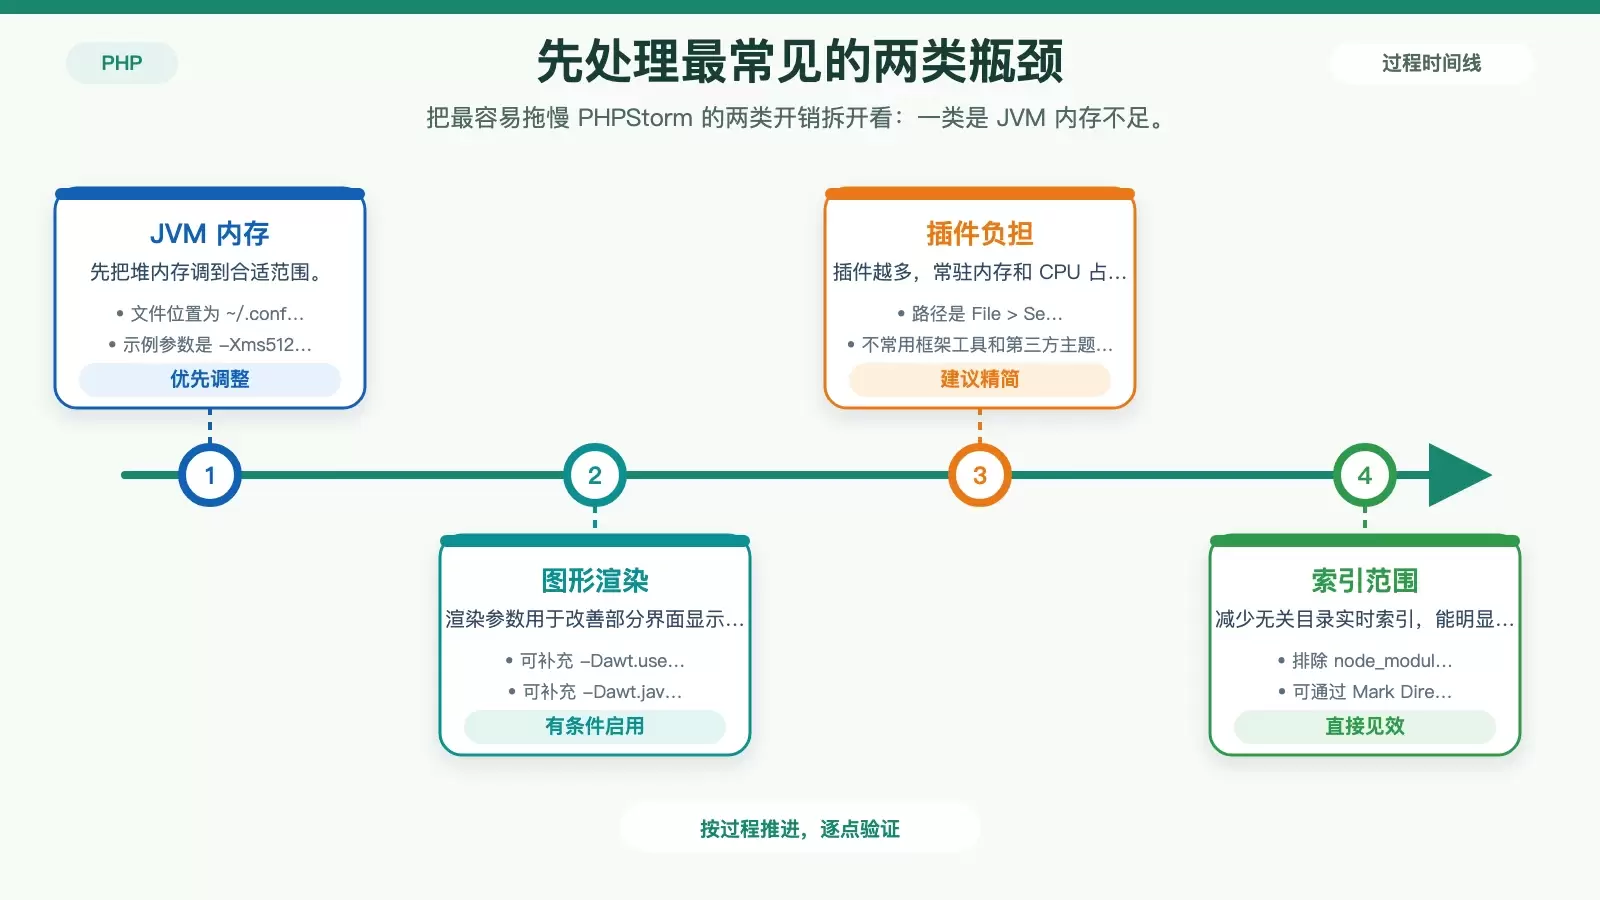
在 Linux 上优化 PHPStorm,优先看内存、索引和插件三类高频瓶颈。本文按“先调 IDE、再查系统、最后看硬件”的顺序整理可直接执行的设置项,并保留关键路径、命令和参数,方便你快速判断该从哪里下手。
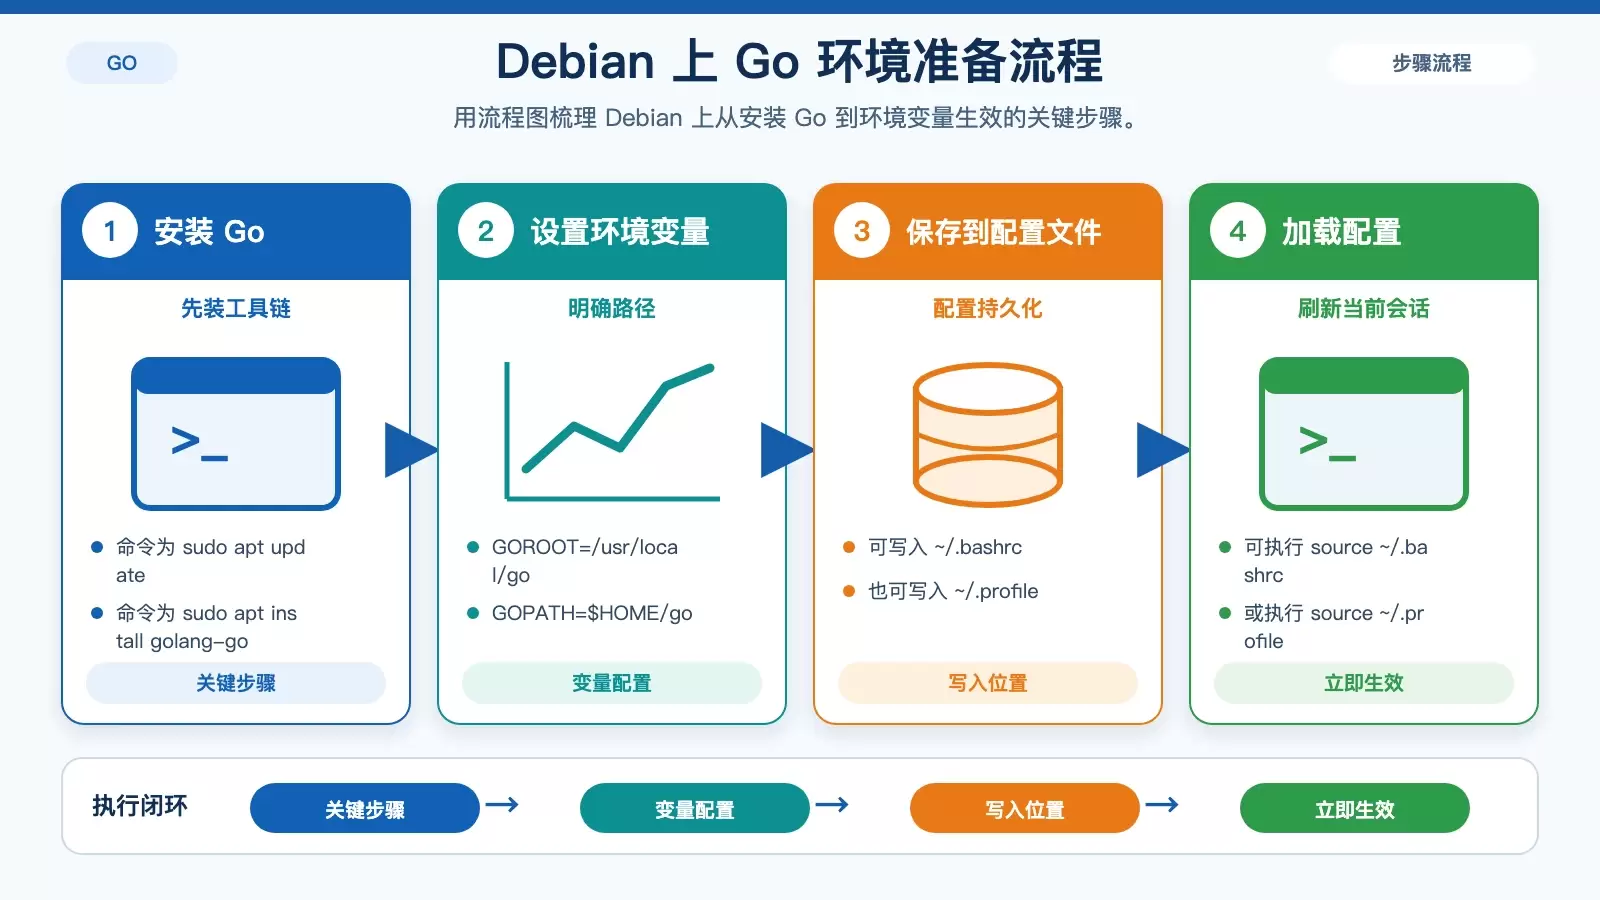
本文用 Debian 环境为例,梳理 Go 连接数据库的基本流程:安装 Go、配置环境变量、按数据库类型安装驱动、编写 `database/sql` 示例并运行验证。文中保留了 MySQL、PostgreSQL、SQLite 的驱动命令和一段可直接参考的查询代码,适合快速搭建本地实验环境。
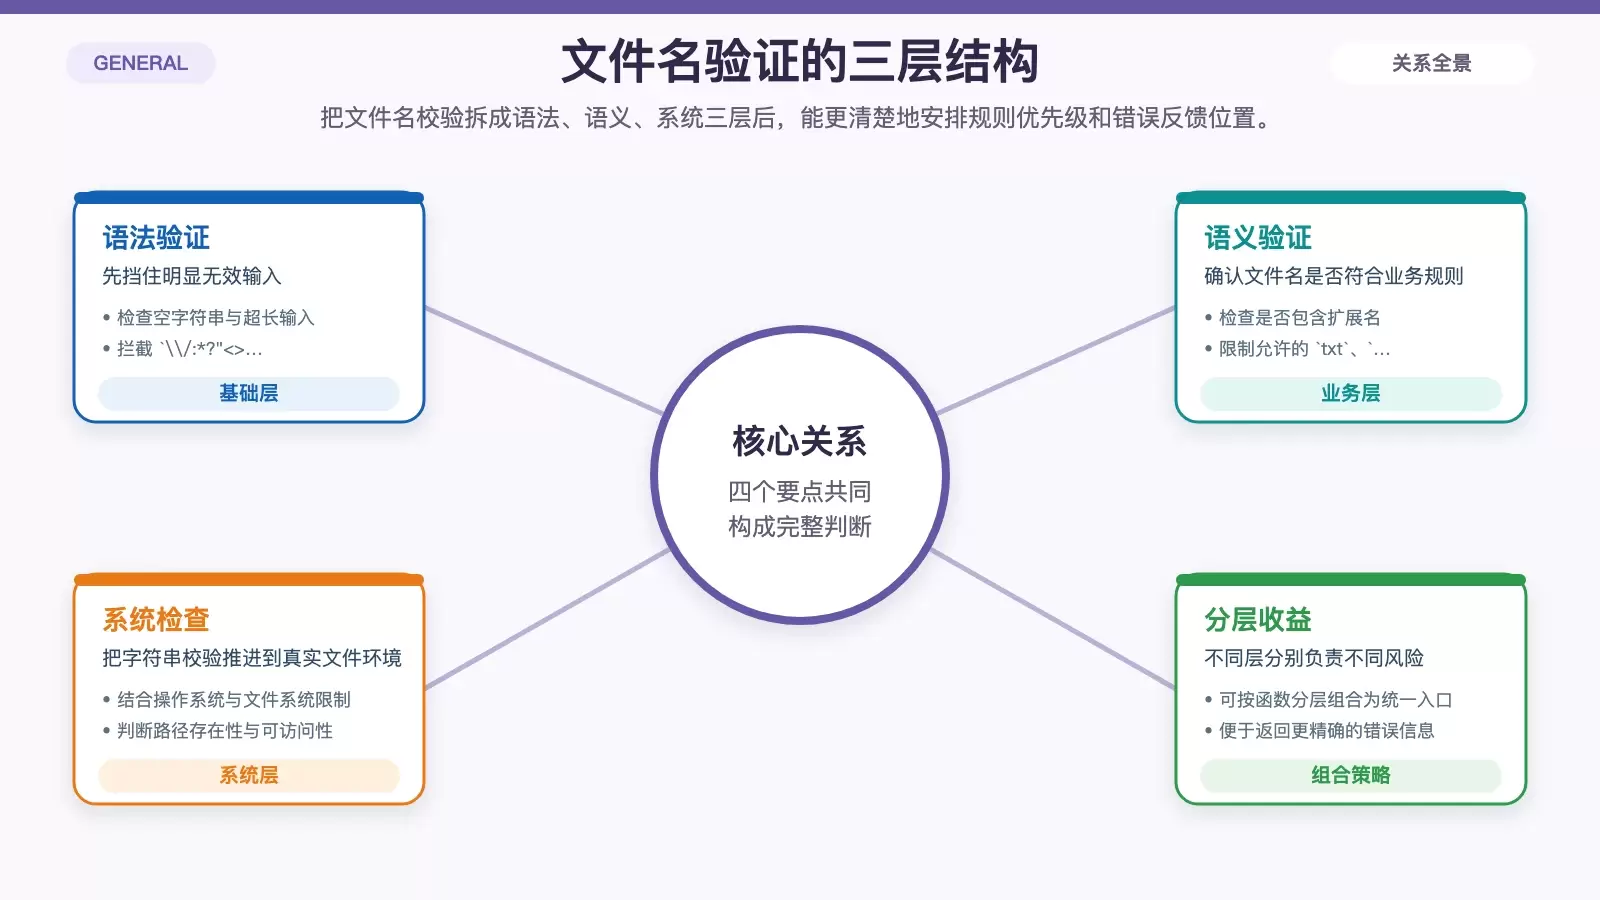
这篇文章围绕 C++ 中文件名校验展开,按“基础规则、验证分层、落地实现”重新梳理思路。重点保留长度限制、非法字符、扩展名检查、`std::filesystem` 与权限判断等关键代码与编译信息,便于直接用于实际项目。