


在 C++ 代码里,遍历容器几乎是每天都会写到的操作。基于范围的 for 循环自 C++11 引入后,把很多原本依赖迭代器和边界条件的样板代码压缩成了更直观的写法,但它并不只是“语法更短”这么简单:按值、按引用、常量引用,以及面对映射、嵌套容器和大对象时的表现都不一样。下面按“怎么写、适合什么场景、有哪些坑、性能上怎么选”几个问题展开,方便你在实际代码里直接对照使用。
什么是基于范围的 for 循环
基于范围的 for 循环用于顺序访问容器、数组或其他可迭代对象中的每个元素。和传统 for、while 相比,它不需要手动维护下标、迭代器或结束条件,代码更短,也更不容易把边界写错。
这一特性从 C++11 开始提供,适合处理标准容器、数组、初始化列表,以及实现了 begin / end 的自定义类型。
基本语法
for (element_type element : container) {
    // 循环体
}
其中:
element_type:元素类型element:当前迭代到的循环变量container:要遍历的容器或数组
一个最基础的例子如下:
#include <iostream>
#include <vector>

int main() {
    std::vector<int> numbers = {1, 2, 3, 4, 5};

    // 遍历向量
    for (int num : numbers) {
        std::cout << num << " ";
    }

    return 0;
}
如果你的需求只是“把每个元素读一遍”,这通常就是最直接的写法。
按值、按引用、常量引用怎么选
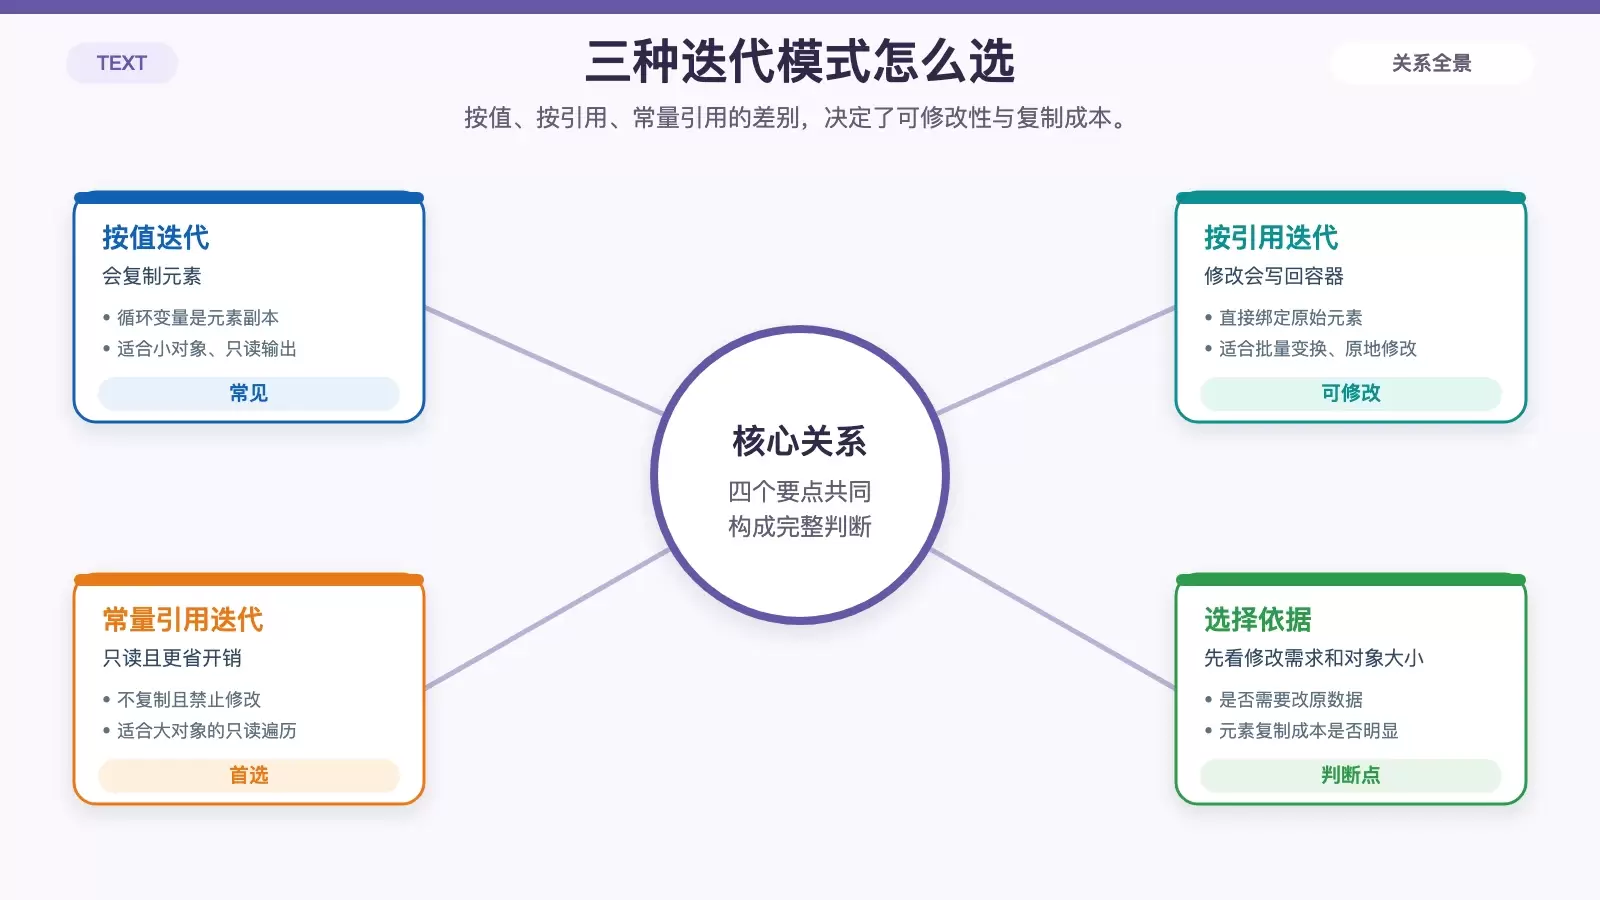
基于范围的 for 循环最容易被忽略的部分,不是语法本身,而是循环变量的声明方式。它直接决定你读到的是副本还是原对象,也影响是否能修改元素,以及是否会产生额外复制成本。
按值迭代:适合只读的小对象
按值写法会为每个元素创建一个副本:
for (int num : numbers) {
    std::cout << num << " ";
}
这种方式适合元素较小、只做读取、不需要改动原始数据的场景。缺点也很明确:如果元素本身很大,复制成本会被放大。
按引用迭代:需要原地修改时使用
如果希望直接改动容器里的元素,就要使用引用:
for (int& num : numbers) {
    num *= 2;
}
这里的 num 绑定的是原始元素本身,所以修改会直接反映到容器中。这是做批量变换时最常见的写法。
常量引用迭代:大多数只读场景的首选
如果不需要修改元素,但又想避免复制,常量引用通常是更稳妥的选择:
for (const int& num : numbers) {
    std::cout << num << " ";
}
尤其是元素类型较大时,const T& 往往比按值更合适。它既避免了副本开销,也能明确表达“这里只读”。
三种模式的对照示例
#include <iostream>
#include <vector>

int main() {
    std::vector<int> numbers = {1, 2, 3, 4, 5};

    // 按值迭代
    for (int num : numbers) {
        std::cout << num << " ";
    }

    std::cout << std::endl;

    // 按引用迭代
    for (int& num : numbers) {
        num *= 2;
    }

    // 常量引用迭代
    for (const int& num : numbers) {
        std::cout << num << " ";
    }

    return 0;
}
哪些类型可以直接用于范围 for
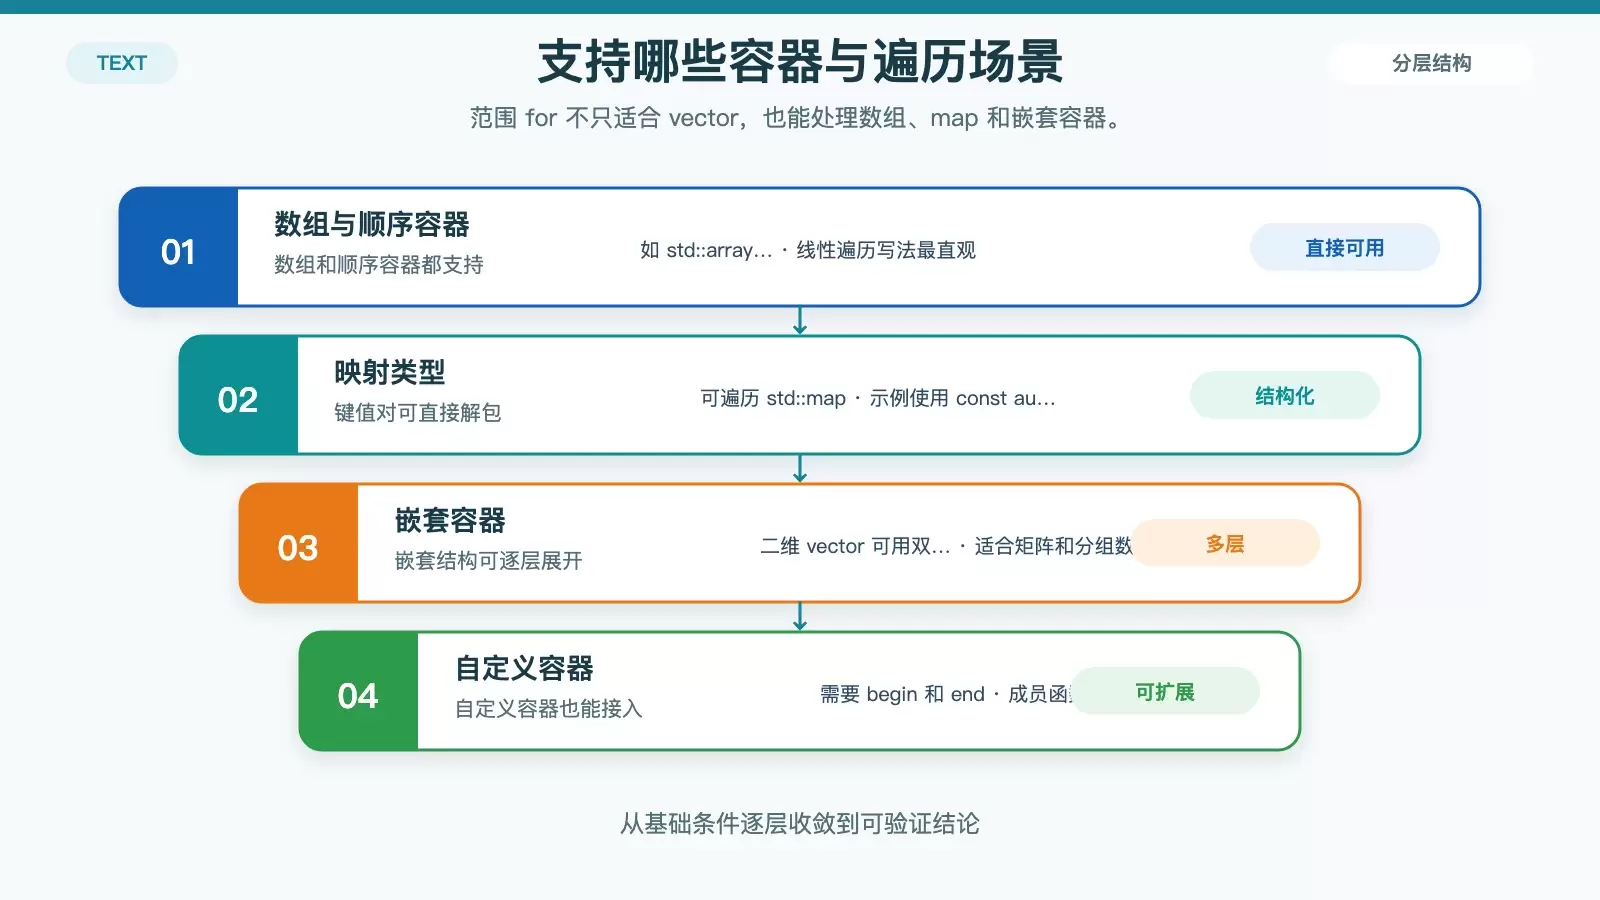
很多人第一次接触时只会拿它遍历 std::vector,但它的适用范围比这大得多。
标准容器、数组和初始化列表都支持
常见的标准库类型,比如向量、数组、映射,都可以直接用于基于范围的 for 循环。此外,普通数组和初始化列表同样适用。
graph TD
    A[基于范围的for循环] --> B[标准容器]
    A --> C[数组]
    A --> D[初始化列表]
    A --> E[具有begin/end方法的自定义容器]
自定义容器的要求
如果是自定义容器,只要它实现了成员形式的 begin 和 end,或者能提供全局的 begin / end,通常也可以被范围 for 直接遍历。
换句话说,关键不在于“是不是标准容器”,而在于“有没有提供合法的遍历边界”。
实际开发中常见的几种写法
语法理解清楚之后,更重要的是知道它在业务代码里通常怎么落地。下面几类场景最常见。
遍历不同类型的容器
基于范围的 for 循环不只适合线性容器,也可以自然地处理映射类型。
#include <iostream>
#include <array>
#include <map>

int main() {
    // 数组迭代
    std::array<std::string, 3> fruits = {"apple", "banana", "cherry"};
    for (const std::string& fruit : fruits) {
        std::cout << fruit << " ";
    }

    std::cout << std::endl;

    // 映射迭代
    std::map<std::string, int> ages = {
        {"Alice", 30},
        {"Bob", 25}
    };
    for (const auto& [name, age] : ages) {
        std::cout << name << " 是 " << age << " 岁\n";
    }

    return 0;
}
这里映射部分使用了结构化绑定 [name, age],能让代码更接近“按键值对解包”的阅读方式。
数据过滤与转换
在循环体里加入条件判断或原地修改逻辑,就能完成很多轻量的数据处理任务。
元素过滤
#include <iostream>
#include <vector>

int main() {
    std::vector<int> numbers = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};

    // 过滤偶数
    for (int num : numbers) {
        if (num % 2 == 0) {
            std::cout << num << " ";
        }
    }

    return 0;
}
元素转换
#include <iostream>
#include <vector>

int main() {
    std::vector<int> numbers = {1, 2, 3, 4, 5};

    // 对每个数字求平方
    for (int& num : numbers) {
        num = num * num;
    }

    // 打印转换后的数字
    for (int num : numbers) {
        std::cout << num << " ";
    }

    return 0;
}
过滤时通常按值或常量引用即可;转换时则更适合按引用遍历。
嵌套容器遍历
面对二维数组、二维向量这类嵌套结构时,可以直接叠加多层范围 for:
#include <iostream>
#include <vector>

int main() {
    std::vector<std::vector<int>> matrix = {
        {1, 2, 3},
        {4, 5, 6},
        {7, 8, 9}
    };

    // 遍历二维向量
    for (const auto& row : matrix) {
        for (int num : row) {
            std::cout << num << " ";
        }
        std::cout << std::endl;
    }

    return 0;
}
这种写法在处理矩阵、分组数据、树形节点的子集合时都很常见。
需要索引时怎么办
范围 for 最大的局限之一,是它默认不暴露索引。如果你的逻辑必须依赖位置,就需要重新评估写法。
原文给出的方式是回到迭代器形式,并用 std::distance 计算索引:
#include <iostream>
#include <vector>

int main() {
    std::vector<std::string> fruits = {"apple", "banana", "cherry"};

    // 带索引迭代
    for (auto it = fruits.begin(); it != fruits.end(); ++it) {
        std::cout << "索引 " << std::distance(fruits.begin(), it) << ": " << *it << std::endl;
    }

    return 0;
}
这也说明一个很实际的原则:范围 for 适合“只关心元素”的场景,一旦你强依赖索引、步长或复杂迭代控制,传统写法往往更清晰。
容易踩坑的地方与使用建议
不要在遍历时修改容器结构
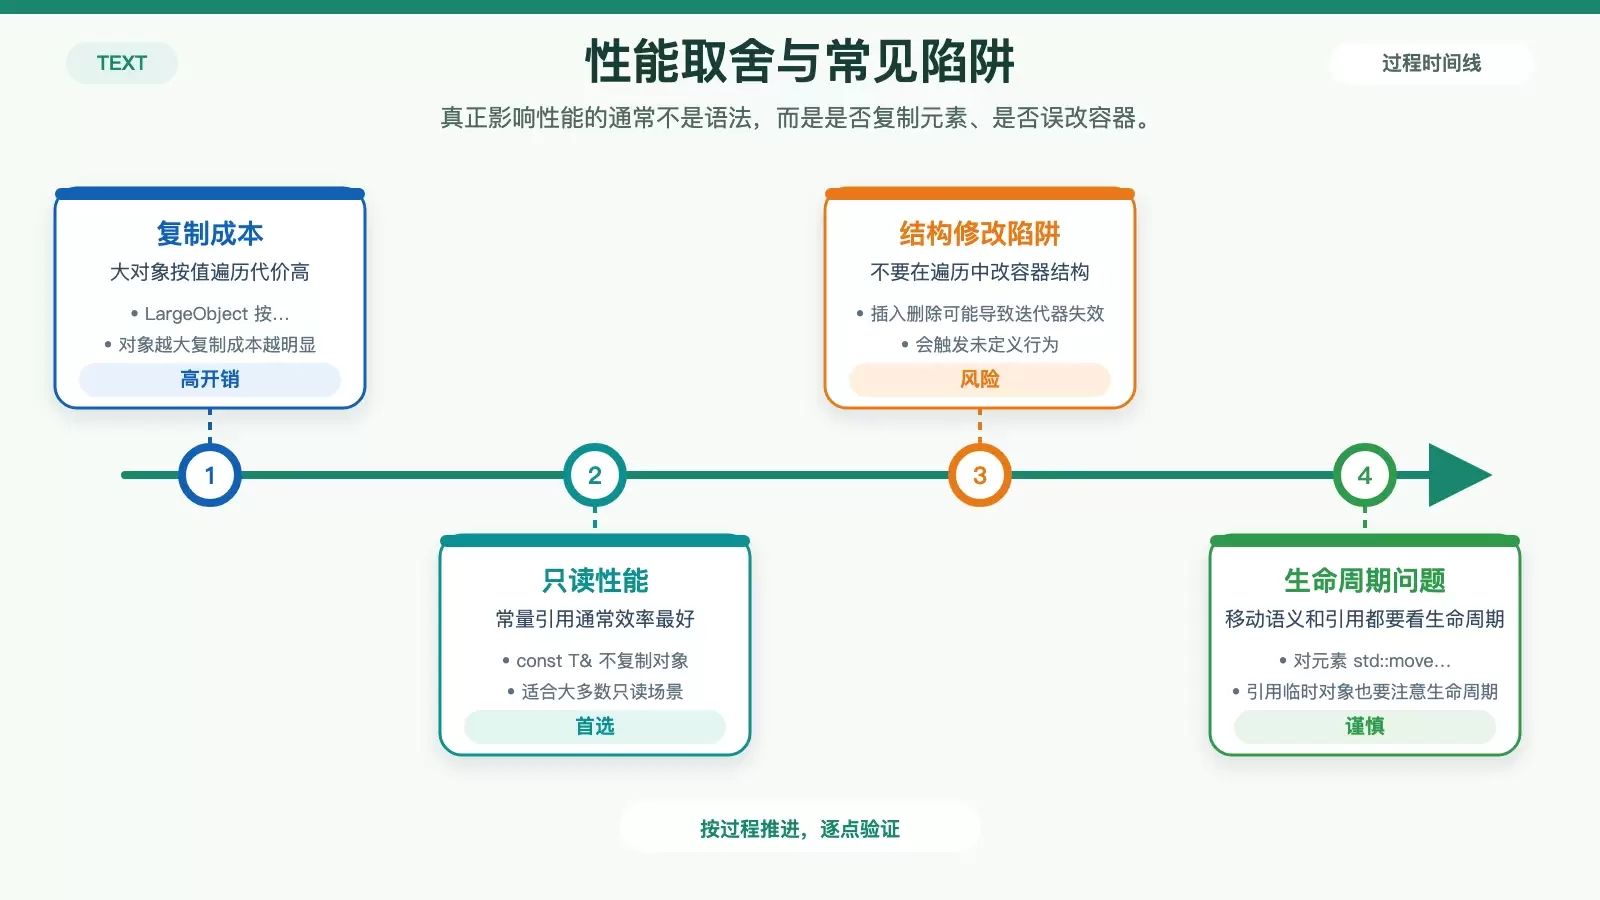
如果在循环过程中修改了容器大小或结构,可能导致迭代器失效,进而触发未定义行为。像插入、删除、扩容这类操作,要格外小心。
谨慎引用临时对象
如果范围表达式返回的是临时对象,而循环变量又以引用形式接收,那么这个引用的有效性要特别注意。循环结束后,相关引用就不再可用。
根据对象大小选择迭代模式
对于大型对象,按值迭代通常意味着可见的复制成本;按引用或常量引用更适合实际项目中的性能要求。
- 只读且对象较大:优先
const T& - 需要修改元素:使用
T& - 对象很小且无需修改:按值可接受
性能影响:为什么循环变量写法很关键
基于范围的 for 循环本身并不是“慢”或者“快”,真正影响性能的,通常是元素是否被复制,以及对象本身的大小。
大对象场景下的差异
#include <iostream>
#include <vector>
#include <chrono>

class LargeObject {
public:
    std::vector<int> data;
    // 大型构造函数和方法
};

void iterateByValue(std::vector<LargeObject>& objects) {
    for (LargeObject obj : objects) {  // 代价高昂:创建完整副本
        // 处理对象
    }
}

void iterateByReference(std::vector<LargeObject>& objects) {
    for (const LargeObject& obj : objects) {  // 高效:不进行复制
        // 处理对象
    }
}
这个例子足够说明问题:当元素内部本身还持有较大资源时,按值复制的成本会迅速放大。
三种迭代方式的取舍
| 迭代类型 | 内存使用 | 性能 | 推荐情况 |
|---|---|---|---|
| 按值 | 高 | 慢 | 不推荐 |
| 按引用 | 中等 | 良好 | 推荐 |
| 常量引用 | 低 | 最佳 | 首选 |
移动语义与编译器优化
原文还提到了两个和效率相关的补充点:移动语义与编译器优化。
移动语义是 C++11 引入的能力,可以在部分场景下降低资源转移成本:
#include <iostream>
#include <vector>
#include <utility>

int main() {
    std::vector<std::string> words = {"hello", "world"};

    // 高效的移动迭代
    for (auto&& word : words) {
        std::cout << std::move(word) << " ";
    }

    return 0;
}
不过这类写法要谨慎使用,因为一旦对元素执行 std::move,原对象后续状态就需要由你自己负责理解和管理。
此外,现代编译器通常还会对这类循环进行优化,例如内联、死代码消除、循环展开和常量折叠。但这些优化并不能替代正确的迭代方式选择,尤其无法消除你显式写出的对象复制。
什么时候优先用范围 for,什么时候不用
如果你的目标是顺序访问每个元素,而且不依赖索引、复杂步进、前后对比或中途改写容器结构,那么基于范围的 for 循环通常就是更现代、更易读的选择。
相反,下面这些情况可以考虑回到传统写法:
- 需要索引位置
- 需要精确控制迭代器移动
- 遍历过程中会改变容器结构
- 逻辑依赖前后元素关系
总结来看,范围 for 的价值不只是“少写几行代码”,而是把注意力从边界控制转回到“当前元素该怎么处理”这件事上。只要把按值、按引用和常量引用的区别想清楚,它会是日常 C++ 开发里非常稳定的一种遍历工具。









