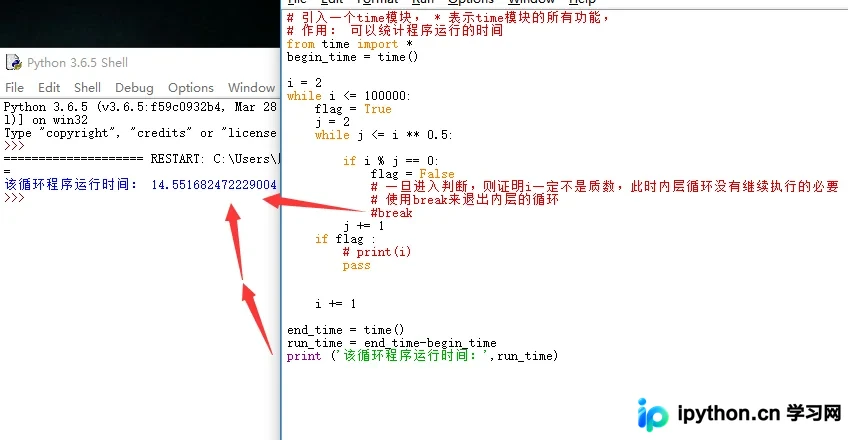
解决Python中pandas读取*.csv文件出现编码问题
在使用Python的pandas库读取CSV文件时,常因文件编码格式(如GBK)与默认UTF-8不匹配而抛出UnicodeDecodeError。本文介绍如何通过指定encoding参数(如gbk)直接解决,以及利用文本编辑器转换文件编码的备用方案,确保数据顺利加载。
2026-10-11
24

在使用Python的pandas库读取CSV文件时,常因文件编码格式(如GBK)与默认UTF-8不匹配而抛出UnicodeDecodeError。本文介绍如何通过指定encoding参数(如gbk)直接解决,以及利用文本编辑器转换文件编码的备用方案,确保数据顺利加载。
本文解析 Django 中 View 如何调用数据库,阐述 Model 类与数据库表的映射关系,包括变量对应属性及 ForeignKey 关联约束。同时介绍 django-sekizai 库在模板管理中的应用,通过定义 placeholders 和 blocks 实现 CSS 与 JavaScript 的精准定位,自动处理重复内容并优化资源加载位置。
本文将演示如何使用Python生态库快速搭建情感分析流水线。通过NLTK清理基础语料,调用TextBlob与VADER算法量化文本极性,最后借助Matplotlib绘制得分对比柱状图与类别分布饼图,实现从原始文本到直观情感图谱的完整转化,助力业务系统低成本接入情绪识别功能。
本文详解NumPy中数组分割与搜索的核心函数。通过np.array_split按指定位置或轴拆分数组,利用np.where快速返回满足条件的元素索引,并结合np.searchsorted在已排序序列中执行二分查找。内容包含准确参数说明、可运行代码示例及常见误区提示,助您高效处理结构化数据。
本文介绍Python函数中接收任意数量参数的方法。通过在前缀添加星号(*),函数可将多个实参打包为元组。示例展示了如何定义此类函数并处理不同数量的输入参数,适用于需要灵活处理参数列表的场景。
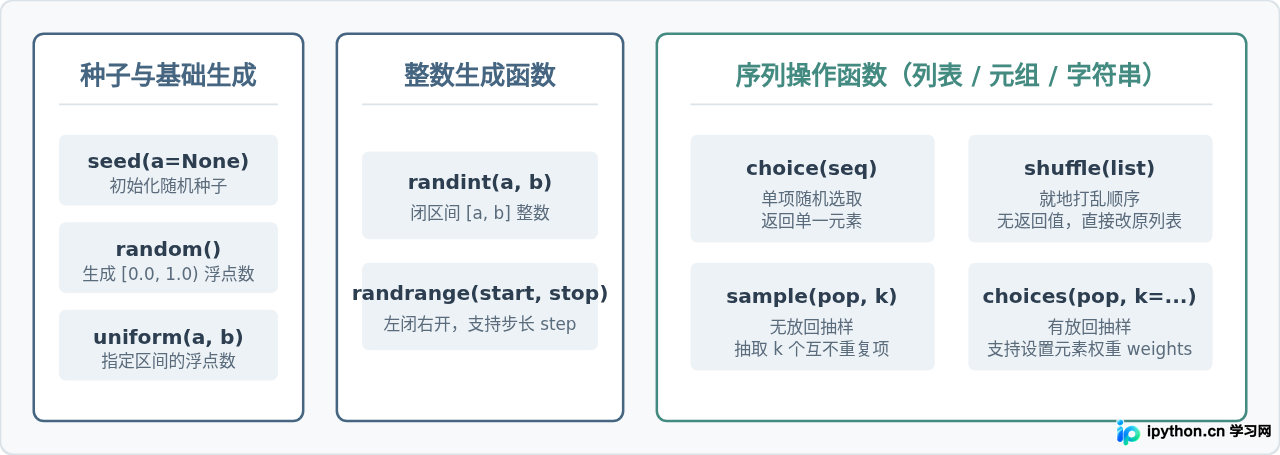
详细讲解Python内置random模块的核心机制与常用函数,涵盖整数、浮点数、序列操作、随机种子控制及安全注意事项,配备完整代码示例与架构图解。
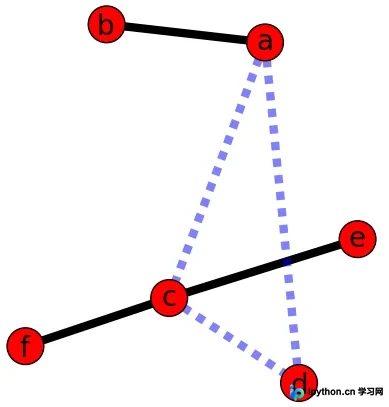
本文介绍如何使用 Python 的 NetworkX 库绘制基于权重的加权图。通过遍历图的边并提取权重属性,将边划分为高权重(实线)和低权重(虚线)两组。利用 matplotlib 的 draw_networkx_edges 函数,分别设置线条宽度、透明度和样式,直观展示不同权重的连接关系。
数据预处理是提升机器学习模型性能的关键环节。本文详细介绍基于Python与scikit-learn的核心预处理步骤,涵盖缺失值智能填充、异常值统计检测、分类变量独热与顺序编码,以及数值特征的标准化与归一化转换。结合可直接运行的代码示例,提供从原始数据到模型就绪数据的完整操作指引。
在深度学习数据增强中,直接旋转图像常导致边缘被裁剪。本文介绍一种基于 OpenCV 的旋转算法,通过动态计算旋转后的新边界尺寸并调整仿射矩阵,实现图像旋转后保持完整内容不被裁剪。
在Python中终止线程通常依赖协作式标志位或底层异步异常机制。本文演示如何通过threading.Event定期检查实现优雅停止,以及利用ctypes触发异常强制中断循环的底层写法。附线程安全规范与阻塞场景应对方案,帮助开发者安全控制并发任务生命周期。
本文介绍Python代码优化的两个实用技巧:利用条件表达式的顺序简化成绩区间判断,以及使用break语句退出不必要的循环以优化运行时间。通过具体代码示例,展示如何简化逻辑并提升程序效率。