

Python正则表达式匹配中文的完整指南

发布时间:2026-10-11| 2人浏览过
在Python文本处理中,利用正则表达式精准匹配中文字符是常见需求。核心在于理解Unicode编码范围,并正确使用 `re` 模块中的匹配函数。本文将通过具体代码示例,解析如何匹配单个字符、连续片段及全量内容,并说明相关字符集范围。
核心原理:Unicode编码范围
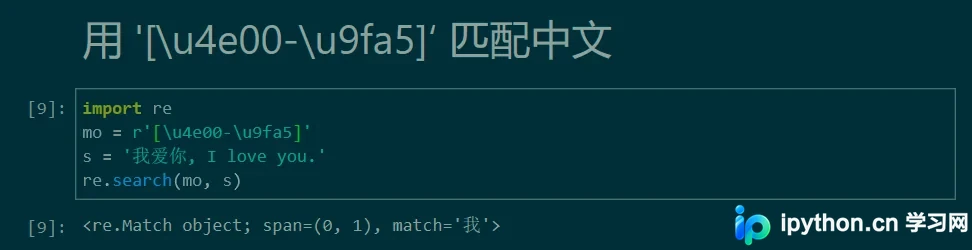
在正则表达式中匹配中文,本质是匹配特定的 Unicode 编码区间。最常用且广泛支持的范围是 \u4e00-\u9fa5,该区间涵盖了绝大多数常用汉字。确保正则表达式字符串与待匹配的文本均使用 Unicode 编码(Python 3 默认支持),是匹配成功的前提。
代码实现与操作
Python 的 re 模块提供了强大的正则处理功能。根据需求不同,可使用 search 或 findall 函数。
1. 匹配第一个中文字符
若只需定位字符串中出现的第一个汉字,使用 re.search 配合基础模式即可:
import re

text = "Hello World 你好"
pattern = r'[\u4e00-\u9fa5]'
match = re.search(pattern, text)

if match:
    print(match.group())  # 输出: 你
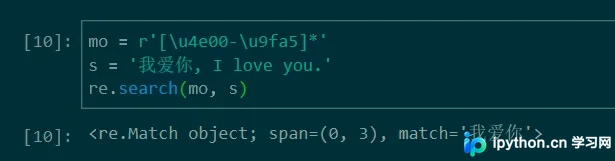
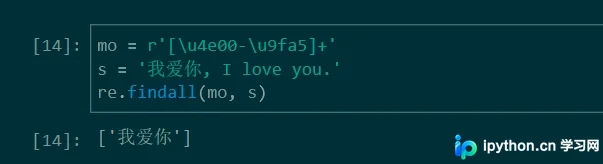
2. 匹配第一个连续中文片段
当需要提取连续的中文词语(如“你好世界”)而非单个字符时,需使用量词 +:
import re

text = "Hello World 你好世界"
pattern = r'[\u4e00-\u9fa5]+'
match = re.search(pattern, text)

if match:
    print(match.group())  # 输出: 你好世界
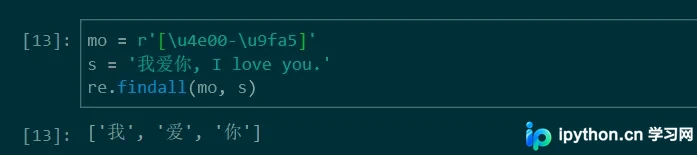
3. 匹配所有中文字符
若需提取文本中所有的汉字,无论是否连续,使用 re.findall 是最直接的方法:
import re

text = "Python正则表达式匹配中文 123 测试"
pattern = r'[\u4e00-\u9fa5]'
result = re.findall(pattern, text)

print(result)  # 输出: ['正', '则', '表', '达', '式', '匹', '配', '中', '文', '测', '试']
补充:主要非英文语系字符范围
在处理多语言文本时,了解相关 Unicode 区块有助于更精确地定义匹配规则。以下是几个主要的非英文语系字符范围:
几个主要非英文语系字符范围:
2E80~33FFh:中日韩符号区。收容康熙字典部首、中日韩辅助部首、注音符号、日本假名、韩文音符,中日韩的符号、标点、带圈或带括符文数字、月份,以及日本的假名组合、单位、年号、月份、日期、时间等。
3400~4DFFh:中日韩认同表意文字扩充A区,总计收容6,582个中日韩汉字。
4E00~9FFFh:中日韩认同表意文字区,总计收容20,902个中日韩汉字。
A000~A4FFh:彝族文字区,收容中国南方彝族文字和字根。
AC00~D7FFh:韩文拼音组合字区,收容以韩文音符拼成的文字。
F900~FAFFh:中日韩兼容表意文字区,总计收容302个中日韩汉字。
FB00~FFFDh:文字表现形式区,收容组合拉丁文字、希伯来文、阿拉伯文、中日韩直式标点、小符号、半角符号、全角符号等。
总结
掌握 \u4e00-\u9fa5 编码范围及 re 模块的用法,即可灵活应对 Python 中的中文匹配需求。注意区分“单个字符”与“连续片段”的量词使用,是避免匹配结果不符合预期的关键。
以上就是Python正则表达式如何匹配中文的详细内容,更多关于Python正则表达式匹配中文的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









