

Python利用正则表达式提取新闻标题与链接
本文介绍使用Python正则表达式从网页中提取新闻标题及链接的具体实现方法。通过urllib获取页面内容,利用正则匹配特定HTML结构,并对提取结果进行字符串替换处理,最终将标题和链接保存至本地文件。
2026-10-13
25

本文介绍使用Python正则表达式从网页中提取新闻标题及链接的具体实现方法。通过urllib获取页面内容,利用正则匹配特定HTML结构,并对提取结果进行字符串替换处理,最终将标题和链接保存至本地文件。
本文深入解析Python中with关键字的工作原理,阐述其作为try/finally替代方案在资源管理中的优势。通过对比普通、进阶及高级写法,详解__enter__和__exit__方法的实现机制,并介绍利用contextmanager装饰器简化上下文管理器构建的技巧,帮助开发者写出更优雅、安全的代码。
本文系统解析C语言中的核心操作符。深入探讨算术运算中整数除法的向零取整特性与精度丢失问题,阐明取余运算对整型的限制及符号规律。详细讲解移位操作符的二进制处理机制及左右移与乘除的关系,剖析按位与或异或的底层逻辑应用。重点解析逻辑运算符的短路求值机制及其在条件判断中的实际影响,最后涵盖单目、赋值等常用操作符的注意事项。
本文详细介绍Python中datetime模块的五大核心类:date、datetime、time、timedelta及tzinfo。涵盖日期对象的创建、常用方法如ctime、fromtimestamp、strftime等,以及时间格式化符号的详细列表。同时讲解如何利用timedelta类计算两个日期之间的天数差与秒数,并提供实际代码示例,帮助开发者高效处理时间相关操作。
本文详细解析Python中元组(Tuple)与字典(Dict)的核心特性。重点阐述元组元素指向内存地址不变的“不可变”本质,以及字典作为映射类型对键不可变性的要求。文章涵盖字典的多种创建方式、生成式用法及get、pop、update等常用内置方法,帮助开发者掌握高效的数据处理技巧。
本文介绍如何使用Python的python-docx库,自动遍历指定目录下的特定后缀代码文件(如.cs),并将读取到的代码内容整理保存为Word文档。脚本支持处理中文编码,通过打印日志监控文件处理状态,确保生成包含标题、代码块及总行数的完整文档,适用于快速整理项目代码以申请专利或归档。
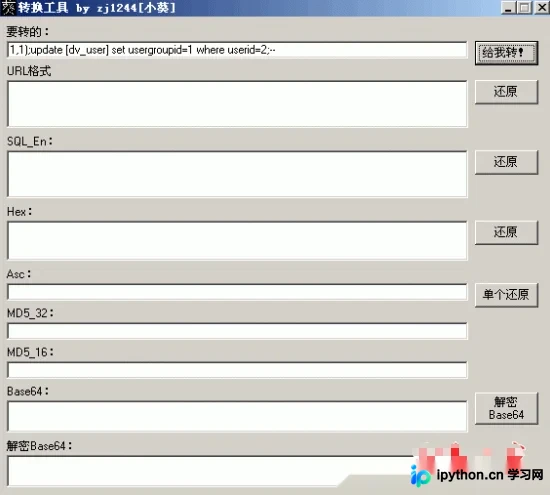
本文详细介绍如何利用 Python 进行常见的编码转换操作,涵盖 URL 编码、Base64、Hex 十六进制、ASCII 码及 Md5 哈希计算。通过具体代码示例,展示在 Web 安全和渗透测试场景中如何绕过过滤函数或处理乱码问题,帮助开发者高效解决日常编码处理需求。
本文详细介绍如何使用Python通过pymssql模块连接SQLServer2000数据库。内容涵盖模块安装、连接建立、游标创建、SQL命令执行及结果提取等标准流程。重点解决了开发中常见的GBK转UTF-8时出现的UnicodeDecodeError乱码问题,提供ignore和replace等错误处理策略,帮助开发者高效完成数据库交互。
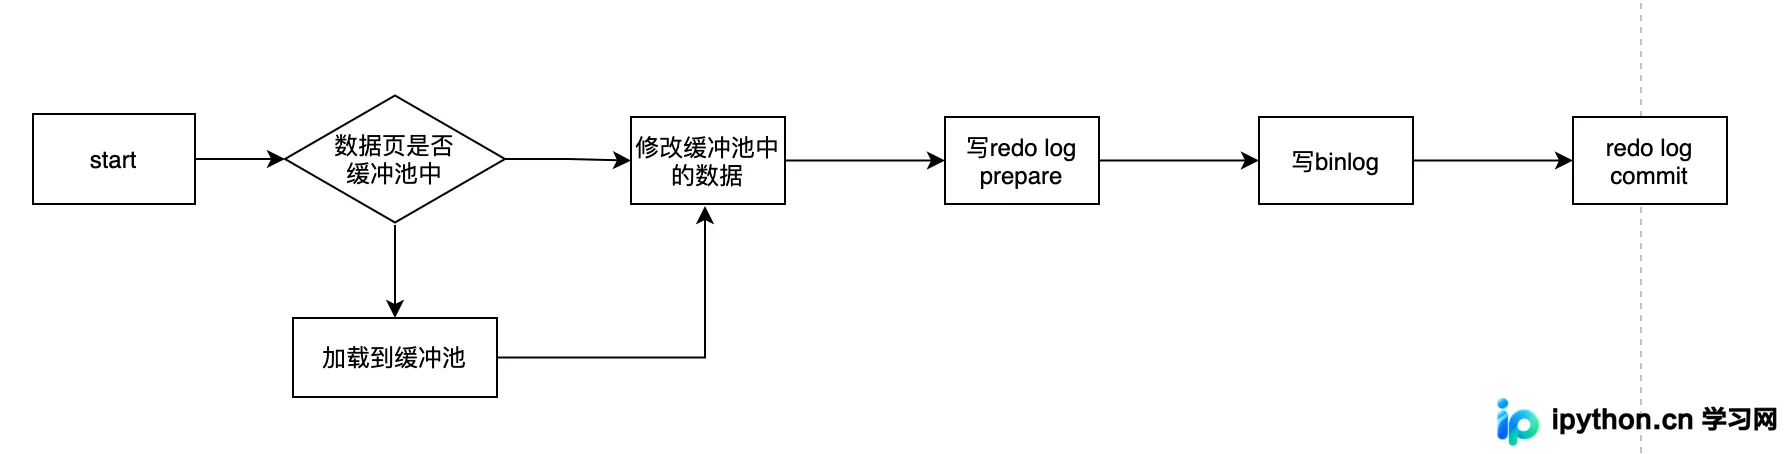
本文深入解析MySQL InnoDB引擎的事务持久性与原子性保障机制。通过WAL技术的引入,详细阐述了redo log如何确保数据不丢失,包括其Buffer存储、刷盘策略及两阶段提交逻辑;同时说明undo log如何实现MVCC多版本控制与事务回滚。文章涵盖关键参数配置、日志结构及故障恢复流程,帮助开发者理解底层数据一致性原理。
本文介绍使用Python正则表达式抓取网易新闻评论的方法。通过抓包工具定位隐藏评论接口,利用urllib2发起请求并获取HTML数据,再经正则处理提取JSON中的评论字段。代码包含分页处理、异常捕获及文件写入逻辑,适合Python初学者参考正则在爬虫中的应用。
本文详细介绍使用Python将罗马数字转换为阿拉伯数字的实现方法。文章解析了罗马数字的基本符号(I, V, X等)及其组合规则,重点讲解了利用正则表达式验证输入合法性及通过字典映射进行数值累加的算法逻辑。提供了完整的Python函数代码,可直接用于处理如MDCCCLXXXVIII等标准罗马数字字符串的转换任务。
本文介绍利用Python正则表达式从指定网页提取并保存图片的方法。通过定义匹配规则筛选图片链接,结合urllib库实现批量下载。文中附带Python代码示例及正则表达式在线测试工具链接,帮助开发者快速掌握网页图片抓取技巧。