

Python抓取亚马逊书籍信息并存储至MySQL的实现方案
本文介绍使用Python抓取亚马逊书籍基本信息的完整流程。通过构造包含node参数的GET请求获取搜索结果页,利用正则表达式解析书名、作者、封面等字段,并将结果写入MySQL数据库。代码展示了从请求构造到数据入库的核心逻辑,适用于需要批量采集书籍元数据的场景。
2026-10-13
23

本文介绍使用Python抓取亚马逊书籍基本信息的完整流程。通过构造包含node参数的GET请求获取搜索结果页,利用正则表达式解析书名、作者、封面等字段,并将结果写入MySQL数据库。代码展示了从请求构造到数据入库的核心逻辑,适用于需要批量采集书籍元数据的场景。
本文介绍如何使用 System.CommandLine.DragonFruit 库,在 C# 中通过修改 Main 方法参数即可自动生成完整的命令行解析功能。无需编写额外代码或配置文件,自动处理参数解析、帮助文档及 XML 注释,极大简化 .NET 控制台程序的 CLI 开发流程。
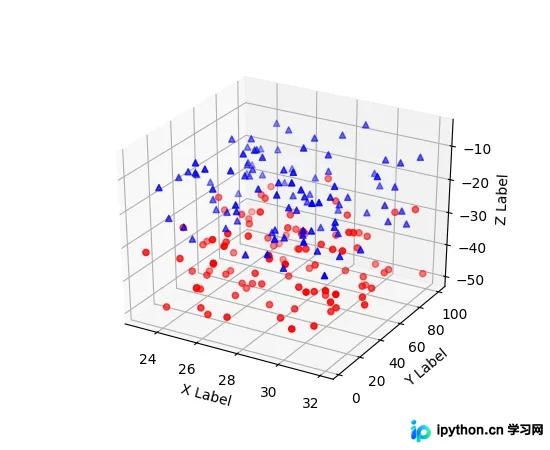
本文详细介绍如何在Python中使用matplotlib库绘制3D散点图。通过导入必要的第三方包,利用Axes3D创建三维坐标轴,并演示如何生成随机数据及设置点的颜色、形状和坐标标签。包含完整的代码示例与效果解析,帮助开发者快速掌握三维数据可视化技巧。
本文通过Python代码详细演示线性回归的三种应用场景:基于房屋面积预测房价、对比《闪电侠》与《绿箭侠》的下一集观众数量,以及利用线性回归填补数据集中的缺失值。文章提供完整的代码示例、数据预处理步骤及模型训练结果解析,帮助读者掌握线性回归的实际编程技巧。
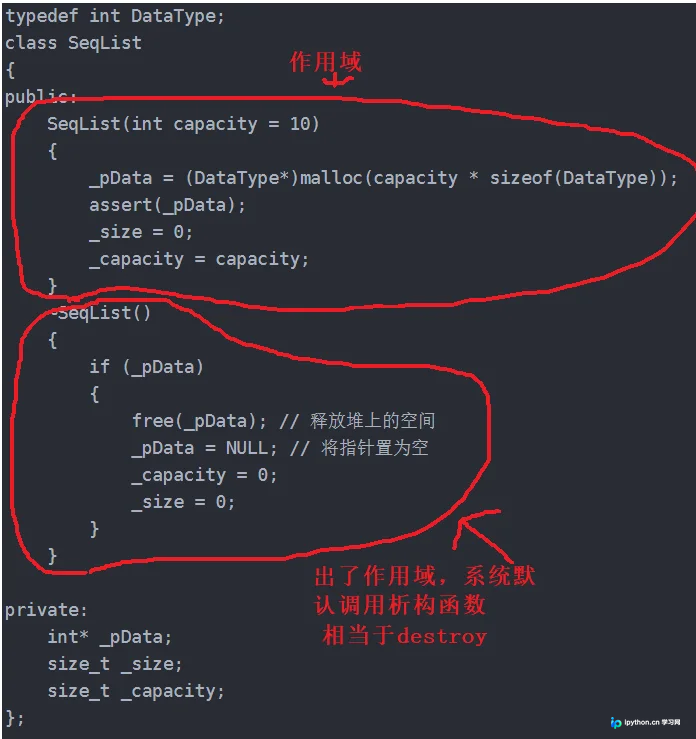
本文解析C++析构函数的核心特征,包括命名规则、无参无返回值特性及其自动调用机制。重点阐述编译器生成的默认析构函数仅处理自定义类型成员,若类中涉及堆内存指针需显式定义析构函数以防内存泄漏,并提供SeqList与Stack类的代码实例说明手动释放资源的操作方法。
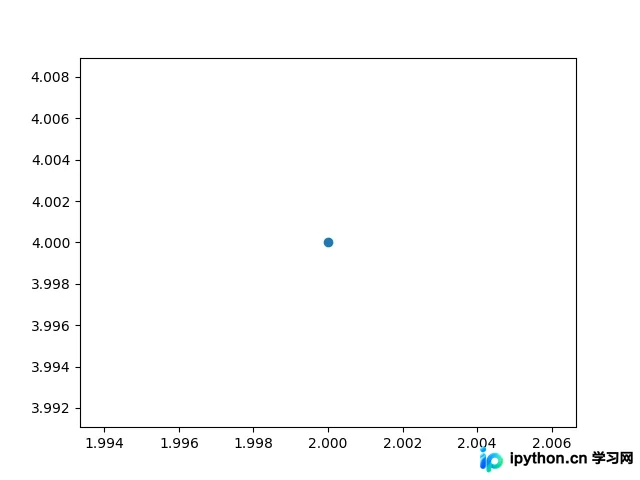
本文详解Python中Matplotlib库绘制散点图的方法。通过scatter()函数展示单点绘制、批量数据生成及样式设置,包括标题、标签和刻度调整。进一步介绍利用axis()控制坐标范围,以及通过cmap参数实现基于数据值的颜色渐变效果,帮助读者掌握可视化核心技巧。
本文介绍Python中用于统计序列元素出现频率的Counter类。通过示例演示如何利用collections模块中的Counter类,结合most_common()方法快速获取列表或字符串中出现次数最多的元素。同时讲解了Counter对象支持加减运算的高级功能,适用于词频统计等数据分析场景。
本文深入解析C语言中auto、register和static三个关键修饰符。通过多文件编译实例,阐明static如何限制全局变量和函数的链接作用域;通过代码演示揭示register请求寄存器存放以提升高频访问性能的原理;并详细说明static如何延长局部变量的生命周期至程序结束,避免栈内存重复销毁,是理解C语言内存管理的核心内容。
本文详解Python中capitalize()与title()两个字符串方法的区别。capitalize()仅将字符串第一个字符转为大写,而title()会将字符串内所有单词的首字母大写。文章通过代码示例展示了普通字符串及非字母开头字符串在两种方法下的不同输出结果,帮助开发者准确选择合适的方法。
本文介绍如何使用Python实现基于二叉树存储结构的堆排序算法。与常见的数组实现不同,该方法通过显式构建二叉树节点来管理数据,重点解决了节点间复杂的交换逻辑。文章提供了完整的Tree类代码示例及运行结果,适合希望深入理解树结构排序原理的开发者参考。
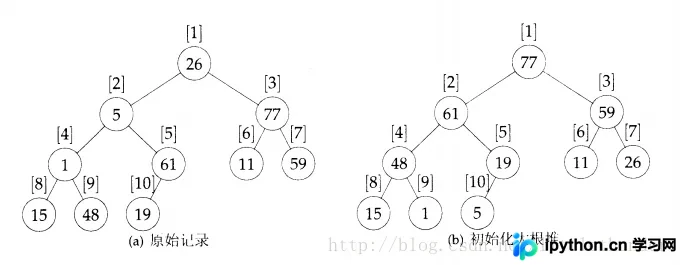
本文深入解析Python中的堆排序算法,通过大顶堆特性演示排序过程。详细讲解了基于堆的优先队列实现,包括fixUp和fixDown函数的调整逻辑,以及完整的堆排序代码示例,帮助开发者掌握排序搜索基本算法。
本文介绍在Python数据分析中,如何利用字典或Series对象对DataFrame进行自定义分组。通过示例演示了groupby方法在列方向上的应用,展示了如何将多个列映射到同一组别(如red、blue)并执行聚合计算。对比发现字典与Series分组原理一致,均通过键值匹配实现数据归类,为灵活处理复杂数据结构提供了实用方案。