Python解析Nginx访问日志统计IP与流量
本文介绍如何使用Python脚本解析Nginx访问日志,统计各IP的访问次数及总流量。通过逐行读取日志文件,利用字符串分割提取IP地址和流量数据,并借助字典结构累加统计结果,最终输出IP访问频次、流量总和及平均流量大小,适用于服务器日常运维与性能监控场景。
2026-10-13
27

本文介绍如何使用Python脚本解析Nginx访问日志,统计各IP的访问次数及总流量。通过逐行读取日志文件,利用字符串分割提取IP地址和流量数据,并借助字典结构累加统计结果,最终输出IP访问频次、流量总和及平均流量大小,适用于服务器日常运维与性能监控场景。
本文介绍如何使用Python的urllib库下载网页源码并保存为本地HTML文件。通过示例代码展示如何获取指定URL的网页内容,并将其以二进制模式写入本地文件。该方法适用于提取纯文本内容,但需注意本地保存的文件不包含外部引用的图片等资源。
本文介绍如何在Python中使用datetime和timedelta模块对当前时间进行增加操作,包括加一天、一小时和一分钟。通过示例代码展示如何获取当前时间、格式化输出以及进行时间增量计算,并提供相关在线工具推荐。
本文介绍如何使用Python的Beautiful库读取本地HTML文件,并通过CSS选择器提取特定网页元素。文章提供了两种代码实现方式,对比了select方法的等效写法以及获取文本的多种途径,最后附带示例HTML结构,帮助开发者快速掌握本地网页数据的解析技巧。
本文通过Python代码演示了如何计算两个数的最大公约数和最小公倍数。内容涵盖非递归与递归两种算法实现,并对比了Python内置库函数的用法。文中提供了完整的代码示例及运行结果分析,帮助开发者理解算法逻辑并应用于实际开发中。
本文介绍如何使用Python的lxml模块提取HTML页面中所有叶子节点的XPath路径。针对原始解析结果包含非叶子节点的问题,提出基于路径包含关系的过滤算法:若当前路径被下一路径包含则跳过,否则视为叶子节点。通过实际代码演示了从原始XPath列表到纯净叶子节点XPath列表的转换过程,并提供了相关XML处理工具推荐。
本文总结Python中几项实用但常被忽视的基础技巧。涵盖利用元组简化startswith/endswith判断、通过start参数控制enumerate索引、使用slice对象命名切片提升代码可读性、在with语句中同时管理多个资源,以及for/while/try语句中else子句的正确使用场景与异常处理规范。
本文深入解析Python中跳台阶、变态跳台阶及矩形覆盖三大经典算法问题。通过推导斐波那契数列递推公式,对比分析不同场景下的递归与迭代实现,提供高效代码示例,帮助开发者掌握动态规划思想及边界条件处理。
本文详细介绍在Mac系统中安装与配置virtualenvwrapper的方法,涵盖从pip3安装到bash/zsh环境变量的设置。通过实例演示如何创建、激活及管理Python虚拟环境,并深入解析利用postactivate钩子自动执行pip安装与环境变量设置的技巧,帮助开发者提升多项目开发的效率与环境隔离安全性。
本文深入讲解PHP面向对象编程的高级特性,涵盖静态成员(static)的定义与调用规则,Final关键字防止类继承与方法重写的机制,以及接口(interface)的定义、实现与多重继承特性。通过具体代码示例阐明self、parent、static在访问控制中的作用及数据访问规范。
本文详细解析 Python3 Selenium 中切换浏览器窗口的两种常用方法。第一种通过获取 window_handles 列表并直接切换至最新句柄,代码简洁且性能较高;第二种通过遍历所有窗口句柄并排除当前窗口来定位新窗口,逻辑直观且易于理解。文章包含具体代码示例及对比分析,帮助开发者根据实际需求选择合适方案。
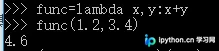
本文深入解析Python中的匿名函数,重点介绍lambda语法的定义方式与使用场景。通过具体示例说明如何创建无标识符的函数对象,并演示直接调用与赋值调用的两种用法,帮助开发者掌握简洁高效的函数编写技巧。