

Python爬虫实现图片写入Word文档的解决方案
本文介绍了一种将Python爬虫获取的图片写入Word文档的方法。针对直接保存二进制数据导致乱码的问题,提出先本地保存图片、利用python-docx库插入图片后再删除本地文件的思路。通过具体代码示例,展示了如何结合requests和BeautifulSoup解析网页,并使用docx库实现图文混排保存,供爬虫开发者参考。
2026-10-13
22

本文介绍了一种将Python爬虫获取的图片写入Word文档的方法。针对直接保存二进制数据导致乱码的问题,提出先本地保存图片、利用python-docx库插入图片后再删除本地文件的思路。通过具体代码示例,展示了如何结合requests和BeautifulSoup解析网页,并使用docx库实现图文混排保存,供爬虫开发者参考。
本文介绍在Python中获取列表元素索引的实用方法。通过内置的list.index()函数可直接定位指定值的索引位置。此外,结合max()和min()函数可快速找到列表最大值或最小值对应的索引下标,适用于数据分析和算法处理场景。
本文介绍如何在Pandas中高效提取包含特定字符串的DataFrame数据。通过演示使用str.contains方法结合正则表达式(如处理点号需转义),生成布尔索引并直接筛选,实现精准数据过滤。
本文针对系统中同时安装Python2.7和Python3.5时,执行pip命令错误调用Python3.5版本的问题,提供解决方案。通过重新编译安装指定版本的pip,可确保命令行工具与预期Python版本一致,解决版本冲突导致的依赖管理错误。
本文详细解析Django在生产环境中的部署方案,涵盖Uwsgi安装、配置及与Nginx的集成。文章区分了WSGI、uwsgi协议与uWSGI服务器的概念,提供了从命令行启动到配置文件管理的完整步骤,并解决静态文件加载问题,帮助开发者实现高效稳定的Web服务部署。
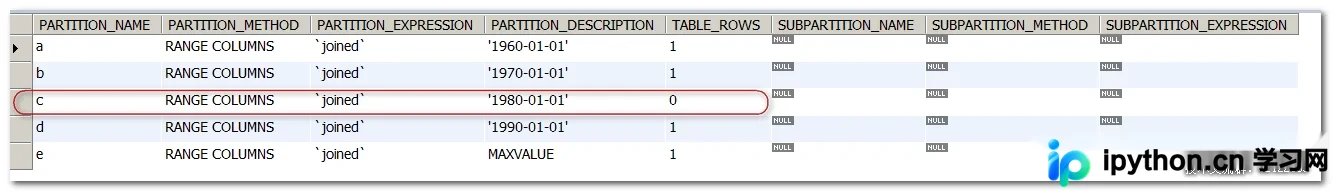
本文深入解析MySQL自5.5版本引入的COLUMNS分区技术,涵盖RANGE和LIST两种模式。重点演示如何利用日期、字符串等多字段直接进行分区,无需额外函数转换,并详细拆解多列分区的比较逻辑、索引优化策略及移除分区的方法,帮助提升大规模数据的存储与管理效率。
本文详解如何在Python Flask框架中集成Flask-APScheduler模块以实现定时任务调度。内容涵盖安装方法、Config配置对象的使用、scheduler初始化流程,以及基于cron和interval触发器的具体代码示例与参数说明,帮助开发者快速掌握Flask下的任务调度方案。
本文介绍如何使用Pandas库中的reset_index方法将Series对象的索引重置为从0开始的连续整数。通过设置drop=True参数,可以删除原有的索引列,从而简化数据结构,便于后续的数据处理与分析操作。
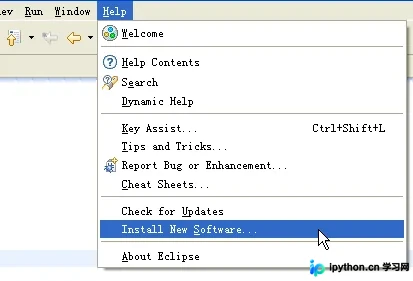
本文详细介绍在Eclipse中安装和配置PyDev插件的完整流程。重点解析PyDev与Eclipse及Java版本的对应关系,解决安装后Preferences中无PyDev选项的问题。提供新旧版插件的更新源地址及具体操作步骤,帮助用户正确配置Python解释器路径,确保开发环境顺利运行。
本文介绍在Python中使用Pandas库处理DataFrame时,如何高效重置或修改列名。通过两个实例演示了使用rename方法结合inplace参数,以及直接对columns属性进行赋值这两种常用操作,帮助开发者快速掌握数据预处理中的关键技巧。
本文介绍在pandas中进行数据映射时如何正确识别NaN值。通过自定义函数结合pd.isnull()判断空值,实现等频或等距切分。示例展示了age_map函数的逻辑及map函数的应用,确保分类准确处理缺失数据。
本文详细解析pandas中loc与iloc在数据选取上的核心差异,loc基于标签索引支持按条件筛选,而iloc基于位置索引。通过具体代码示例展示如何选取指定行列及多条件组合取值,帮助开发者高效处理DataFrame数据。