

MySQL COLUMNS分区详解:RANGE与LIST的实战应用

MySQL自5.5版本引入了COLUMNS分区功能,旨在简化针对非整形或多字段的分区操作。本文详解RANGE COLUMNS与LIST COLUMNS的核心特性,展示如何在不使用函数的情况下直接对日期、字符串等类型进行分区,并通过实际案例剖析多字段组合分区的排序规则、执行计划优化及常见误区,提供完整的建表与维护指南。
COLUMNS分区核心优势与适用场景
COLUMNS分区仅包含 RANGE COLUMNS 和 LIST COLUMNS 两种形式,是传统 RANGE 和 LIST 分区的升级替代方案。其核心优势在于支持直接将多种数据类型作为分区键,无需预先转换为表达式。
支持的列类型与限制
- 整型:支持
TINYINT,SMALLINT,MEDIUMINT,INT,BIGINT。不支持DECIMAL和FLOAT。 - 时间类型:支持
DATE,DATETIME。注意:TIMESTAMP不被支持。 - 字符类型:支持
CHAR,VARCHAR,BINARY,VARBINARY。不支持TEXT和BLOB。
COLUMNS分区允许指定多个列作为分区键,但不支持在分区定义中使用函数表达式(如 YEAR())。
一、RANGE COLUMNS分区实战
RANGE COLUMNS 允许基于多个列的值范围进行分区。由于无需函数处理,对日期字段分区时可直接使用日期值,提升了可读性与维护便利性。
第1步:基于日期字段的单列分区
以下示例创建一个按加入日期(joined)进行范围分区的表。每个分区定义了一个上限值,数据将落入小于该上限值的分区中。
CREATE TABLE members (
id INT,
joined DATE NOT NULL
)
PARTITION BY RANGE COLUMNS(joined) (
PARTITION a VALUES LESS THAN ('1960-01-01'),
PARTITION b VALUES LESS THAN ('1970-01-01'),
PARTITION c VALUES LESS THAN ('1980-01-01'),
PARTITION d VALUES LESS THAN ('1990-01-01'),
PARTITION e VALUES LESS THAN MAXVALUE
);
插入测试数据进行验证:
INSERT INTO members(id, joined) VALUES
(1, '1950-01-01'), (1, '1960-01-01'), (1, '1980-01-01'), (1, '1990-01-01');
查询分区分布情况,确认数据正确归位:
SELECT PARTITION_NAME, PARTITION_METHOD, PARTITION_EXPRESSION,
       PARTITION_DESCRIPTION, TABLE_ROWS
FROM information_schema.PARTITIONS
WHERE TABLE_SCHEMA = SCHEMA() AND TABLE_NAME = 'members';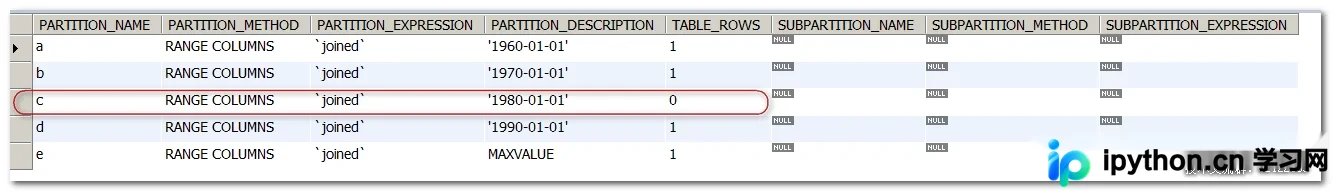
结果显示共有5个分区,插入的4条记录分布在对应分区中。例如,'1980-01-01' 不满足 LESS THAN ('1980-01-01'),因此落入后续分区或符合定义的分区,需结合具体值判断,通常严格小于才进入该分区,等于则进入下一个或MAXVALUE。
第2步:分析执行计划与性能差异
在分区表中,查询条件是否匹配分区键直接影响性能。若使用函数包裹分区列,可能导致全分区扫描。
-- 情况1:使用函数,可能无法精准定位分区
EXPLAIN SELECT id, joined FROM members WHERE joined = YEAR(NOW());

-- 情况2:直接使用字面值,精准定位分区
EXPLAIN SELECT id, joined FROM members WHERE joined = '1963-01-01';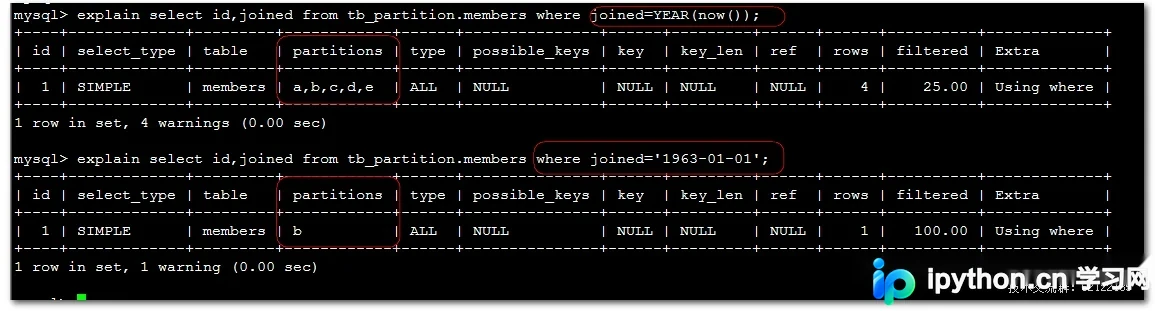
从执行计划可见,直接使用字面值 '1963-01-01' 能准确指向特定分区(Partition B),而使用 YEAR() 函数虽然逻辑等价,但在某些旧版本或特定配置下可能退化为全分区扫描(取决于MySQL优化器能力,但最佳实践是直接匹配原列)。对于COLUMNS分区,务必避免对分区列使用转换函数。
第3步:多字段组合分区逻辑
RANGE COLUMNS支持多列分区,分区值的比较遵循“数组比较”规则:先比第一列,相等再比第二列,以此类推。一旦某列决定了大小关系,后续列不再比较。
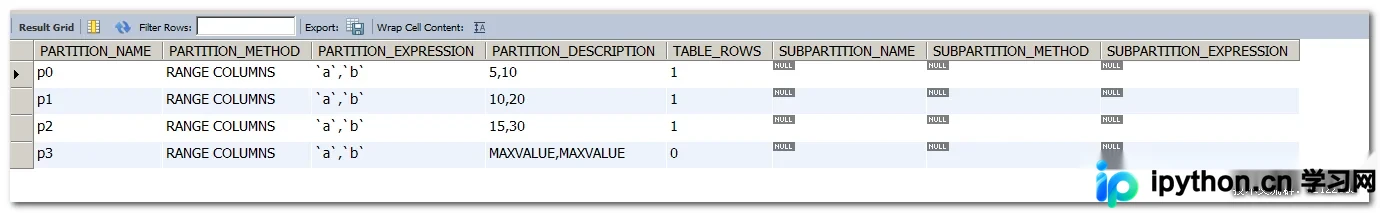
CREATE TABLE rcx (
a INT,
b INT
)
PARTITION BY RANGE COLUMNS(a,b) (
PARTITION p0 VALUES LESS THAN (5, 10),
PARTITION p1 VALUES LESS THAN (10, 20),
PARTITION p2 VALUES LESS THAN (15, 30),
PARTITION p3 VALUES LESS THAN (MAXVALUE, MAXVALUE)
);

INSERT INTO rcx(a, b) VALUES (1, 20), (10, 15), (10, 30);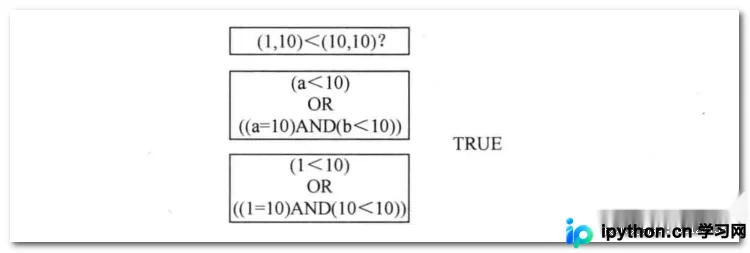
数据分布逻辑解析:
- (1, 20):第一列
1 < 5,成立。直接落入p0,不再比较第二列。 - (10, 15):第一列
10不小于5,尝试下一分区;在p1中10不小于10(注意:LESS THAN是不严格小于吗?不,VALUES LESS THAN (10,20) 意味着要小于这个元组。这里10等于10,需要比大小。若第一个数相等,比较第二个数。15 < 20,成立。故落入p1。) - (10, 30):第一列
10不小于5,也不小于10(相等)。比较第二列:30 不小于 20。跳出p1。进入p2,检查是否小于 (15, 30)。第一列10 < 15,成立。故落入p2。
关键约束:在多列RANGE COLUMNS分区中,第一列的值必须单调递增(即后一个分区的第一列值必须大于前一个)。若出现交叉,如将 p2 定义为 LESS THAN (8, 30),因为 8 < 10,会导致逻辑错误,MySQL将报错拒绝创建。
二、LIST COLUMNS分区实战
LIST COLUMNS 用于离散值的精确匹配,同样支持多列和非整形类型,非常适合枚举类型或非连续日期的分组。
第1步:基于Datetime的非整形字段分区
相比传统LIST分区需要将DATETIME转为Unix时间戳,LIST COLUMNS可直接使用字符串形式的日期时间进行匹配。
CREATE TABLE listvar (
id INT NOT NULL,
hired DATETIME NOT NULL
)
PARTITION BY LIST COLUMNS(hired) (
PARTITION a VALUES IN ('1990-01-01 10:00:00', '1991-01-01 10:00:00'),
PARTITION b VALUES IN ('1992-01-01 10:00:00'),
PARTITION c VALUES IN ('1993-01-01 10:00:00'),
PARTITION d VALUES IN ('1994-01-01 10:00:00')
);

ALTER TABLE listvar ADD INDEX ix_hired(hired);
INSERT INTO listvar VALUES (1, '1990-01-01 10:00:00'),
                           (1, '1991-01-01 10:00:00'),
                           (1, '1992-01-01 10:00:00'),
                           (1, '1993-01-01 10:00:00');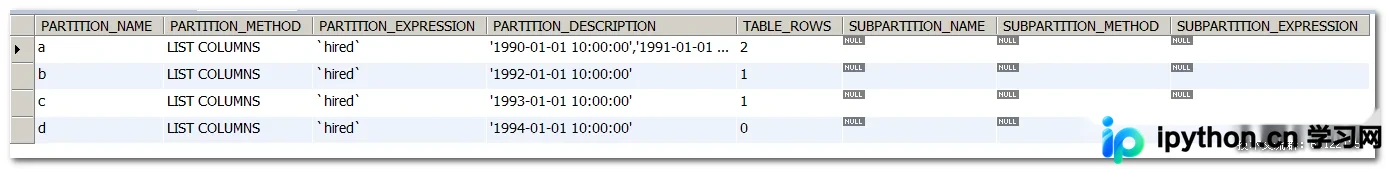
查询时使用精确匹配值,优化器可迅速定位到对应的分区:
EXPLAIN SELECT * FROM listvar WHERE hired = '1990-01-01 10:00:00';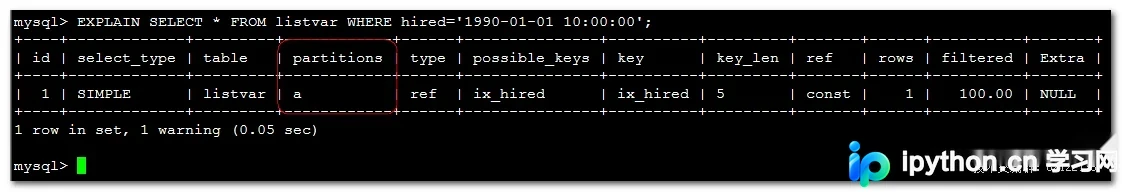
第2步:多字段LIST COLUMNS分区与索引优化
当使用多列作为分区键时,查询条件若能覆盖所有分区列,性能最佳。若只覆盖部分列,可能需要扫描多个分区。
CREATE TABLE listvardou (
id INT NOT NULL,
hired DATETIME NOT NULL
)
PARTITION BY LIST COLUMNS(id, hired) (
PARTITION a VALUES IN ((1,'1990-01-01 10:00:00'), (1,'1991-01-01 10:00:00')),
PARTITION b VALUES IN ((2,'1992-01-01 10:00:00')),
PARTITION c VALUES IN ((3,'1993-01-01 10:00:00')),
PARTITION d VALUES IN ((4,'1994-01-01 10:00:00'))
);

INSERT INTO listvardou VALUES (1, '1990-01-01 10:00:00'), (1, '1991-01-01 10:00:00'),
                               (2, '1992-01-01 10:00:00'), (3, '1993-01-01 10:00:00');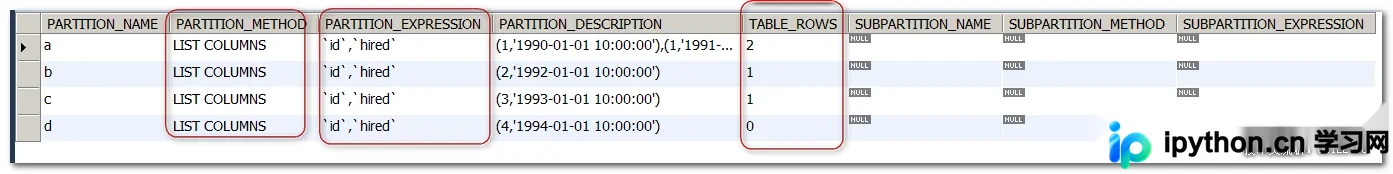
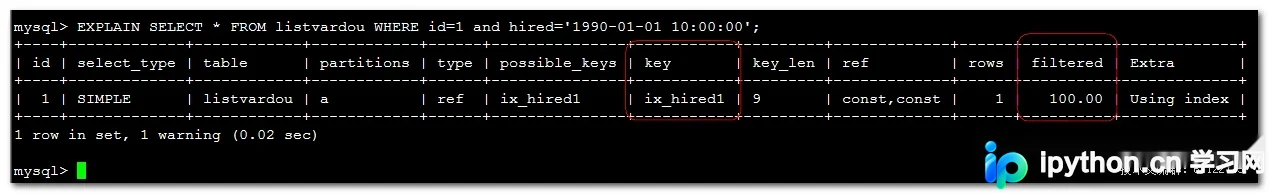
索引策略:对于组合分区键,建议创建联合索引以最大化性能。如果只根据 id 查询,由于 id 不是唯一的分区区分依据(同一ID可能在多个LIST条目中,虽本例是一一对应,但逻辑上需谨慎),单独建 id 索引有效,但联合索引 (id, hired) 效果更优。
ALTER TABLE listvardou ADD INDEX ix_combo(id, hired);执行查询:
EXPLAIN SELECT * FROM listvardou WHERE id = 1 AND hired = '1990-01-01 10:00:00';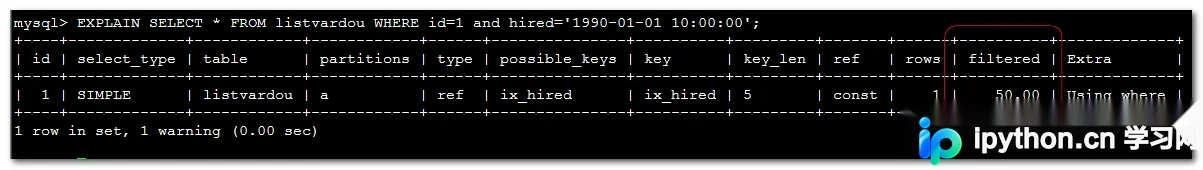
三、维护与管理
移除分区定义
若需取消表的分区状态,可使用 REMOVE PARTITIONING。此操作仅移除分区结构定义,将表恢复为普通堆表,不会删除任何数据。这与 DROP PARTITION(同时删除数据)有本质区别。
ALTER TABLE tablename REMOVE PARTITIONING;总结
RANGE COLUMNS 和 LIST COLUMNS 是 MySQL 处理复杂数据类型分区的关键特性。它们消除了对分区列使用转换函数的需求,使得基于日期、字符串的多列分区更加直观且性能可控。在实际应用中,务必注意多列RANGE分区的第一列单调性约束,并为查询条件匹配相应的联合索引,以充分发挥分区过滤的优势。
以上就是MySQL COLUMNS分区详解与实战应用的详细内容,更多关于MySQL分区优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









