

Scrapy框架实战:从项目创建到MongoDB数据持久化
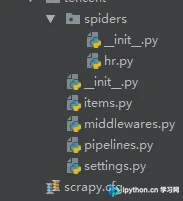
本文详细演示如何使用Scrapy框架创建爬虫项目,定义Items数据结构,编写Spider解析网页HTML并提取职位信息,最后通过Pipeline将数据持久化存储到MongoDB数据库中。涵盖从项目初始化、代码编写到数据落地的完整流程,适合初学者快速掌握Scrapy核心用法。
2026-10-13
33

本文详细演示如何使用Scrapy框架创建爬虫项目,定义Items数据结构,编写Spider解析网页HTML并提取职位信息,最后通过Pipeline将数据持久化存储到MongoDB数据库中。涵盖从项目初始化、代码编写到数据落地的完整流程,适合初学者快速掌握Scrapy核心用法。
本文详解如何在Django项目中集成极验Geetest滑动验证码。涵盖从环境配置、SDK导入到参数设置的全流程,提供初始化预处理、验证回调及前端HTML集成的核心代码示例,帮助开发者快速实现高安全性的用户身份验证功能。
本文详述ThinkPHP框架的本地环境搭建流程,重点解决XAMPP集成环境的安装、Apache与MySQL服务启动失败等常见问题。内容涵盖端口冲突(80/443/3306)的处理方法、VC运行库缺失修复及配置修改步骤,帮助开发者快速排除故障,顺利部署开发环境。
本文详解Python爬虫中模拟登录人人网的两种核心方法。首先介绍使用requests.Session()类自动维持会话状态,通过POST提交表单数据实现登录并抓取个人主页;其次演示如何手动提取并传递Cookie,分别通过Headers和Cookies参数访问受限页面。代码包含完整登录流程与本地保存逻辑,适用于学习爬虫会话保持机制。
本文详细介绍Python中列表append()方法的语法与返回值特性,演示如何添加各类对象及生成多维数组。结合Num库,讲解矩阵转置transpose及数组横向、纵向合并操作,涵盖常见编程场景与注意事项。
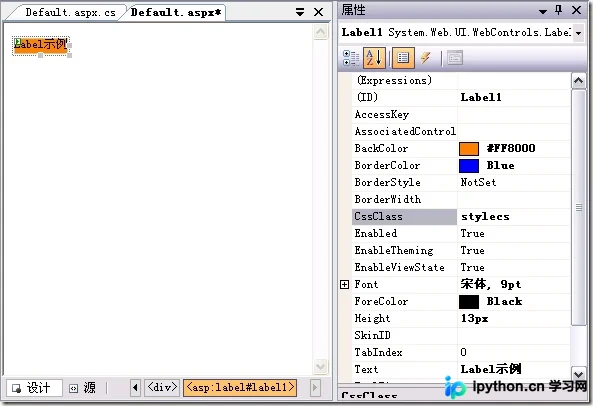
本文详解ASP.NET中Label控件的使用,涵盖ID、Text、CssClass等关键属性的配置方法,以及Load事件与前端设计的联动。通过包含完整的C#后台代码和Default.aspx页面代码示例,展示如何动态控制文本显示外观与焦点,帮助开发者快速掌握服务器端文本标签组件的核心操作。
本文介绍如何使用Python在Windows系统中实现倒计时自动锁屏功能。通过调用ctypes库加载user32.dll并执行LockWorkStation方法,结合time模块控制延时,用户可自定义倒计时秒数,时间结束后系统自动锁定屏幕。
本文介绍如何使用Python库wxpy对接微信接口,实现自动化管理微信公众号及获取个人微信数据。通过调用itchat底层指令,可批量导出好友信息、自动归档聊天记录(含音视频图片)并建立本地数据库。文章提供了基于wxpy.register()实现自动回复、消息转发及特定对象互动的具体代码示例,适用于个人数据备份与基础公众号运营场景。
本文介绍Django中解决跨域请求的两种主流方式:JSONP与CORS。JSONP通过动态创建script标签实现GET请求,需后端配合返回回调函数;CORS则通过在响应头中添加Access-Control-Allow-Origin字段实现更灵活的跨域控制。文章提供具体代码示例,帮助开发者根据场景选择合适方案。
本文详解使用Python提取Bilibili视频弹幕的完整流程。核心在于通过手机User-Agent请求视频页面,利用正则表达式从响应JavaScript中提取弹幕接口所需的cid参数,拼接生成以.xml结尾的弹幕URL。随后发起二次请求获取XML数据,借助lxml库解析并提取文本内容,最终保存至本地文件。

本文详解Pandas中利用.sort和.loc函数进行数据排序与筛选的方法,涵盖单列与多列排序、条件组合逻辑。进一步演示如何结合聚合函数实现类似Excel的Sumif、Countif及Averageif统计功能,助力高效数据处理。
本文详细介绍MySQL数据库中MyISAM表的日常维护与修复方法。通过OPTIMIZE TABLE语句、mysqlcheck命令行工具及myisamchk离线工具,对表进行碎片整理、统计更新及故障修复。文章包含具体命令参数、适用场景及操作风险提醒,帮助用户提升数据库性能。