

在Anaconda3下使用清华镜像源安装TensorFlow(CPU版)
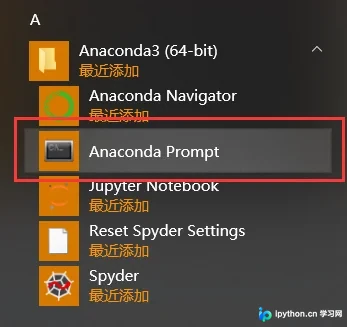
本文详细讲解如何在Anaconda3环境下,通过配置清华大学开源软件镜像源来安装TensorFlow CPU版本。内容涵盖环境创建、镜像配置、库安装、版本验证以及在Jupyter Notebook中的集成使用方法,帮助开发者快速搭建本地AI开发环境。
2026-10-13
25

本文详细讲解如何在Anaconda3环境下,通过配置清华大学开源软件镜像源来安装TensorFlow CPU版本。内容涵盖环境创建、镜像配置、库安装、版本验证以及在Jupyter Notebook中的集成使用方法,帮助开发者快速搭建本地AI开发环境。
本文通过具体案例解析MySQL优化器在查询执行计划中的决策逻辑。详细阐述Range Analysis阶段如何评估记录数,以及优化器如何通过穷举Left-Deep Tree来寻找最优JOIN顺序和访问方式。对比正常数据分布与极端倾斜情况下的执行差异,揭示基于统计信息预估可能导致的Bad Case,帮助DBA理解底层机制以优化SQL性能。
本文详细解析如何在Python项目中创建和管理虚拟环境,重点介绍使用virtualenv和virtualenvwrapper-win进行环境隔离的方法。内容涵盖从安装依赖包、创建及切换虚拟环境,到在PyCharm中配置自定义环境,以及最终执行alembic init初始化数据库迁移工具的完整操作流程,帮助开发者规范项目环境配置。

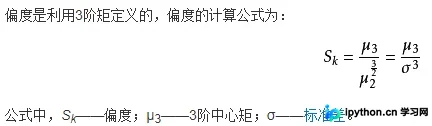
本文详细介绍在Python中使用scipy库进行数据正态性检验的多种方法。涵盖Shapiro-Wilk检验(适用于小样本)、K-S检验、normaltest、Anderson-Darling检验以及偏度和峰度检验。通过具体函数定义、参数说明及代码示例,帮助开发者掌握如何判断数据是否符合正态分布,为T检验等统计分析奠定基础。
本文详细介绍Python中json模块的使用方法,涵盖字典与JSON字符串的相互转换。重点解析json.dumps和json.loads函数的参数配置,如ensure_ascii、indent和sort_keys的作用,并演示如何将数据写入JSON文件及从文件读取数据,提供完整代码示例。

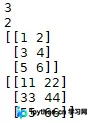
本文详细介绍Python中利用numpy库进行数组拼接的两种主要方式:np.append和np.concatenate。通过具体代码示例,解析一维及多维数组在指定axis维度下的拼接行为,重点说明concatenate在处理高维数据时如何通过axis参数控制元素添加方向,帮助开发者掌握高效的数据处理技巧。
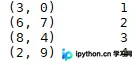
本文详细介绍Python中稀疏矩阵的创建与参数保存方法。通过scipy.sparse.coo_matrix构建稀疏矩阵,利用todense转换为密集矩阵,并演示如何使用numpy.save和np.savez保存单个或多个数组及稀疏矩阵。最后讲解如何加载.npz文件并提取参数名称与值,适用于模型训练中的参数持久化场景。
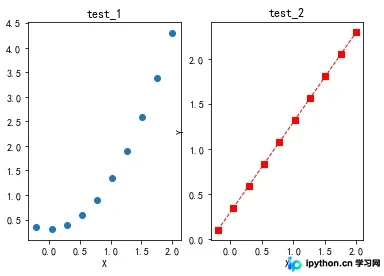
本文详细介绍Python中Matplotlib库的figure函数关键参数,包括尺寸、分辨率及颜色设置。通过具体代码示例演示如何使用subplot创建子图并分别设置绘图属性,以及如何在同一画布中混合显示散点图和折线图。掌握plt.show()的正确调用时机,即可实现复杂的多图形组合展示。
本文深入解析Python中try-except异常捕获机制,涵盖备用程序配置、单/多异常捕获、通用Exception混用、else无异常执行及finally始终执行等核心场景,结合代码示例说明如何在循环中处理ZeroDivisionError与TypeError,确保程序稳定运行。
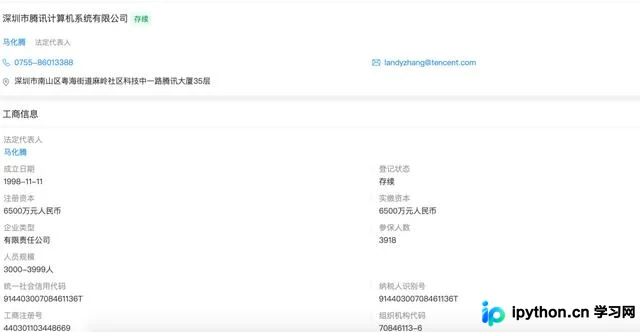
本文介绍利用Python结合Selenium与Web接口技术,实现无账号、无IP限制地批量获取全国企业基本信息的方法。通过对比Selenium登录验证、Requests Cookie请求等方案的局限性,最终确定仅依赖IP代理即可有效获取可公开展示的企业数据,为数据分析提供基础素材。
本文介绍一款名为 LogicSugar 的 C# 通用扩展工具类,旨在通过“逻辑糖”简化代码。该类提供了 Switch Case 链式调用、类似三元表达式的 IIF 方法以及 And/OR 逻辑组合功能,可显著减少重复代码和冗余的 break 语句,提升阅读体验并降低编写难度,特别适用于 MVC Razor 等对嵌套符号敏感的场景。
本文介绍使用Python3解压IPA包并提取文件大小的方法,同时详细对比了合并两个有序数组的两种思路:第一种直接合并后排序效率较低;第二种通过比较头元素并移除的方式虽逻辑直观但remove操作耗时。最终推荐采用索引比较法替代移除操作,实现更高效的合并排序。