

Django Admin 实现外键过滤的方法
本文介绍在 Django Admin 中实现外键数据按当前登录用户过滤的方法。主要涵盖两处场景:在列表页限制可见数据,以及在新增或编辑表单中动态过滤关联外键选项。通过重写 get_queryset、save_model 以及 render_change_form 等方法,结合 get_changeform_initial_data 传递初始参数,可有效实现基于用户权限的数据隔离与过滤。
2026-10-14
23

本文介绍在 Django Admin 中实现外键数据按当前登录用户过滤的方法。主要涵盖两处场景:在列表页限制可见数据,以及在新增或编辑表单中动态过滤关联外键选项。通过重写 get_queryset、save_model 以及 render_change_form 等方法,结合 get_changeform_initial_data 传递初始参数,可有效实现基于用户权限的数据隔离与过滤。
本文详细介绍如何在同一服务器上使用virtualenv为多个Python项目创建独立的运行环境,解决依赖冲突问题。涵盖安装方法、环境创建、激活退出、全局库继承、路径修改及uwsgi集成配置,帮助开发者高效管理Python版本与第三方库。
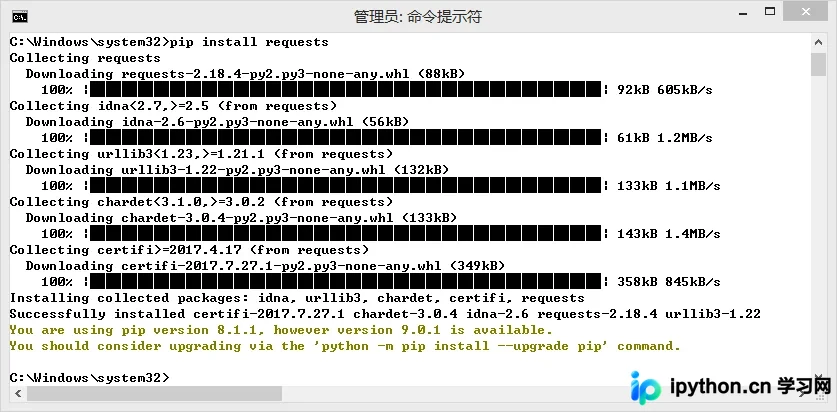
本文系统讲解Python网络爬虫的核心技术与Requests库的实战应用。内容涵盖Requests库的安装配置、核心方法解析(get/post等)、Response对象属性及异常处理机制。深入剖析HTTP协议、URL结构及PATCH与PUT的区别,并结合京东、亚马逊商品爬取、搜索引擎关键词提交、图片存储及IP查询等具体案例,展示网络爬虫的实际操作流程与注意事项。
PHP 5.1.0及以上版本默认使用格林威治标准时间(UTC),导致本地显示时间比北京时间晚8小时。通过修改 php.ini 中的 date.timezone 参数为 Asia/Shanghai 可解决该问题。需注意集成环境(如 XAMPP)中配置文件的具体路径,确保生效。
本文介绍在 PHP 中通过正则表达式或内置函数 strip_tags() 清除 HTML 标签、脚本、样式表及注释的方法。提供完整的 preg_replace 数组配置示例,涵盖去除 script/style、过滤实体字符及空白处理,帮助开发者快速实现字符串内容净化。
在 JavaScript 中将数据库文本动态赋值给 TEXTAREA 时,直接使用 innerText 会导致换行符显示异常。核心解决方案是使用 value 属性替代 innerText,并确保后端正确对特殊字符进行 URL 编码或 JSON 序列化,从而保留原始排版结构。
本文介绍如何使用PHP脚本自动从HTML文件中批量抓取ED2K(电驴)下载链接。通过读取文件内容,利用字符串定位函数精准截取href属性中的资源路径,并逐个保存至日志文件,解决手动复制多个磁力或ED2K链接效率低下的问题。
本文梳理了从ASCII到UTF-8的字符编码发展史,重点解析Python2与Python3在字符串处理上的核心差异。通过具体代码示例,展示了Python2中字节串与Unicode互转的decode/encode流程,以及Python3中字符串直接编码为字节串的新机制,帮助开发者理解不同版本下的编码转换逻辑。
本文详细介绍如何在C# Web项目中实现用户登录功能。通过创建数据库表,配置Web.config连接字符串,并构建CS(控制层)、BLL(业务逻辑层)、DAL(数据访问层)和Common(公共层)的三层架构模式,指导您完成一个标准的身份验证模块搭建。
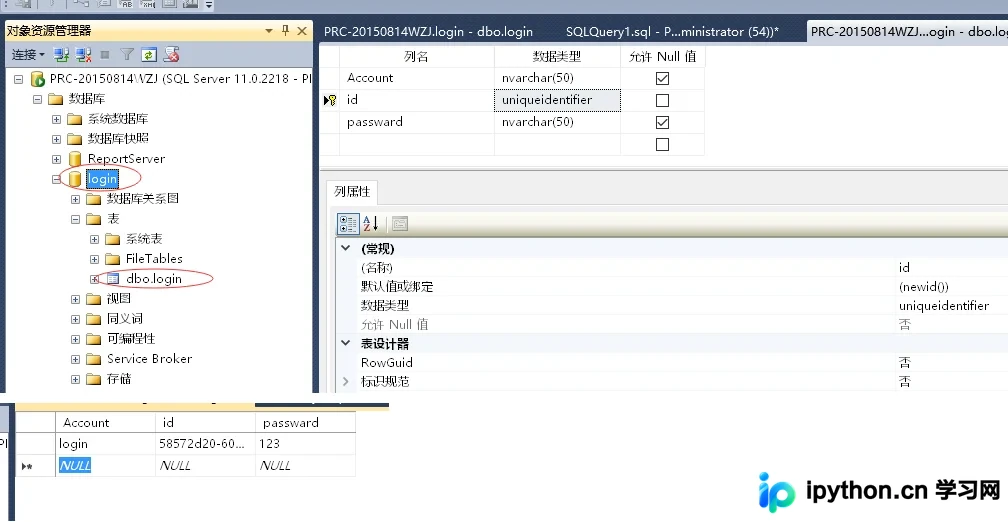
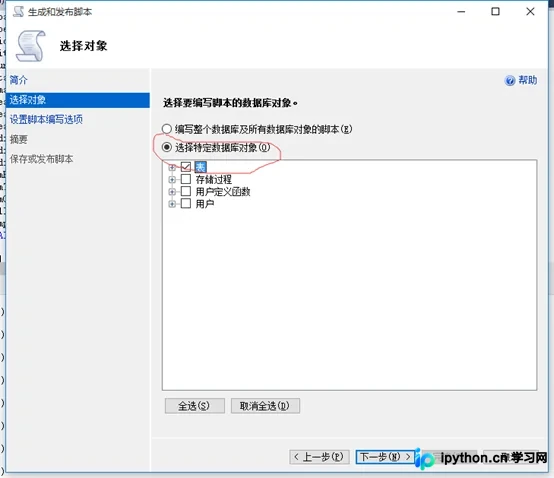
由于 SQL Server 不支持直接将高版本备份文件还原至低版本,本文提供基于脚本生成与数据导入的通用解决方案。核心流程包括:在高版库通过“生成脚本”工具导出架构与数据(需调整目标版本选项),在低版库创建空库并执行建表语句,最后利用 SSMS 的数据导入向导将高版库数据映射写入。此方法确保结构一致且数据完整迁移。
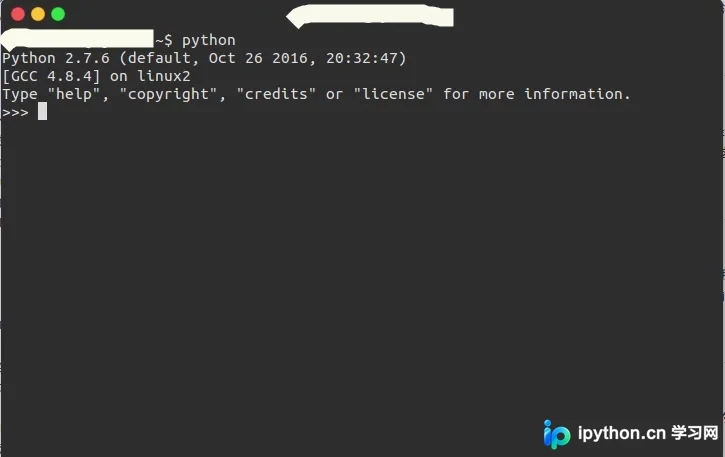
本文介绍Python在信息学竞赛中的辅助作用,重点涵盖安装配置、基本语法、数据类型、输入输出及文件操作。文章指出Python虽不适合核心算法实现,但在编写数据生成器和简单小程序时具有语法简洁的优势,并提供了随机数生成与文件读写的具体示例。
本文详细记录了使用Python编写小说爬虫的全过程。文章从确定目标网址、分析页面结构入手,重点讲解了如何使用urllib.request获取网页内容,并通过设置Headers解决403 Forbidden错误。同时,针对常见的编码乱码问题,介绍了使用chardet库检测编码及手动指定GBK编码的方法,并结合socket.timeout处理网络超时异常,最终通过正则表达式提取章节内容并写入文件,提供了完整的代码实现参考。