

Python id() 函数详解:内存地址、对象标识与 is 运算符的区别
本文深入解析Python中id()函数的核心作用,即返回对象的唯一内存地址。通过对比复合类型与基础类型的id变化,阐明is运算符基于内存地址比较而==基于值比较的本质差异,帮助开发者理解对象生命周期与内存管理。
2026-10-14
30

本文深入解析Python中id()函数的核心作用,即返回对象的唯一内存地址。通过对比复合类型与基础类型的id变化,阐明is运算符基于内存地址比较而==基于值比较的本质差异,帮助开发者理解对象生命周期与内存管理。
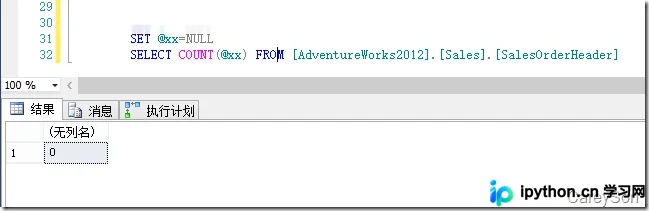
本文澄清了 SQL Server 中 Count(*)、Count(1) 和 Count(列名) 的执行差异。实际上,只要表达式非 NULL,三者结果完全一致。核心原理是评估表达式是否为空。在性能方面,SQL Server 会自动选择最窄的非空列索引进行计数扫描,无需特意修改写法。通过建立短列索引可显著提升 COUNT(*) 查询效率。
本文详细解析Python中函数的四种参数定义形式:位置参数、关键字参数、*args元组参数及**kwargs字典参数。通过对比分析,阐述它们在函数调用时的匹配规则、默认值处理及混合使用时的优先级顺序,帮助开发者灵活掌握参数传递机制。
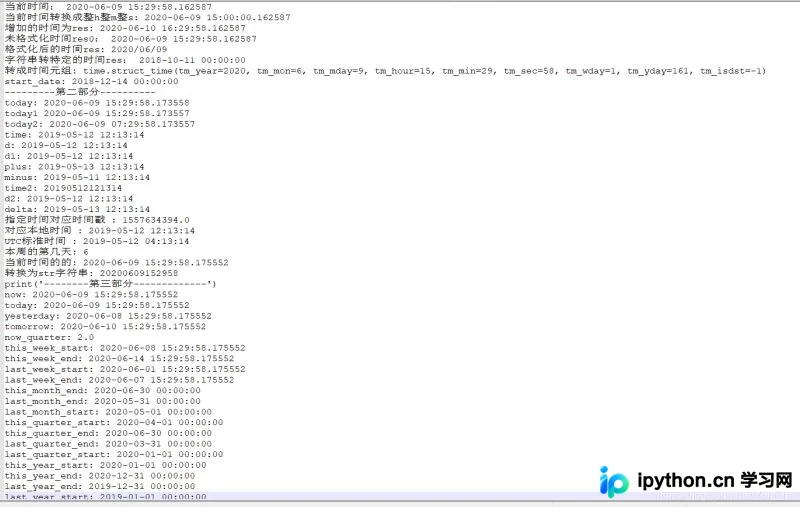
本文详解Python中datetime模块的核心用法,涵盖当前时间获取、字符串与时间对象的双向转换、时间片段的替换与加减运算,以及跨年日期的计算逻辑。通过具体代码示例,展示如何高效处理日常开发中的时间格式化与计算需求。
本文深入探讨Python中提升计算速度的四种核心方法。通过对比原生循环、NumPy数组运算、numexpr表达式引擎及多线程技术,展示从纳秒级到秒级的性能差异。文章结合具体代码示例与基准测试结果,为数据处理和科学计算场景提供高效的性能优化方案。
针对单机备份存在风险的场景,本文介绍如何通过T-SQL脚本将SQL Server数据库备份到局域网内的其他计算机。核心步骤包括使用net命令建立网络驱动器映射、利用日期格式生成唯一文件名执行数据库备份,以及事后断开连接。配合SQL Server代理作业可实现全自动无人值守的远程定时备份。
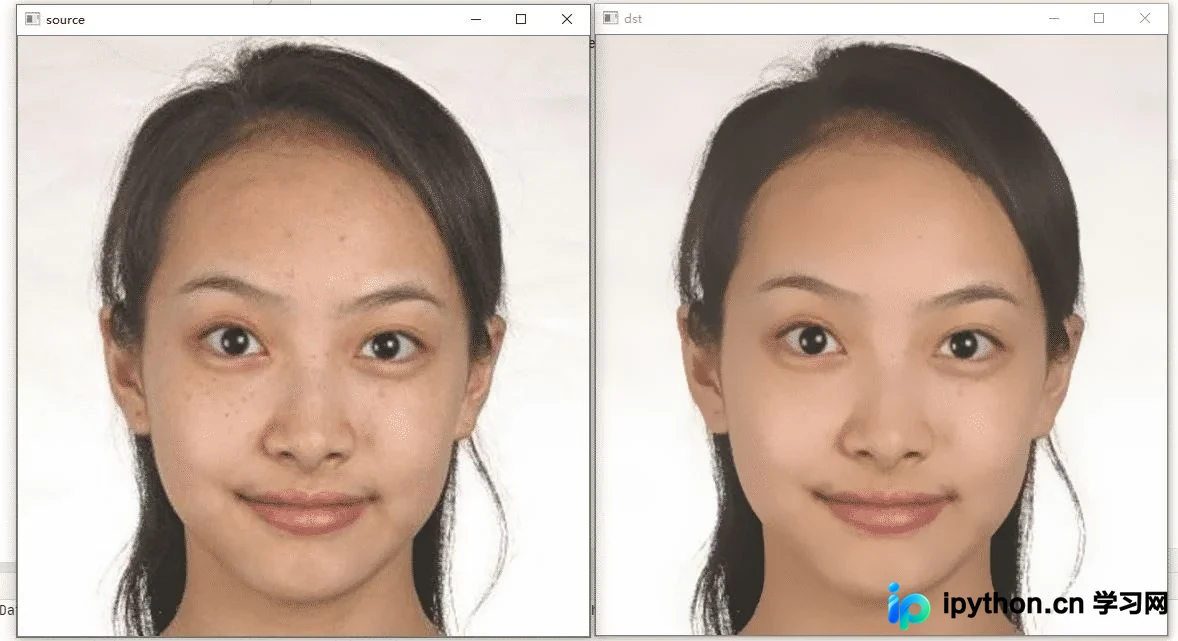
本文详解如何利用Python和OpenCV实现在线批量图片美颜功能。重点解析双边滤波算法原理,通过结合空间距离与像素值相似度实现保边降噪,并附带完整代码示例及参数说明,帮助开发者理解并应用该图像处理技术。
本文深入解析TensorFlow中tf.gradients()与tf.stop_gradient()的核心机制。tf.gradients()用于计算目标函数对变量的导数,支持自定义梯度更新;tf.stop_gradient()则用于阻断特定节点的梯度反向传播。通过代码示例展示如何在模型训练中实现前向与反向传播的解耦,以及利用stop_gradient构造自定义梯度更新策略。
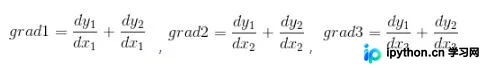
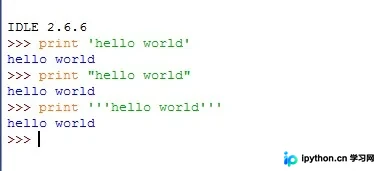
本文深入解析Python字符串的核心机制,涵盖单引号、双引号及三引号的声明差异,辨析str与unicode编码在中文处理中的表现。详细讲解转义字符与原始字符串(r/R)的使用场景,对比raw_input与input函数的行为区别,并演示基于百分号的字符串格式化输出技巧,帮助开发者掌握Python文本处理基础。
本文通过具体代码实例对比Java与Python在计算10万以内质数时的执行效率。结果显示Java运行耗时约14毫秒,而Python耗时近700毫秒,Java在循环处理与执行效率上显著占优;Python代码结构清晰,可读性更强。两者各有适用场景,开发者可根据对性能或开发效率的需求进行选择。
本文介绍了在Go语言中利用标准库 encoding/base64 对字符串进行Base64编码的具体方法。通过创建一个 bytes.Buffer 作为输出容器,结合 base64.NewEncoder 指定编码格式(如URL安全编码),演示了如何将数据写入编码器并获取最终编码结果。该方法简洁高效,适用于需要处理数据序列化的场景。
本文深入解析Go语言中截取字符串的正确姿势,特别是处理包含中文等多字节字符时的常见陷阱。通过自定义Substr函数,展示如何利用rune类型正确计算字符边界,避免切片操作导致的乱码问题,并提供完整的代码示例供开发者参考。