

SQL Server中Count(*)、Count(1)与Count(列名)的区别及性能优化

在 SQL Server 开发中,关于 Count(*)、Count(1) 以及 Count(列名) 的性能争论由来已久,常有人建议将前者改为后者以提升性能。事实并非如此,这三者在特定条件下具有相同的语义和执行结果。理解其背后的评估逻辑有助于编写更清晰的代码,并针对高频查询场景制定正确的索引策略。
Count 函数的执行原理
Count() 作为聚合函数,其核心行为是评估括号内的表达式是否为 NULL。如果表达式的计算结果为 NULL,该行不计入总数;如果为非 NULL 值,则计入总数。
许多人误以为 Count(*) 意味着全表扫描所有数据行,而 Count(1) 因为是一个常量所以更快。这是一种误解。Count(1) 中的 1 是一个非空的整数常量,对于表中的每一行,该表达式的值都是 1(非 NULL),因此它会计数该行。同理,Count('*')、Count('any_string') 甚至 Count(GetDate()),只要表达式恒定非空,其结果都会统计所有行。
为了验证这一点,我们可以观察当表达式为 NULL 时的情况。如下所示的代码清单演示了如何构造一个恒为 NULL 的表达式:
DECLARE @xx INT
SET @xx=NULL

SELECT COUNT(@xx) FROM [AdventureWorks2012].[Sales].[SalesOrderHeader]
由于变量 @xx 被显式设置为 NULL,且 Count() 会忽略 NULL 值,无论表中有多少行,结果都将为 0。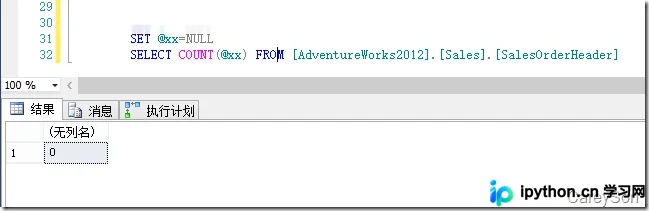 图1.显而易见,结果为0
反之,如果我们使用非空表达式,例如: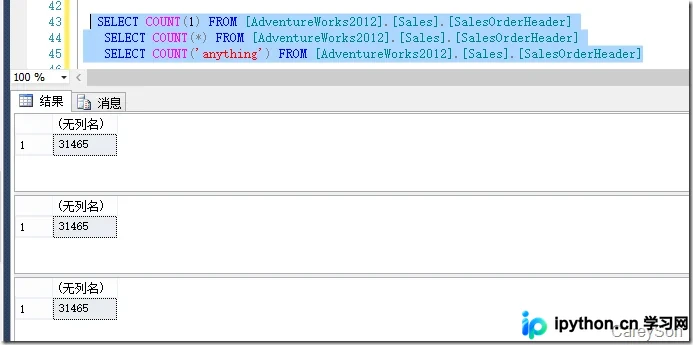 图2.只要在Count中指定非NULL表达式,结果没有任何区别
从图中可以清晰看到,无论是 Count(*)、Count(1) 还是其他非空常数,返回的行数完全一致。
Count(列名)的特殊性
上述规则同样适用于 Count([Column])。它的逻辑是遍历指定列的每一行,检查该单元格的值是否为 NULL。
- 如果某行的该列值为
NULL,该行不计入统计。 - 如果某行的该列值不为
NULL(包括空字符串''),该行计入统计。
因此,Count(列名) 实际统计的是“该列非空值的行数”,这与 Count(*)(统计总行数,无论各列值为何)在处理包含 NULL 值的数据时会有显著差异。
SQL Server 如何执行 Count(*)?
既然确定要统计行数,SQL Server 优化器在执行 Count(*) 时并不需要读取表中的完整数据页或所有列。它的目标是快速找出“存在多少行”。为了实现这一目标,SQL Server 会选择一种最高效的方式来扫描行数。
第1步:寻找非空列
SQL Server 会在表中寻找一个明确标记为 NOT NULL 的列。因为根据定义,NOT NULL 列永远不会有 NULL 值,所以该行一定被计数。
第2步:利用索引进行高速扫描
一旦找到合适的 NOT NULL 列,优化器会查看该列是否有索引。如果有索引,它会优先使用索引来统计行数,因为索引条目比数据行小得多,扫描速度更快。
关键优化点:选择最窄的索引
如果同一个 NOT NULL 列上有多个索引,或者表中有多个 NOT NULL 列都有索引,SQL Server 通常会选择最窄(占用字节数最少)的非聚集索引来进行计数。这是因为较窄的索引页能容纳更多的键值对,减少 I/O 操作次数。
我们可以通过 AdventureWorks2012 数据库的实验来直观展示这一过程:
第3步:实验验证 - DateTime 列索引
首先,我们在 [Person].[Address] 表上删除所有非聚集索引。随后,在一个数据类型为 DateTime(占用8字节)的 ModifyDate 列上创建索引。此时执行查询,执行计划如图3所示,系统使用了这个 DateTime 类型的索引。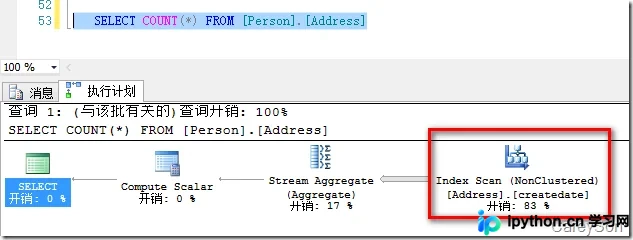 图3.使用了CreateDate的索引
第4步:实验验证 - INT 列索引切换
接着,我们在另一个 NOT NULL 列 StateProvinceID 上创建索引。该列类型为 INT,仅占用4字节,比之前的 DateTime 列更短。再次执行 Count(*) 查询,SQL Server 优化器自动选择了更短的 StateProvinceID 索引。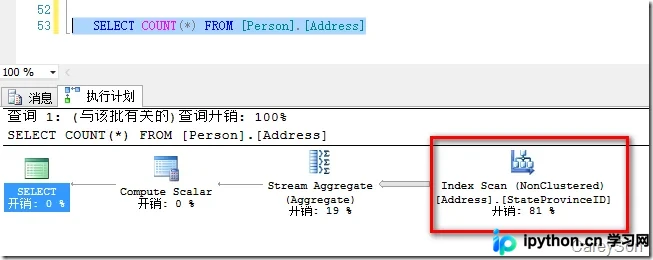 图4.选择了更短的StateProvinceID索引
这证明了 SQL Server 内部确实会自动权衡,选择代价最低(最窄)的路径来完成任务。
性能优化建议
基于上述原理,针对频繁使用 Count(*) 的表,可以采取以下措施优化性能:
- 无需更改 SQL 写法:你不需要刻意将
Count(*)改为Count(1)来寻求性能提升,它们在逻辑和优化层面上等效。 - 建立窄索引:如果表的行数极大且
Count(*)查询成为瓶颈,考虑在表中选择一个占用字节数极少的NOT NULL列(如INT或TINYINT类型)建立一个单列非聚集索引。这将极大地加速行数统计过程。
以上就是 SQL Server 中 Count(*) 与 Count(1) 的区别及底层执行原理的详细内容,更多关于 SQL Server 索引优化与查询性能的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









