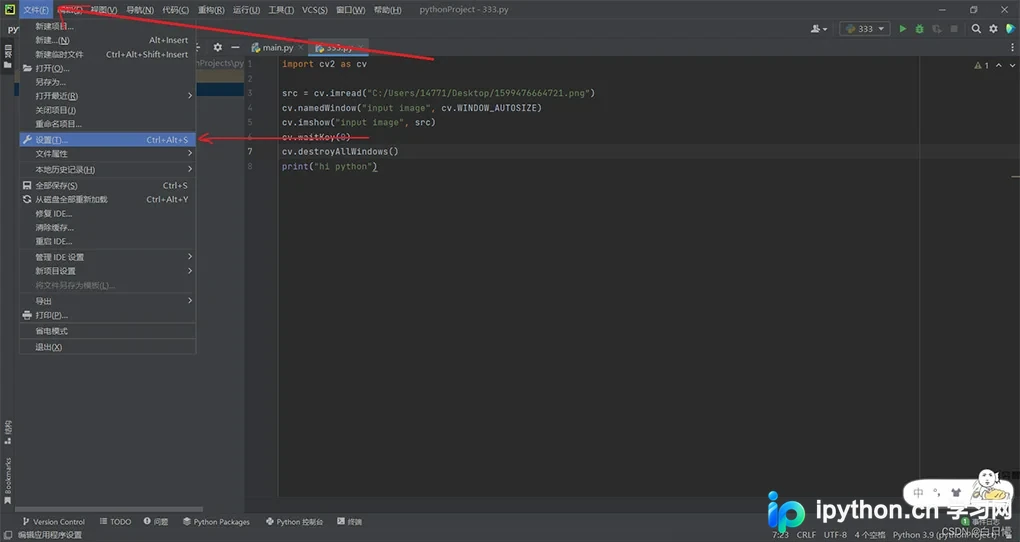
PyCharm配置国内镜像源并快速安装OpenCV教程
本文详解如何在PyCharm中更换国内Pip镜像源以解决下载缓慢问题,并演示基于清华镜像源安装OpenCV-Python库的具体步骤。通过配置Python解释器仓库地址,可显著提升依赖包下载速度,最后提供简单的测试代码验证安装是否成功。
2026-10-15
11

本文详解如何在PyCharm中更换国内Pip镜像源以解决下载缓慢问题,并演示基于清华镜像源安装OpenCV-Python库的具体步骤。通过配置Python解释器仓库地址,可显著提升依赖包下载速度,最后提供简单的测试代码验证安装是否成功。
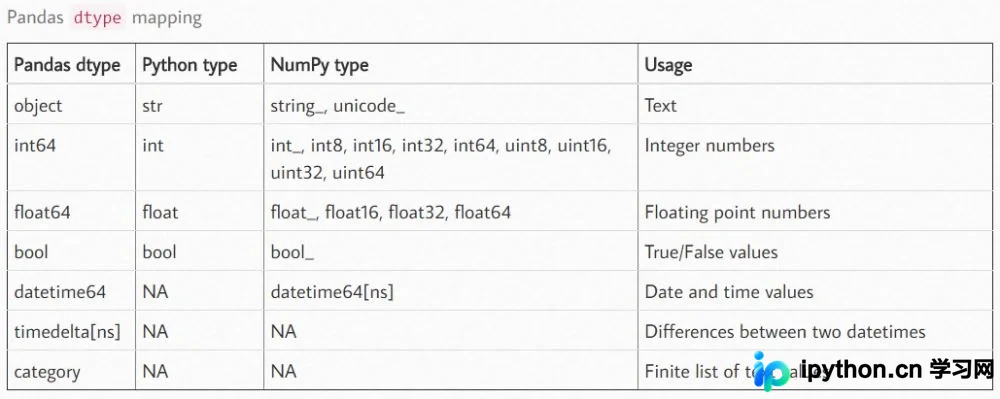
本文详细介绍Pandas中查看和转换数据类型的核心方法。通过df.dtypes、df.shape及df.info()快速获取数据框的维度、列名、非空计数及内存占用等关键信息。重点讲解df.astype()函数的多种用法,包括全局转换、指定列转换及索引类型转换,并深入解析object类型的特殊性及其清洗策略,帮助开发者高效处理数据格式问题。
本文详细介绍Python中Fuzzywuzzy模块的使用方法,涵盖fuzz和process两大核心模块。通过fuzz.ratio、partial_ratio、token_sort_ratio及token_set_ratio等函数实现字符串相似度计算,并利用process.extract和extractOne从候选集中快速检索最相似文本,附带完整代码示例与参数说明。
本文详细介绍Pandas中astype()函数的用法,涵盖基础类型转换、处理非标准数据格式(如含百分号的字符串)以及加载时指定类型。通过示例解析如何安全地将数值、字符串及时间类型进行转换,并指出转换失败时的处理策略,帮助开发者高效进行数据清洗。
系统介绍如何使用Python符号计算库SymPy求解微积分中的积分解析解,涵盖符号变量声明、不定积分与定积分的核心函数integrate用法、双重与广义积分实战、与SciPy数值计算的对比以及常见问题排查与反向求导验证。
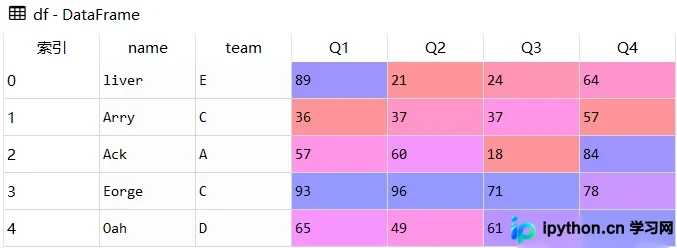
本文详细介绍Pandas中df.sort_index()函数的使用方法,包括默认的升序排列及通过ascending=False实现降序排序。同时讲解df.reindex()如何自定义行和列的索引顺序,涵盖axis参数及具体代码示例,帮助开发者高效管理DataFrame数据顺序。
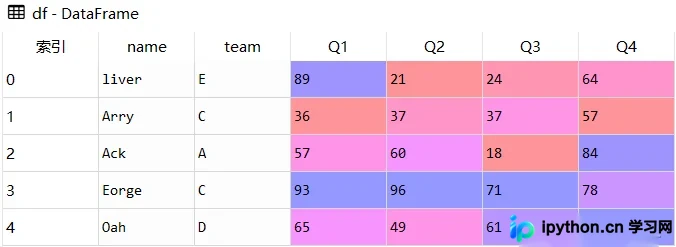
本文深入解析Pandas中sort_values()函数的核心用法,涵盖by、axis、ascending等关键参数的配置细节。通过Series与DataFrame的实例演示,展示单列、多列及混合升降序的排序技巧,并补充处理缺失值、原地修改及索引重置等高级操作,帮助开发者高效实现数据排序需求。
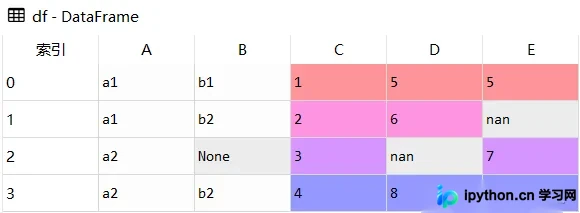
本文详细介绍Pandas库中df.dropna()函数的使用方法,涵盖axis、how、thresh、subset及inplace等核心参数的具体含义与操作示例。通过代码演示整行整列删除、条件过滤及原地修改等常见场景,帮助开发者高效处理数据中的空值。
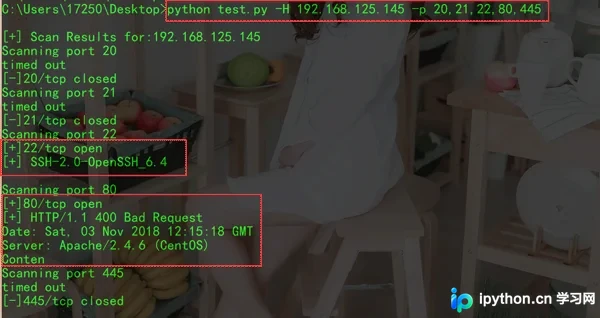
本文介绍如何使用Python编写端口扫描器,分别基于Socket模块和python-nmap库。通过Socket实现TCP三次握手检测,利用python-nmap调用nmap引擎扫描指定主机或网段。文章详细解析了命令行参数配置、多线程处理及结果输出,适用于网络安全学习与基础扫描工具开发。
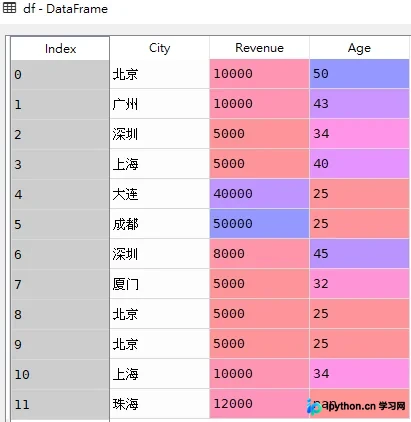
本文详细介绍Pandas库中value_counts()方法的使用。该函数用于统计Series或DataFrame指定列中各值的出现频次,返回排序后的Series。文章解析了sort、ascending、normalize、bins及dropna等关键参数的具体作用,并通过包含城市、营收及年龄数据的DataFrame示例,演示了降序、升序、标准化占比计算以及NaN值处理等实际应用场景。
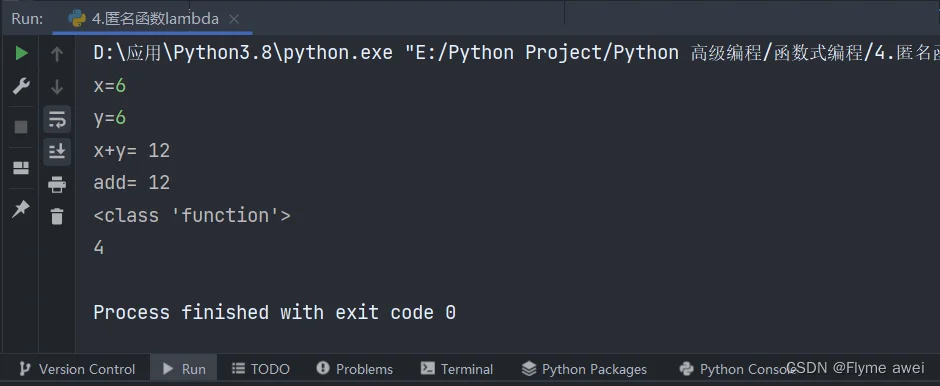
本文深入解析 Python 中 lambda 匿名函数的定义、语法结构及核心特性。详细对比普通函数与 lambda 在 def 和 return 上的差异,阐述其单表达式返回机制。通过 filter、map、reduce 等内置高阶函数的实例,展示 lambda 在简化代码、提升执行效率及配合函数式编程中的实际应用场景。
本文深入解析Python中enum枚举类的核心用法。通过对比传统大写变量定义方式,阐述使用Enum类定义常量的优势。详细演示枚举的创建、成员访问、__members__遍历及别名处理机制,并介绍如何利用unique装饰器强制键值唯一性,帮助开发者在工程实践中规范使用枚举类型。