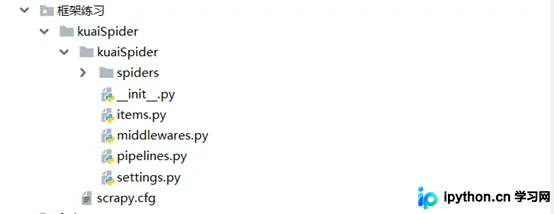
Python Scrapy框架核心原理与实战入门指南
本文深入解析Python Scrapy框架的核心架构与工作流程。Scrapy基于Twisted异步网络库,由引擎、调度器、下载器、爬虫及管道等组件协同工作,高效实现网页数据抓取。文章详细阐述了各组件职责,并提供了从创建项目到生成爬虫的完整命令示例,帮助开发者快速掌握这一强大爬虫工具的基础应用。
2026-10-14
10

本文深入解析Python Scrapy框架的核心架构与工作流程。Scrapy基于Twisted异步网络库,由引擎、调度器、下载器、爬虫及管道等组件协同工作,高效实现网页数据抓取。文章详细阐述了各组件职责,并提供了从创建项目到生成爬虫的完整命令示例,帮助开发者快速掌握这一强大爬虫工具的基础应用。
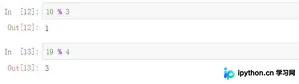
本文详细介绍Python中实现取余操作的方法,包括使用求模运算符(%)和divmod()函数。内容涵盖利用余数判断奇偶数、获取商与余数,并深入解析Python中//、int()及round()的取整规则,以及%运算符余数符号由被除数决定的特性,附带代码示例说明。
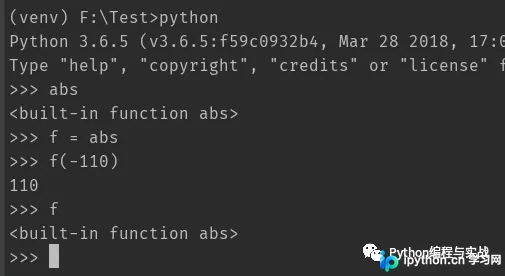
本文深入解析Python中的高阶函数概念,通过实例演示map、reduce和filter三大内置函数的具体用法。文章详细说明了如何将函数作为参数传递,并展示了如何利用map进行元素映射、reduce进行累积计算以及filter进行条件过滤,帮助开发者掌握Python函数式编程的核心技巧。
本文介绍Python中grequests模块的使用方法与适用场景。grequests基于requests和gevent实现异步并发请求,支持GET、POST等多种HTTP方法,常用于爬虫IP代理池验证及压力测试。文章提供基础用法、自定义返回结果修改源码示例以及事件钩子配置代码,帮助开发者高效处理批量网络请求。
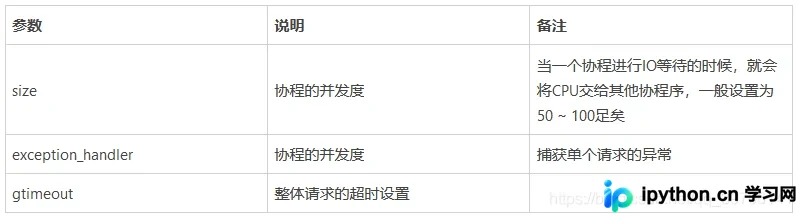
本文记录了一次Django项目内存耗尽的排查过程。通过对比频繁调用接口与复杂汇总接口,定位到问题根源在于对QuerySet使用if判断导致全量数据加载至内存。文章通过代码示例复现了该问题,并引用Django官方文档推荐改用exists()方法,以最小化数据库查询开销并避免内存溢出,同时强调了大数据量测试的重要性。
本文介绍在Python接口测试中获取手机短信验证码的方法。通过Android端注册BroadcastReceiver监听SMS_RECEIVED广播,解析短信内容,并利用Python脚本调用adb logcat命令实时抓取日志,提取验证码字符串。该方法适用于自动化测试场景,无需手动输入验证码,提升了测试效率与准确性。
本文详解Django项目中手动创建static文件夹并配置CSS资源的方法。涵盖从创建空文件夹、修改settings配置文件,到添加Bootstrap本地文件及在HTML模板中正确引用的完整步骤,帮助开发者解决静态资源加载问题。
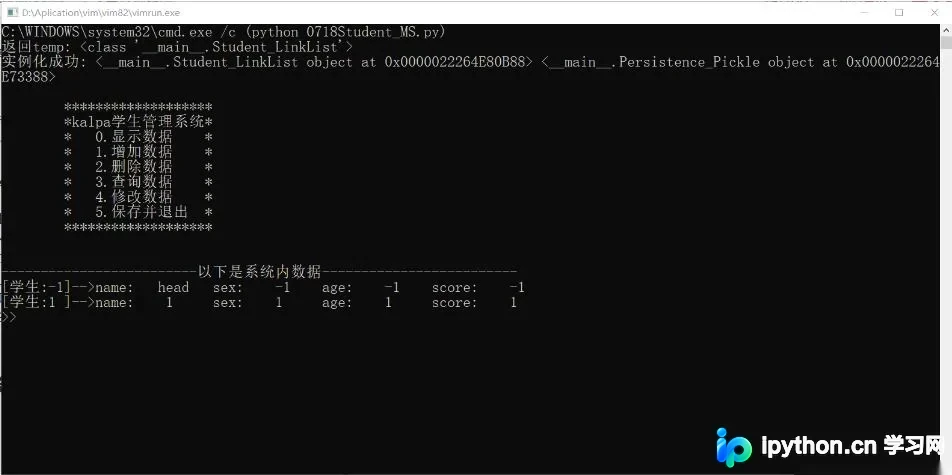
本文介绍使用Python实现学生管理系统的完整方案。系统采用单链表存储学生数据,通过Node类构建节点,利用Student_LinkList类管理链表操作。数据持久化借助pickle模块的dump和load方法实现文件存储,配置文件通过configparser解析Student.ini以动态加载子类。文章涵盖类关系设计、命令行交互界面及核心代码逻辑,适合Python初学者理解面向对象设计与数据管理。
本文深入解析NumPy的高级索引机制,涵盖整数数组索引、布尔索引及花式索引三大核心类型。通过具体代码示例,展示如何利用整数数组获取特定位置元素、使用布尔运算过滤数据(如NaN处理),以及通过np.ix_实现多维数组的复杂切片。掌握这些技巧可显著提升数据处理效率与灵活性。
本文详细介绍Python抓取指定网页图片的两种核心方法:基于正则表达式匹配URL与基于BeautifulSoup解析HTML标签。通过完整代码示例,演示如何获取网页源码、提取图片链接并保存至本地,同时提供优化建议,如结合两种方法提高抓取效率及添加请求头规避反爬机制。
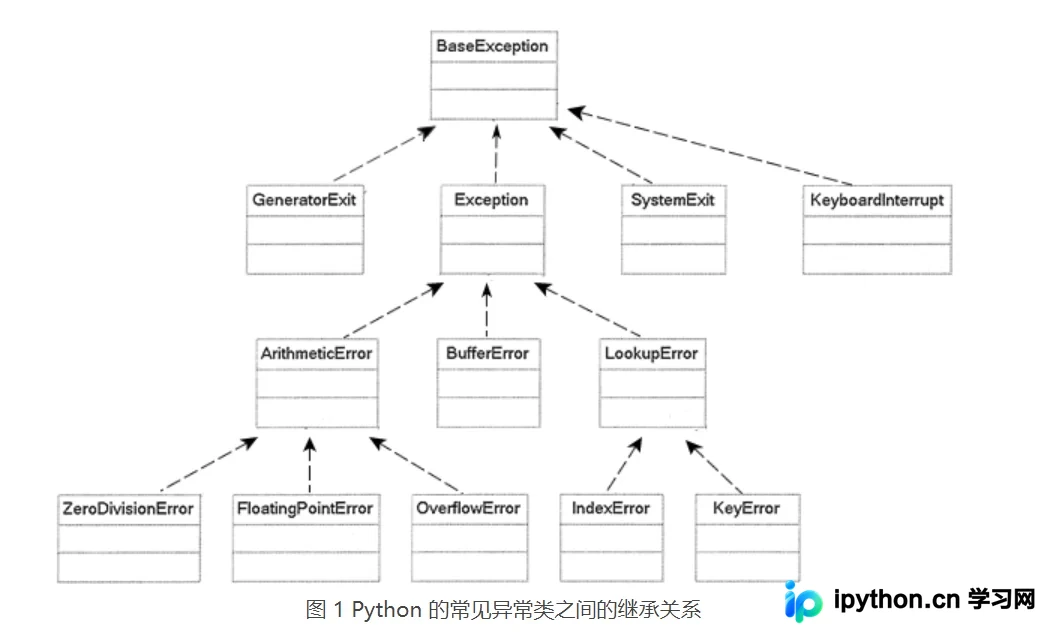
本文深入解析Python中try-except异常处理的底层逻辑,重点阐述Exception作为所有标准异常基类的继承关系。通过代码实例说明解释器如何根据异常类型匹配对应的except块,并强调处理所有异常的except块必须置于末尾且子类在前、父类在后的排序规则,帮助开发者编写更健壮的异常处理代码。
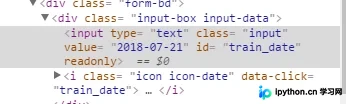
本文针对Selenium Python自动化测试中时间控件无法直接输入的问题,分析了存在与不存在readonly属性的两种情况。通过JavaScript移除readonly属性后,结合clear()清空与直接赋值value的方法,解决了input元素不可编辑导致的报错,提供了经过测试的完整封装流程。