一文读懂Python的对象模型与动态属性机制
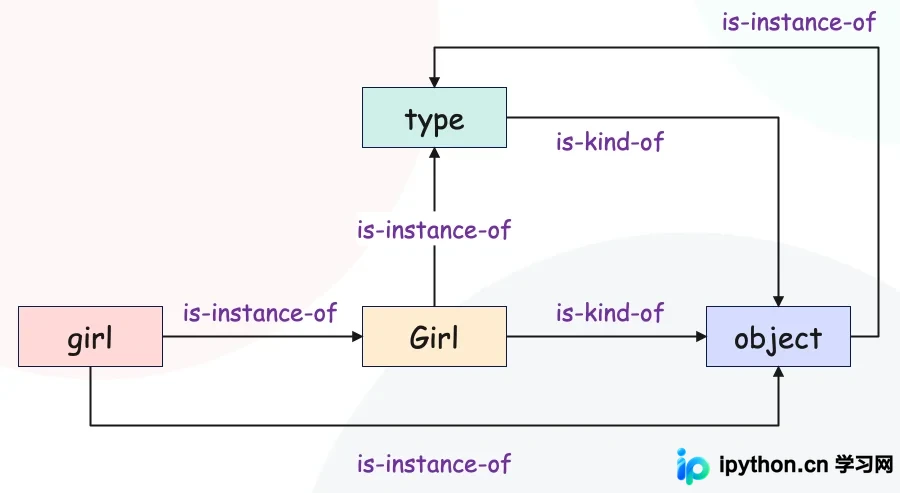
本文详细拆解 Python 面向对象的底层架构,明确内置类、自定义类与实例对象的划分逻辑,并通过 issubclass 等函数验证继承关系。同时解析 type 与 object 的元类循环机制,演示如何安全操作类属性字典,并阐明内置类型无法动态修改的底层原因。
2026-10-12
20

本文详细拆解 Python 面向对象的底层架构,明确内置类、自定义类与实例对象的划分逻辑,并通过 issubclass 等函数验证继承关系。同时解析 type 与 object 的元类循环机制,演示如何安全操作类属性字典,并阐明内置类型无法动态修改的底层原因。
在使用Pandas处理表格数据时,经常需要核对多列内容的异同。本文通过具体示例演示如何在Python中对比DataFrame的两列数据并生成比对结果。介绍自定义函数逐行判定与直接利用运算符进行向量化计算两种高效方案,附带完整代码与输出结果对照,帮助开发者快速完成数据校验与特征工程中的列匹配任务。
本文系统讲解Python中单星号(*)与双星号(**)的核心语法。涵盖其在数学计算中的基础定义,作为动态参数收集器捕获不定长位置与关键字参数,限制函数调用仅接受关键字传参的规范作用,以及结合列表、字典进行高效解包与扩展赋值的完整实操案例。
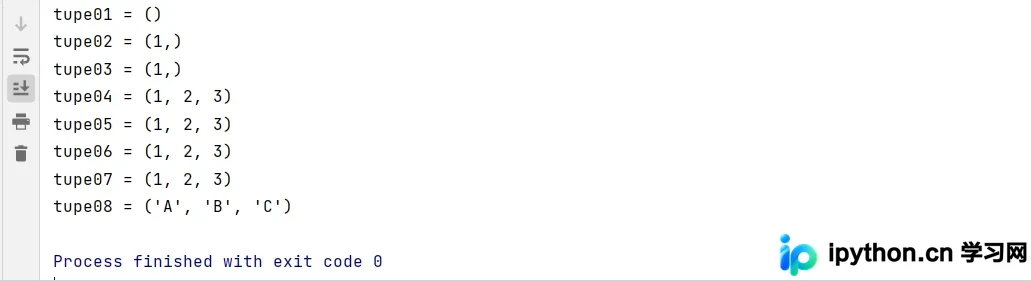
本文详细介绍Python中创建元组与字典的核心方法,涵盖直接使用括号与花括号定义、调用内置函数转换数据源,以及利用专用函数快速构建结构化数据。附带完整代码示例与运行结果对照,帮助开发者高效掌握基础数据结构初始化技巧。
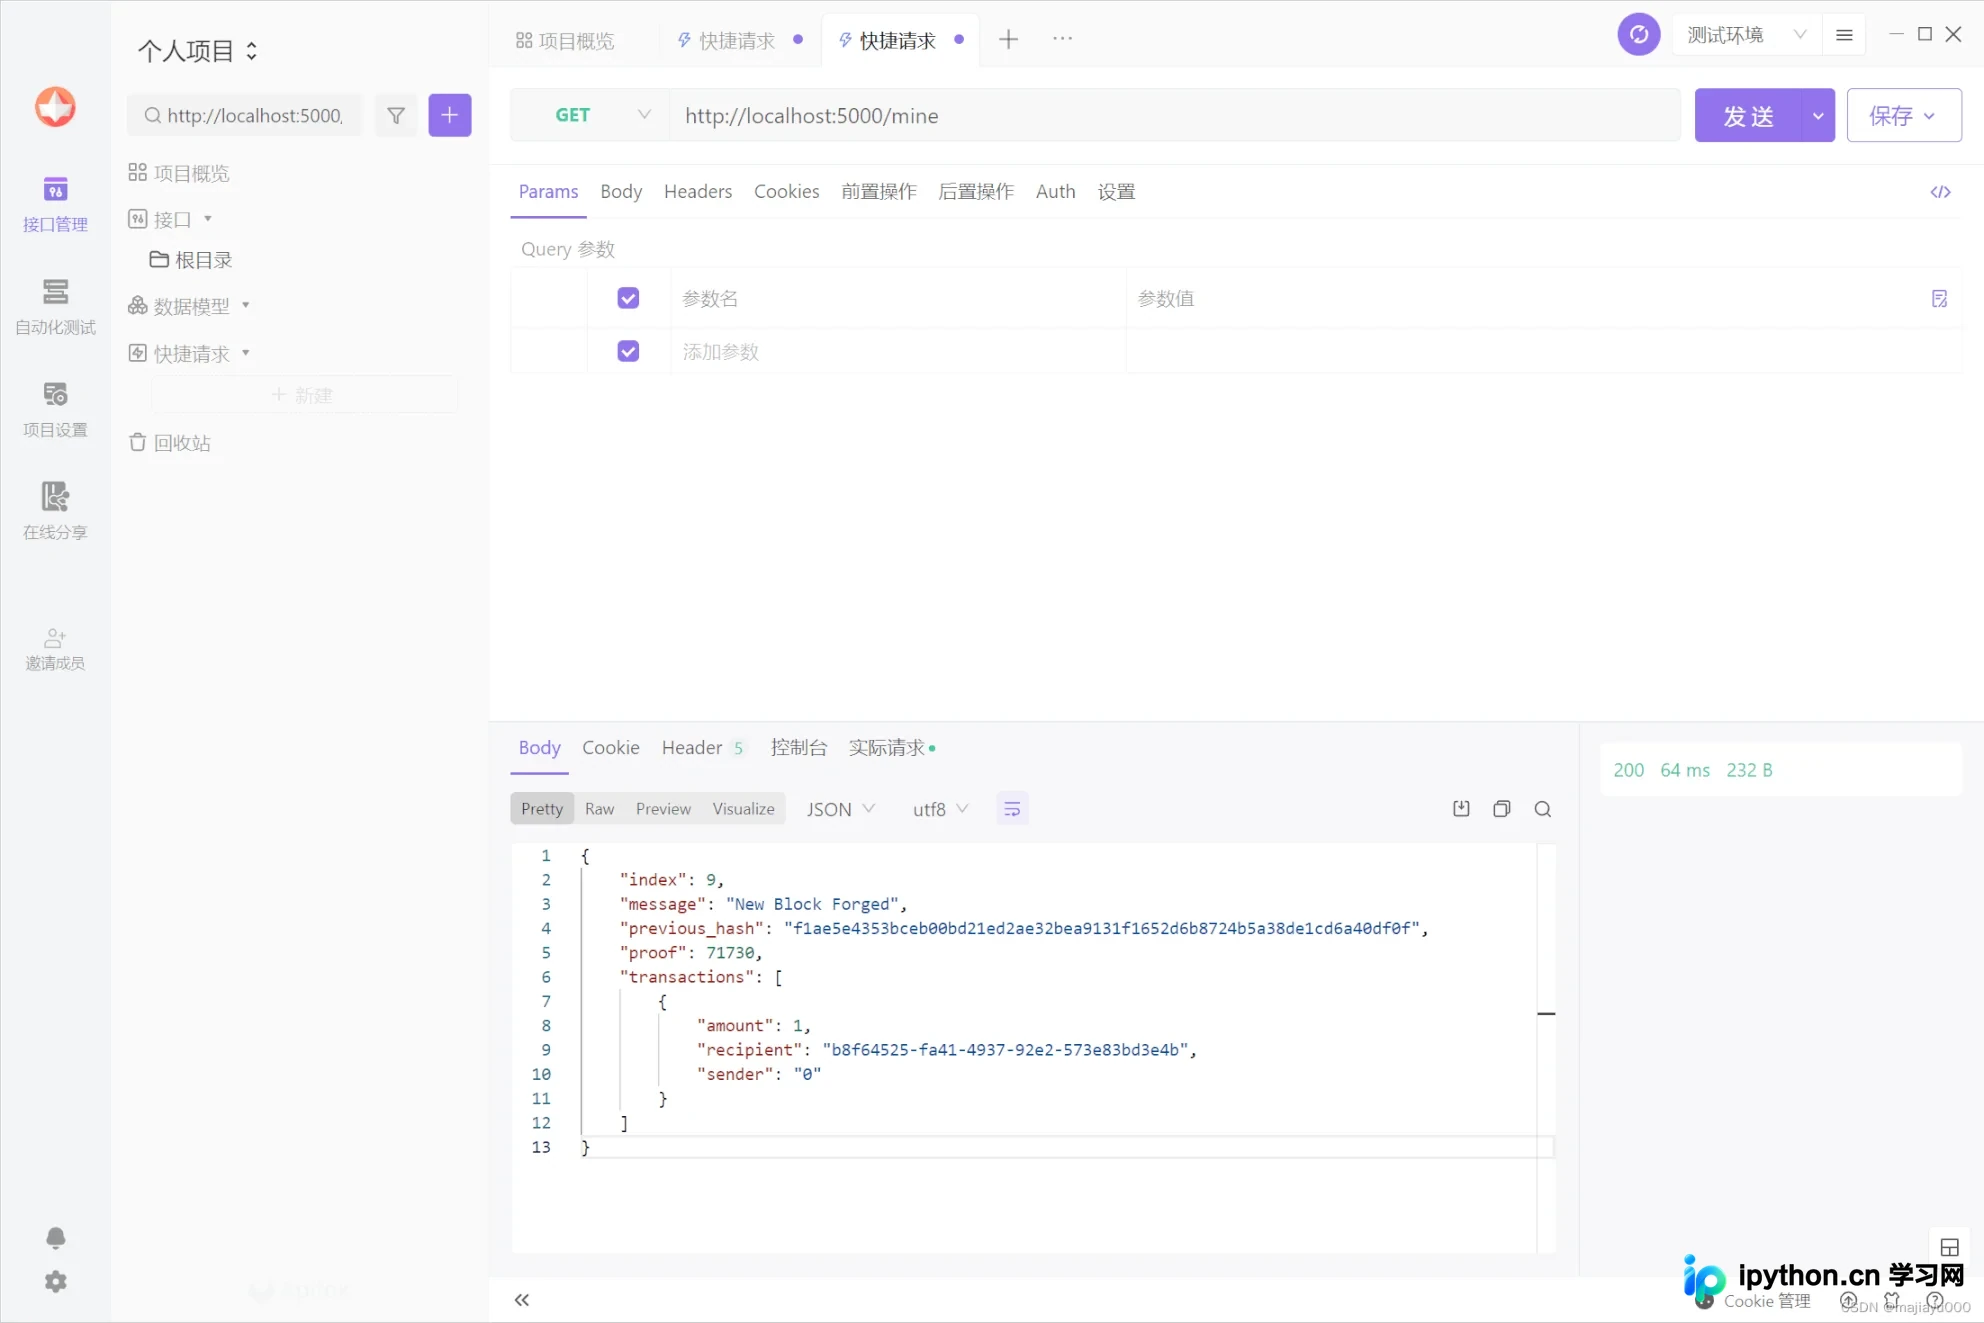
本文详解如何使用Python从零构建一个具备不可篡改特性的分布式账本。通过面向对象设计区块数据结构,实现基于SHA-256的工作量证明(PoW)挖矿算法,并利用Flask框架暴露RESTful接口。内容涵盖交易管理、创世区块初始化、节点注册、多链冲突检测及最长有效链共识机制,提供可直接运行的完整代码逻辑。
本文详细解析Python中__new__与__init__的作用差异、执行顺序及关键注意事项。通过对比标准写法与常见错误案例,说明如何通过重写__new__方法控制实例创建流程,并强调返回值对__init__触发的决定性影响,帮助开发者避免初始化失败问题。
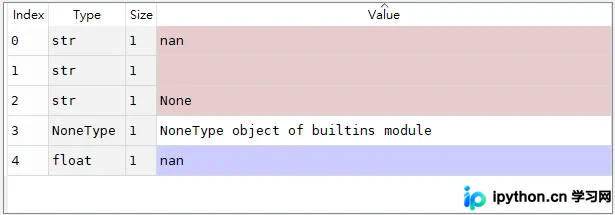
在NumPy数据处理流程中,NaN缺失值的判定存在明确的语法陷阱。直接使用等号比较或布尔条件会引发逻辑误判。本文系统梳理基于np.isnan()、身份运算符的标准验证方案,并结合Pandas内置函数演示如何高效过滤混合数据源,同时厘清None与空字符串的类型边界。
本文介绍如何使用Python的Pandas库读取CSV文件,通过sort_values函数对指定数值列进行排序,并结合Matplotlib生成排序前后的对比图表,帮助快速完成数据清洗与基础可视化。
针对分类模型排序质量的评估需求,本文详细解析ROC曲线与AUC指标的计算原理,提供基于Python与sklearn库的完整实现方案。通过导入鸢尾花数据集、执行标签二值化与One-vs-Rest策略训练线性SVM模型,代码可直接输出ROC曲线图及对应的AUC评分,帮助快速验证模型在不同阈值下的泛化性能。
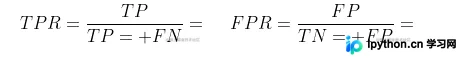
本文详细拆解使用Pandas批量合并多张Excel表格的标准流程,涵盖有序文件遍历与无序目录扫描两种代码实现。同步给出身份证号等超长数字截断乱码的精准修复方案,助力高效完成底层数据汇总。
在Python桌面程序开发中,动态调整下拉列表的显示内容是提升交互体验的关键。本文将详细介绍如何使用Tkinter的ttk模块创建下拉列表控件Combobox,并提供完整的代码示例,演示如何初始化选项、运行时动态更换数据、重置默认值,以及如何准确获取用户选中的内容。
面对Python代码运行缓慢或内存占用过高时,如何精准定位瓶颈?本文系统介绍time模块、%%time魔法命令、line_profiler与memory_profiler四种工具,分别提供基础耗时统计、Jupyter环境快速测算、逐行耗时分析及逐行内存监测的完整操作指南与参数配置,帮助开发者快速优化程序性能。